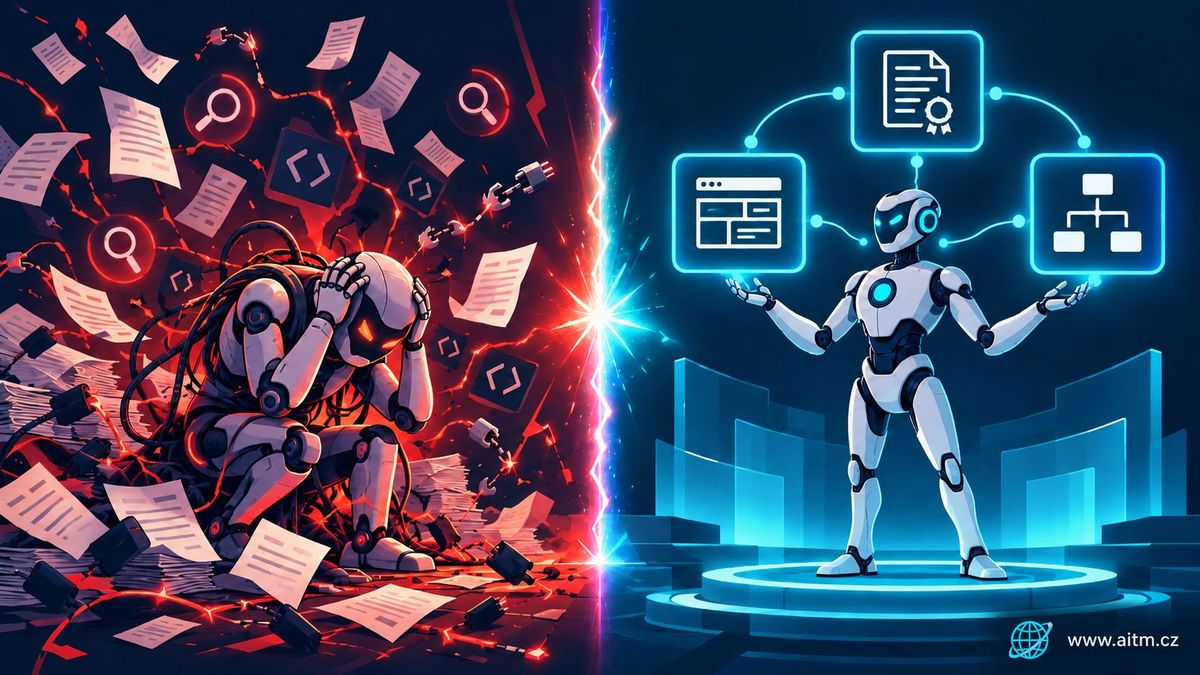
Die heutige KI kann in wenigen Sekunden eine Funktion, eine Komponente oder einen kompletten Endpoint schreiben. Das Problem zeigt sich nicht dort, wo man es erwartet – bei Syntax oder Geschwindigkeit. Es zeigt sich in dem Moment, in dem die KI ein bestehendes System anfassen muss: Dutzende Dateien, eine Geschichte von Entscheidungen, Geschäftsregeln, die nirgendwo aufgeschrieben sind außer „in den Köpfen“ der Entwickler. Wie sich dieses Problem systematisch verhindern lässt, ist das Thema dieser ganzen Serie – und das Werkzeug, zu dem wir nach und nach kommen, heißt AITM.
Bevor wir dort ankommen, lohnt sich eine Frage, die jedes Team, das mit KI-Agenten arbeitet, früher oder später beantwortet – entweder auf die einfache oder auf die teure Art: Woher weiß man eigentlich, dass das Ergebnis, das ein Agent als „fertig“ zurückgibt, wirklich korrekt ist und nicht nur so aussieht? Die Antwort folgt am Ende dieses Beitrags – aber zuerst sehen wir uns an, warum diese Frage gar nicht so selbstverständlich ist.
Wie das in der Praxis aussieht
Ein typisches Szenario: Man bittet einen KI-Agenten, eine Funktion zu ändern. Der Agent repariert sie – vergisst aber, dass diese Funktion von drei anderen Stellen mit unterschiedlichen Erwartungen aufgerufen wird. Oder er „verbessert“ die Struktur des Codes, weil ihm das logisch erschien, und zerstört dabei nachgelagerte Logik, die er nie zu Gesicht bekommen hat.
Das sind keine Einzelfehler, sondern ein systemisches Problem: Der KI-Agent hat nicht den Kontext des gesamten Systems, sondern nur das, was in den Prompt passt und was er per Volltextsuche lesen kann. Er entscheidet anhand von Wörtern, nicht anhand der Geschäftslogik. Steht Dokumentation zur Verfügung, lädt er oft den gesamten Inhalt – auch den Teil, der mit dem jeweiligen Prompt nichts zu tun hat. Und das gilt selbst für die stärksten verfügbaren Modelle (Opus, Fable, Astra und ähnliche): Es liegt nicht daran, dass das Modell nicht klug genug wäre, sondern daran, dass es dieses Wissen zwischen einzelnen Eingriffen nirgends systematisch ablegen kann.
Mit wachsender Zahl an Quellcodezeilen, komplexerer Geschäftslogik und stärker verflochtenen Modulen und Klassen wird diese Suche schlechter. Daten, die mit der Korrektur nichts zu tun haben, landen in der KI – und das Ergebnis ist Code, der technisch korrekt geschrieben ist, aber der falschen Geschäftslogik folgt. Die entstehende Funktionalität ist kaputt, oder es wird ein Stück Code „repariert“, das ohnehin niemand angefasst haben wollte.
Wo es genau hakt
Der grundlegende Stolperstein ist die Halluzination – und sie lässt sich nur sehr schwer ausmerzen. Das zweite Problem ist die Qualität des Prompts, die wir als Nutzer bereits teilweise beeinflussen können. Über beiden schwebt jedoch eine härtere Grenze: die Begrenzung des Kontexts. Selbst bei den größten verfügbaren Modellen reden wir von etwa einer Million Tokens – für Umgebungen mit Hunderttausenden Zeilen Code.
Nach Erfahrung liegt die praktische Schwelle, ab der Grundlagen wie ein Skill oder ein Hinweis in einer md-Datei nicht mehr genügen, grob bei etwa 150.000 Codezeilen. Bei rund 300.000 Zeilen wird die Umgebung wirklich komplex – der Alltagszustand beginnt zu zerfallen, und Dinge gehen von allein kaputt. Wir sprechen hier von Software auf Basis von OOP, mit komplizierten logischen Bedingungen und Teilen, die über Message-/Event-Mechanismen und ähnliche Techniken verbunden sind. In solchem Code ist die Referenz zwischen einem Aufruf und seiner Verarbeitung nicht immer offensichtlich, und die KI tut sich damit erheblich schwer – sie wird sehr wahrscheinlich nicht den gesamten Code finden, der an eine bestimmte Methode gebunden ist.
Hinzu kommt eine weitere Schicht: Der KI-Agent selbst erzeugt auf Basis des Prompts oft eigene Subagenten – und die Erzeugung dieser Subagenten liegt ihrerseits in der Hand der KI, was eine weitere Fehlerquelle einführt. Gewichtet die KI ein Wort höher, das man nur des Satzflusses wegen (nicht als Anweisung) eingefügt hat, kann sie auf Basis dieses Worts einen Subagenten erzeugen, der etwas verarbeitet, das man nie wollte. Und ein Subagent kann seine eigenen Fehler an andere Agenten weiterreichen – einzelne Halluzinationen können sich also durch die Kette fortpflanzen und aufschaukeln.
Es scheint, als müsste ein prüfender Agent, dessen Aufgabe es ist, die spezifikationsgemäße Erledigung zu verifizieren, das Problem lösen. Doch was bedeutet „verifizieren“ eigentlich? Bewertet eine andere KI die Aufgabe auf dieselbe Weise, wie sie bearbeitet wurde, erhält man nur die Bestätigung desselben Urteils, keine unabhängige Prüfung. Erst wenn für die Prüfung ein anderes und besseres LLM verwendet wird, steigt die Chance, den Fehler tatsächlich zu finden – aber das ist eine Entscheidung, die jemand bewusst treffen muss, und kein automatisches Ergebnis davon, dass „eine Prüfung stattgefunden hat“.
Es bleibt noch ein Weg: die Anwendung oder einen vorhandenen Test ausführen, den Fehler aus dem Log lesen und so beheben, dass der Test besteht. Auch hier bleibt aber die Frage, was tatsächlich behoben wurde – ist es wirklich ein Bug, oder ein Fehler, der durch eine Änderung der Geschäftslogik entstand, die ein früherer Schritt unbeabsichtigt vorgenommen hat? Die Korrektur selbst ist meist eindeutig und der Fehler verschwindet, aber dabei geht oft ein anderer Teil des Codes kaputt. Vieles hängt davon ab, wie komplex der Code ist und welche Abhängigkeiten er hat.
Bei einfacheren Dingen – etwa einem Webformular mit Bearbeitung, Validierung nach dem Ausfüllen und Speichern der Daten über Geschäftslogik – ist das meist unkompliziert, und die Erfolgswahrscheinlichkeit liegt nahe bei 99 %. Bei komplexeren Strukturen kann man tatsächlich in einen Zustand geraten, in dem die Struktur des Codes zerfällt und ein Bug auf den nächsten folgt. Wiederholtes Ausführen von Tests und E2E-Tests kann das nach und nach beheben, aber bei einem wirklich komplexen System kann es viele Versuche dauern – und jeder kostet etwas.
Die Antwort, die wir am Anfang versprochen haben
Zurück zur Eingangsfrage: Woher weiß man, dass ein Ergebnis tatsächlich korrekt ist und nicht nur fertig aussieht? Allein aus dem Prompt und der anschließenden Prüfung lässt sich das nicht verlässlich sagen. Wir haben gesehen, warum: begrenzter Kontext, Halluzinationen, die sich zwischen Subagenten fortpflanzen, eine Prüfung, die im schlimmsten Fall nur denselben Fehler bestätigt, und eine logbasierte Korrektur, die einen echten Bug nicht von einem Nebeneffekt unterscheiden kann.
Das sind die Methoden, die Programmierer heute üblicherweise einsetzen, und für einfachere Änderungen funktionieren sie gut. Die nächste Stufe ist die Orchestrierung mit Hilfe von KI – man bereitet bestimmte Daten über das System vor und hält sie aktuell, um der KI bessere Informationen zu geben und damit den Spielraum zu verkleinern, etwas anderes zu tun als das Gewünschte. Genau dafür wurde AITM – AI Task Manager gebaut: Bevor der Agent, der den Code schreibt, die Anfrage überhaupt erhält, zieht das System Contracts (dokumentiertes Verhalten), eine DOM-Map und die Geschäftslogik für den jeweiligen Bereich hinzu – und stellt erst dann, mit diesem Wissen, die Aufgabe zusammen. Es verlässt sich nicht auf einen einzelnen Agenten, sondern auf eine ganze Pipeline und weitere Methoden, mit denen AITM bessere Ergebnisse erzielt.
Die folgenden Tage zeigen genau, wie das in AITM an konkreten Prompts, Agenten und Pipeline-Schritten aussieht – und warum das eine andere Arbeitsweise mit KI ist als die, die Programmierer von einer einfachen Konsole gewohnt sind.