Dostarczanie kodu z AI wymaga dyscypliny
Bez odpowiedniej konfiguracji kodowanie z AI niesie realne ryzyko: jak skonfigurować AI i jej agentów, by nigdy nie psuli logiki i struktury, które już działają? Pipeline AITM jest zbudowany wokół dokładnie tego problemu.
Jakość promptu i mniejsze kroki
Im precyzyjniej opisany jest wymóg, tym lepiej AI go wykonuje. Dzielenie pracy na mniejsze, niezależnie weryfikowane części konsekwentnie bije jeden gigantyczny prompt.
Mniej halucynacji
Zwykły agent AI ma skłonność wybierać odpowiedź brzmiącą najbliżej, zamiast tej, której biznes naprawdę potrzebuje. Wstrzykiwanie logiki biznesowej i jawnych ograniczeń czego nie wolno zepsuć do promptu, a nie tylko testowanie po fakcie, trzyma ją na kursie.
Weryfikacja, która ogranicza zasięg skutków
Testy jednostkowe, integracyjne i end-to-end dowodzą, że zmiana niczego nie zepsuła poza własnym zadaniem.
Kontekst, zanim zmieni się choć jedna linia
Krok Architect czyta kontrakty, elementy DOM i łańcuchy zachowań przed rozpoczęciem kodowania, więc wygenerowany prompt jest dopasowany tak, by omijać miejsca, które nie mogą się zmienić, a każde zadanie (Bug, Feature lub Enhancement) jest z założenia weryfikowane inaczej, odpowiednio do rodzaju ryzyka, jakie niesie.
AITM jest używany przez zespoły programistyczne i samodzielnych programistów, którzy chcą przekazać rutynowe kodowanie agentom AI, sami koncentrując się na architekturze i decyzjach. Rozwiązuje chaos równoległych zadań, utraty kontekstu między rozmowami i konieczności ręcznego przeglądania każdej zmiany w kodzie. Potrzebują narzędzia, które gwarantuje izolację worktree, automatyczne testy i audytowalną historię, bez poświęcania tempa rozwoju. AITM daje im pewność, że kod wygenerowany przez AI przechodzi tę samą dyscyplinę co kod pisany przez ludzi, oszczędzając godziny każdego dnia.
 Od promptu do scalonego kodu: w pełni zautomatyzowane
Submit a Task.
Ship Tested, Merged Code.
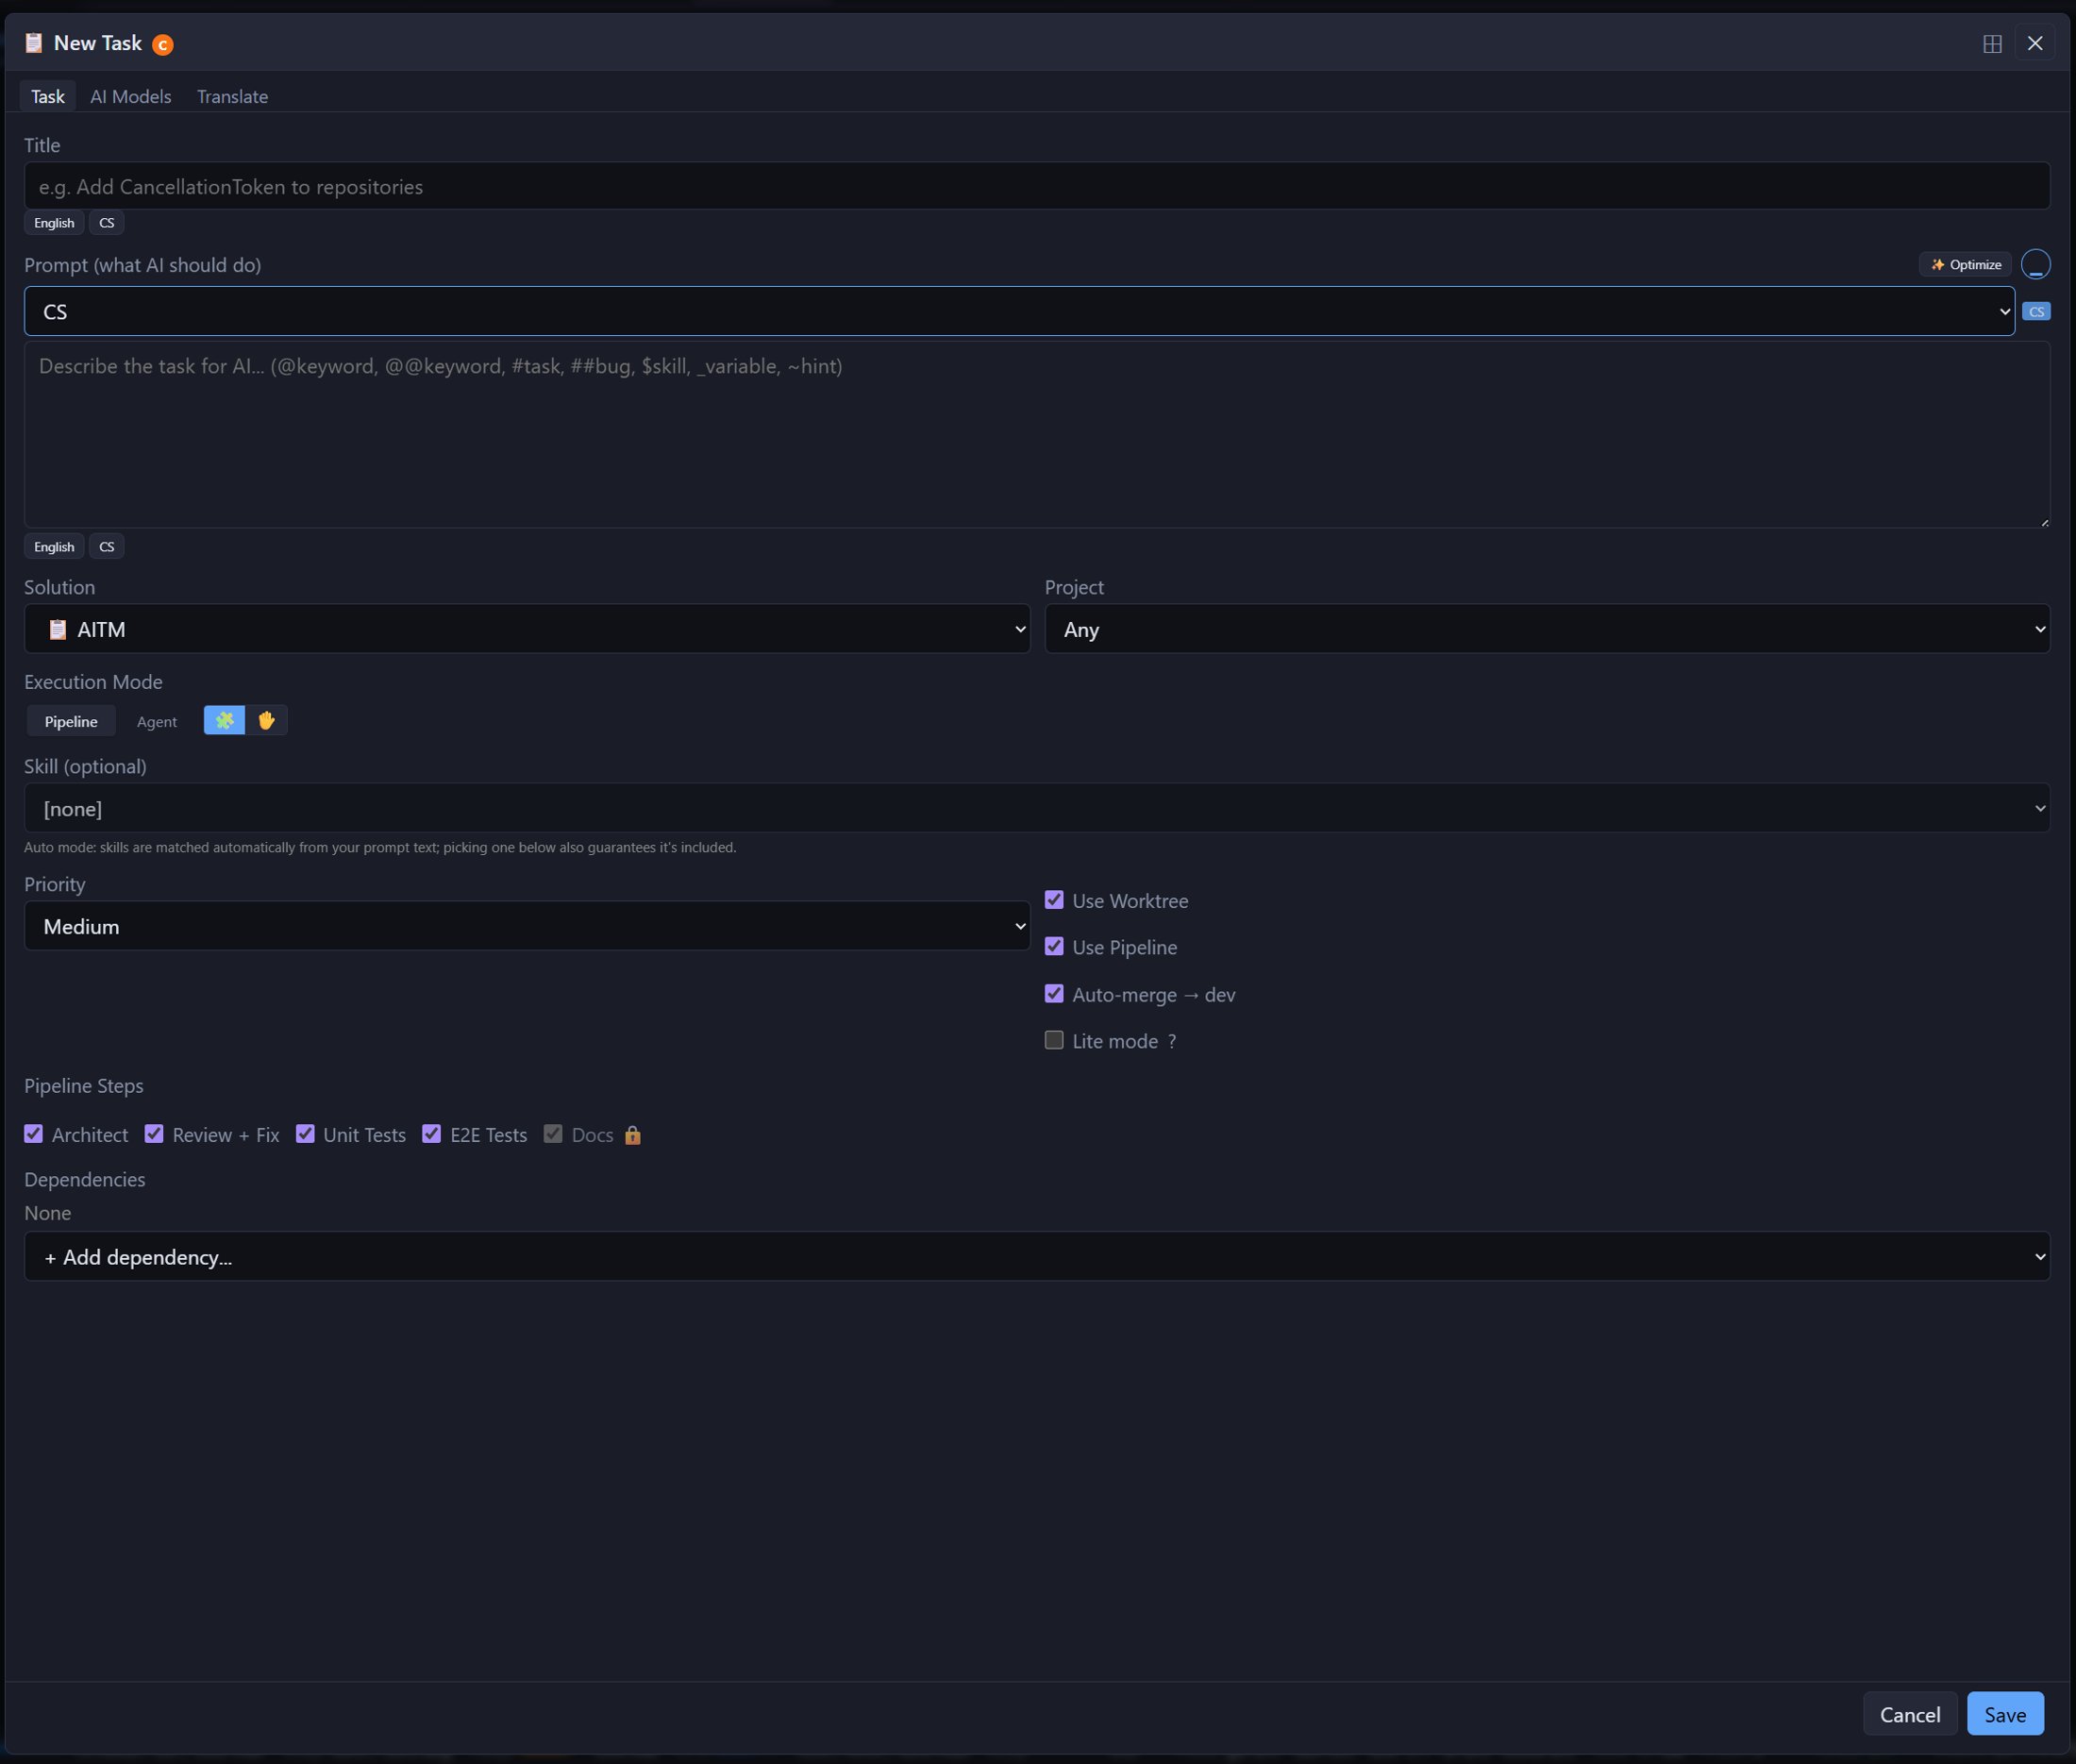
Describe what you need once. AITM designs the approach, writes the code, reviews it, fixes what's broken, tests it end-to-end, updates the docs, and merges it into your dev integration branch — without you touching a keyboard again until it's done.
 v1.0.0 dostępna już teraz
Zobacz AITaskManager w akcji
Kliknij dowolną kartę, aby przeglądać. Kliknij obraz, aby powiększyć.
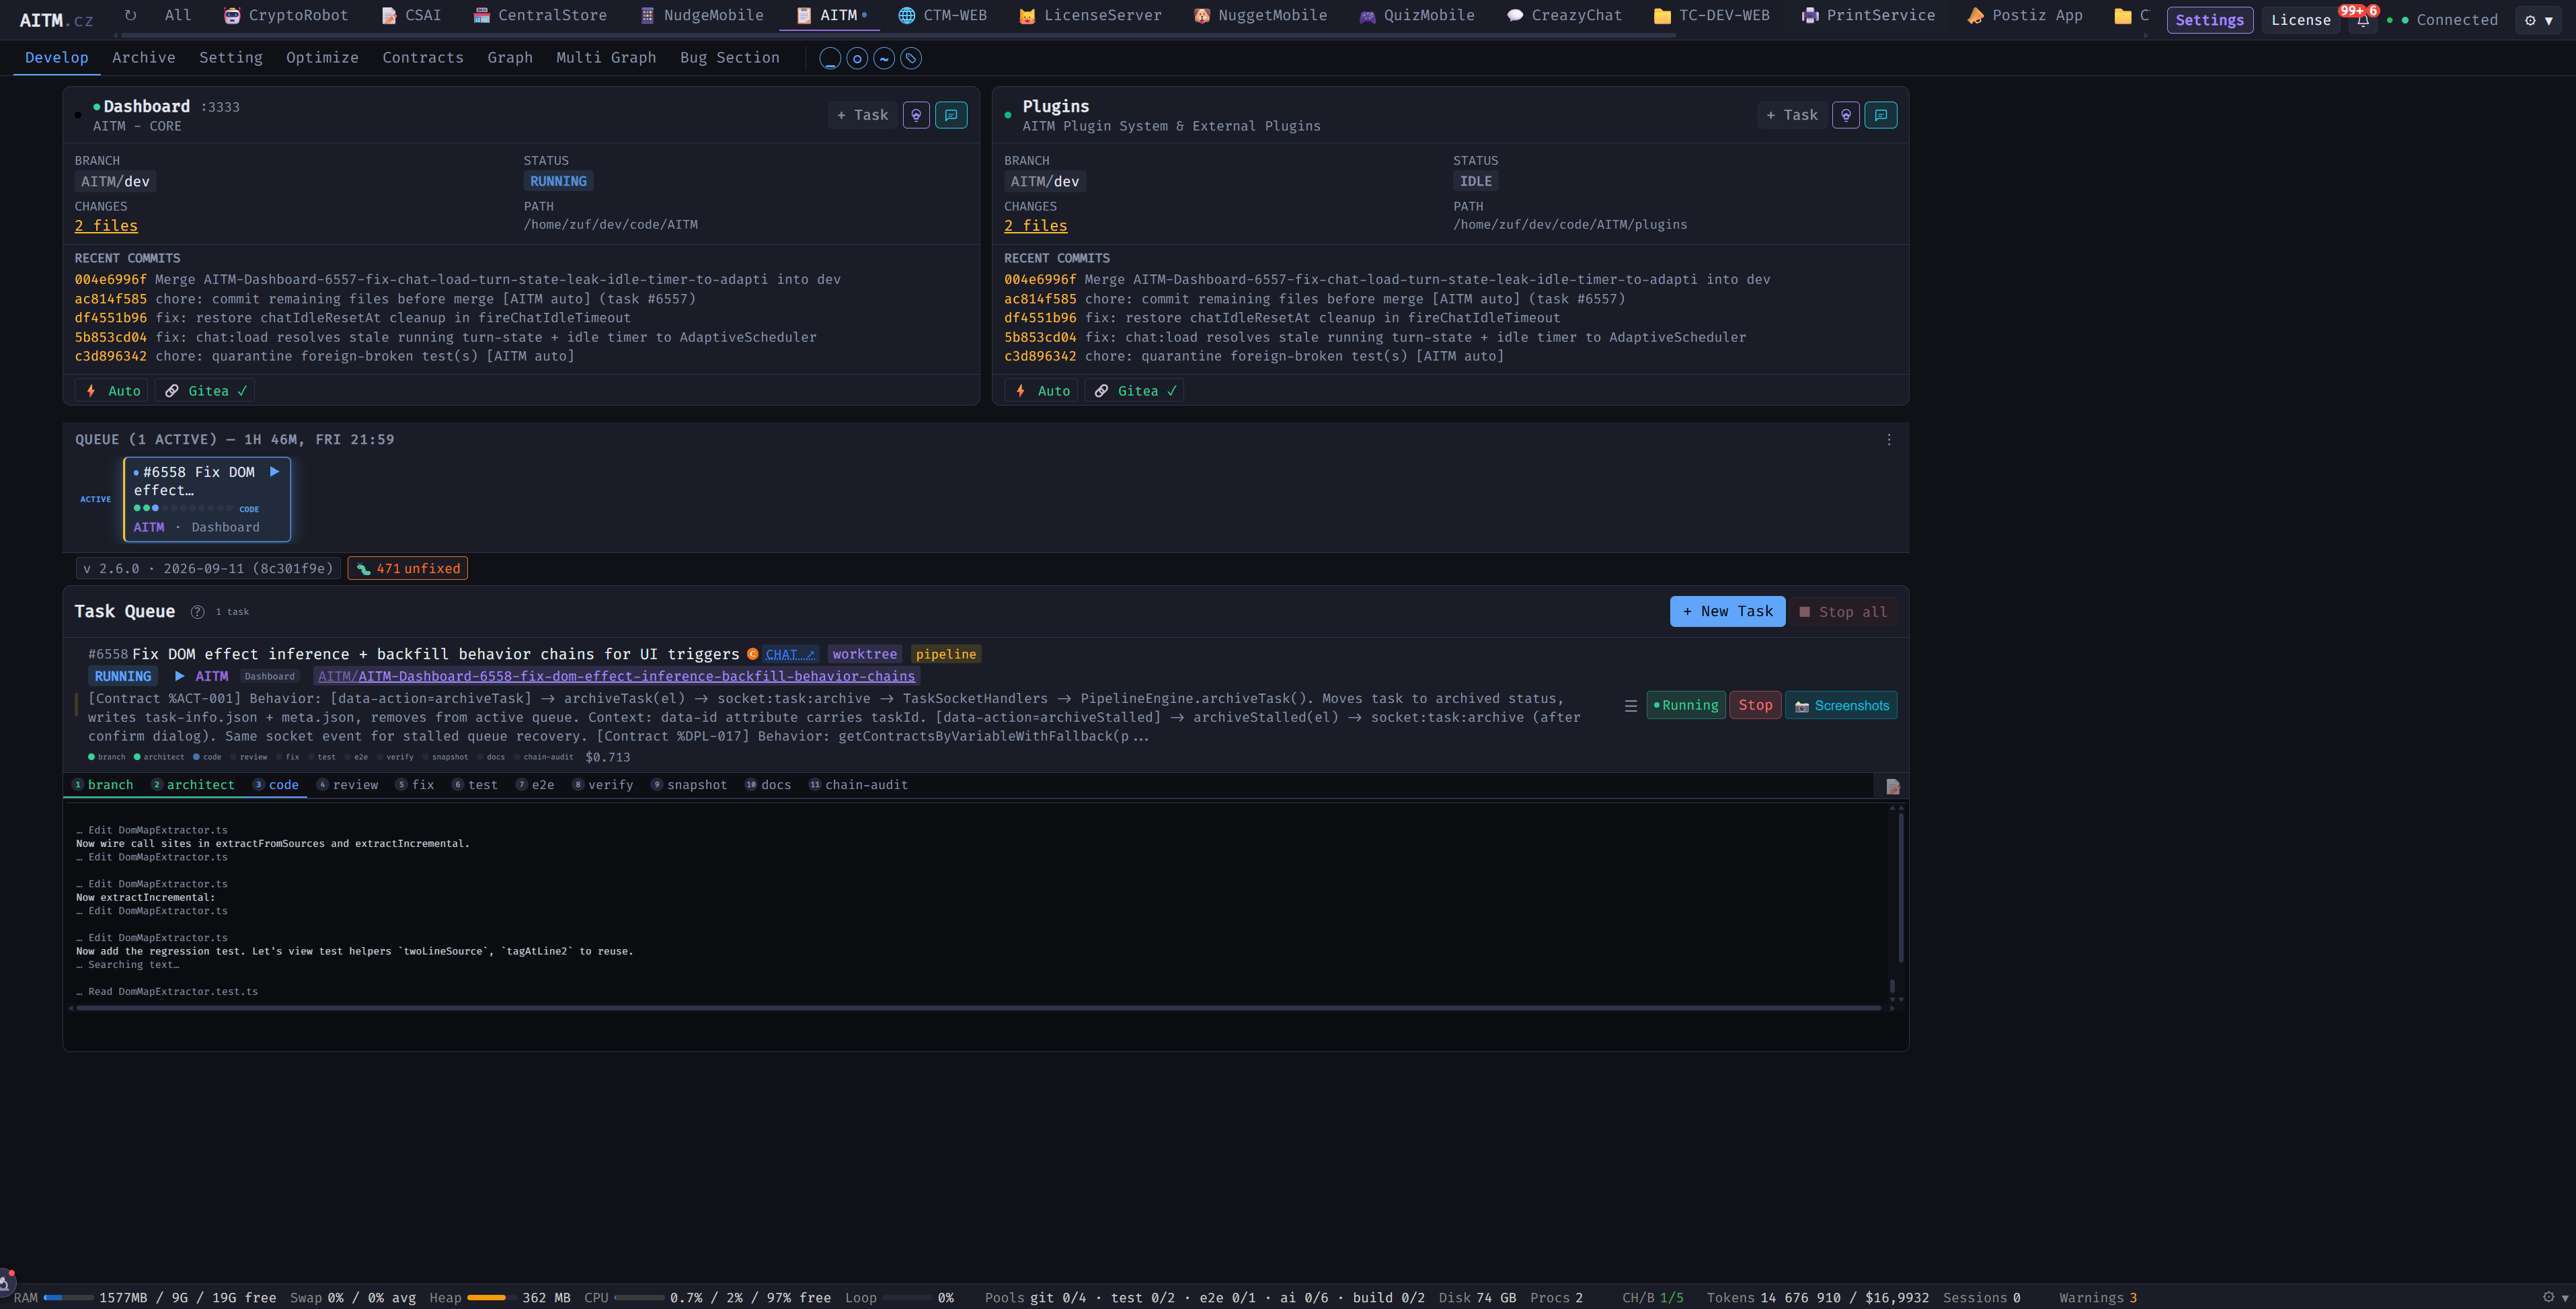
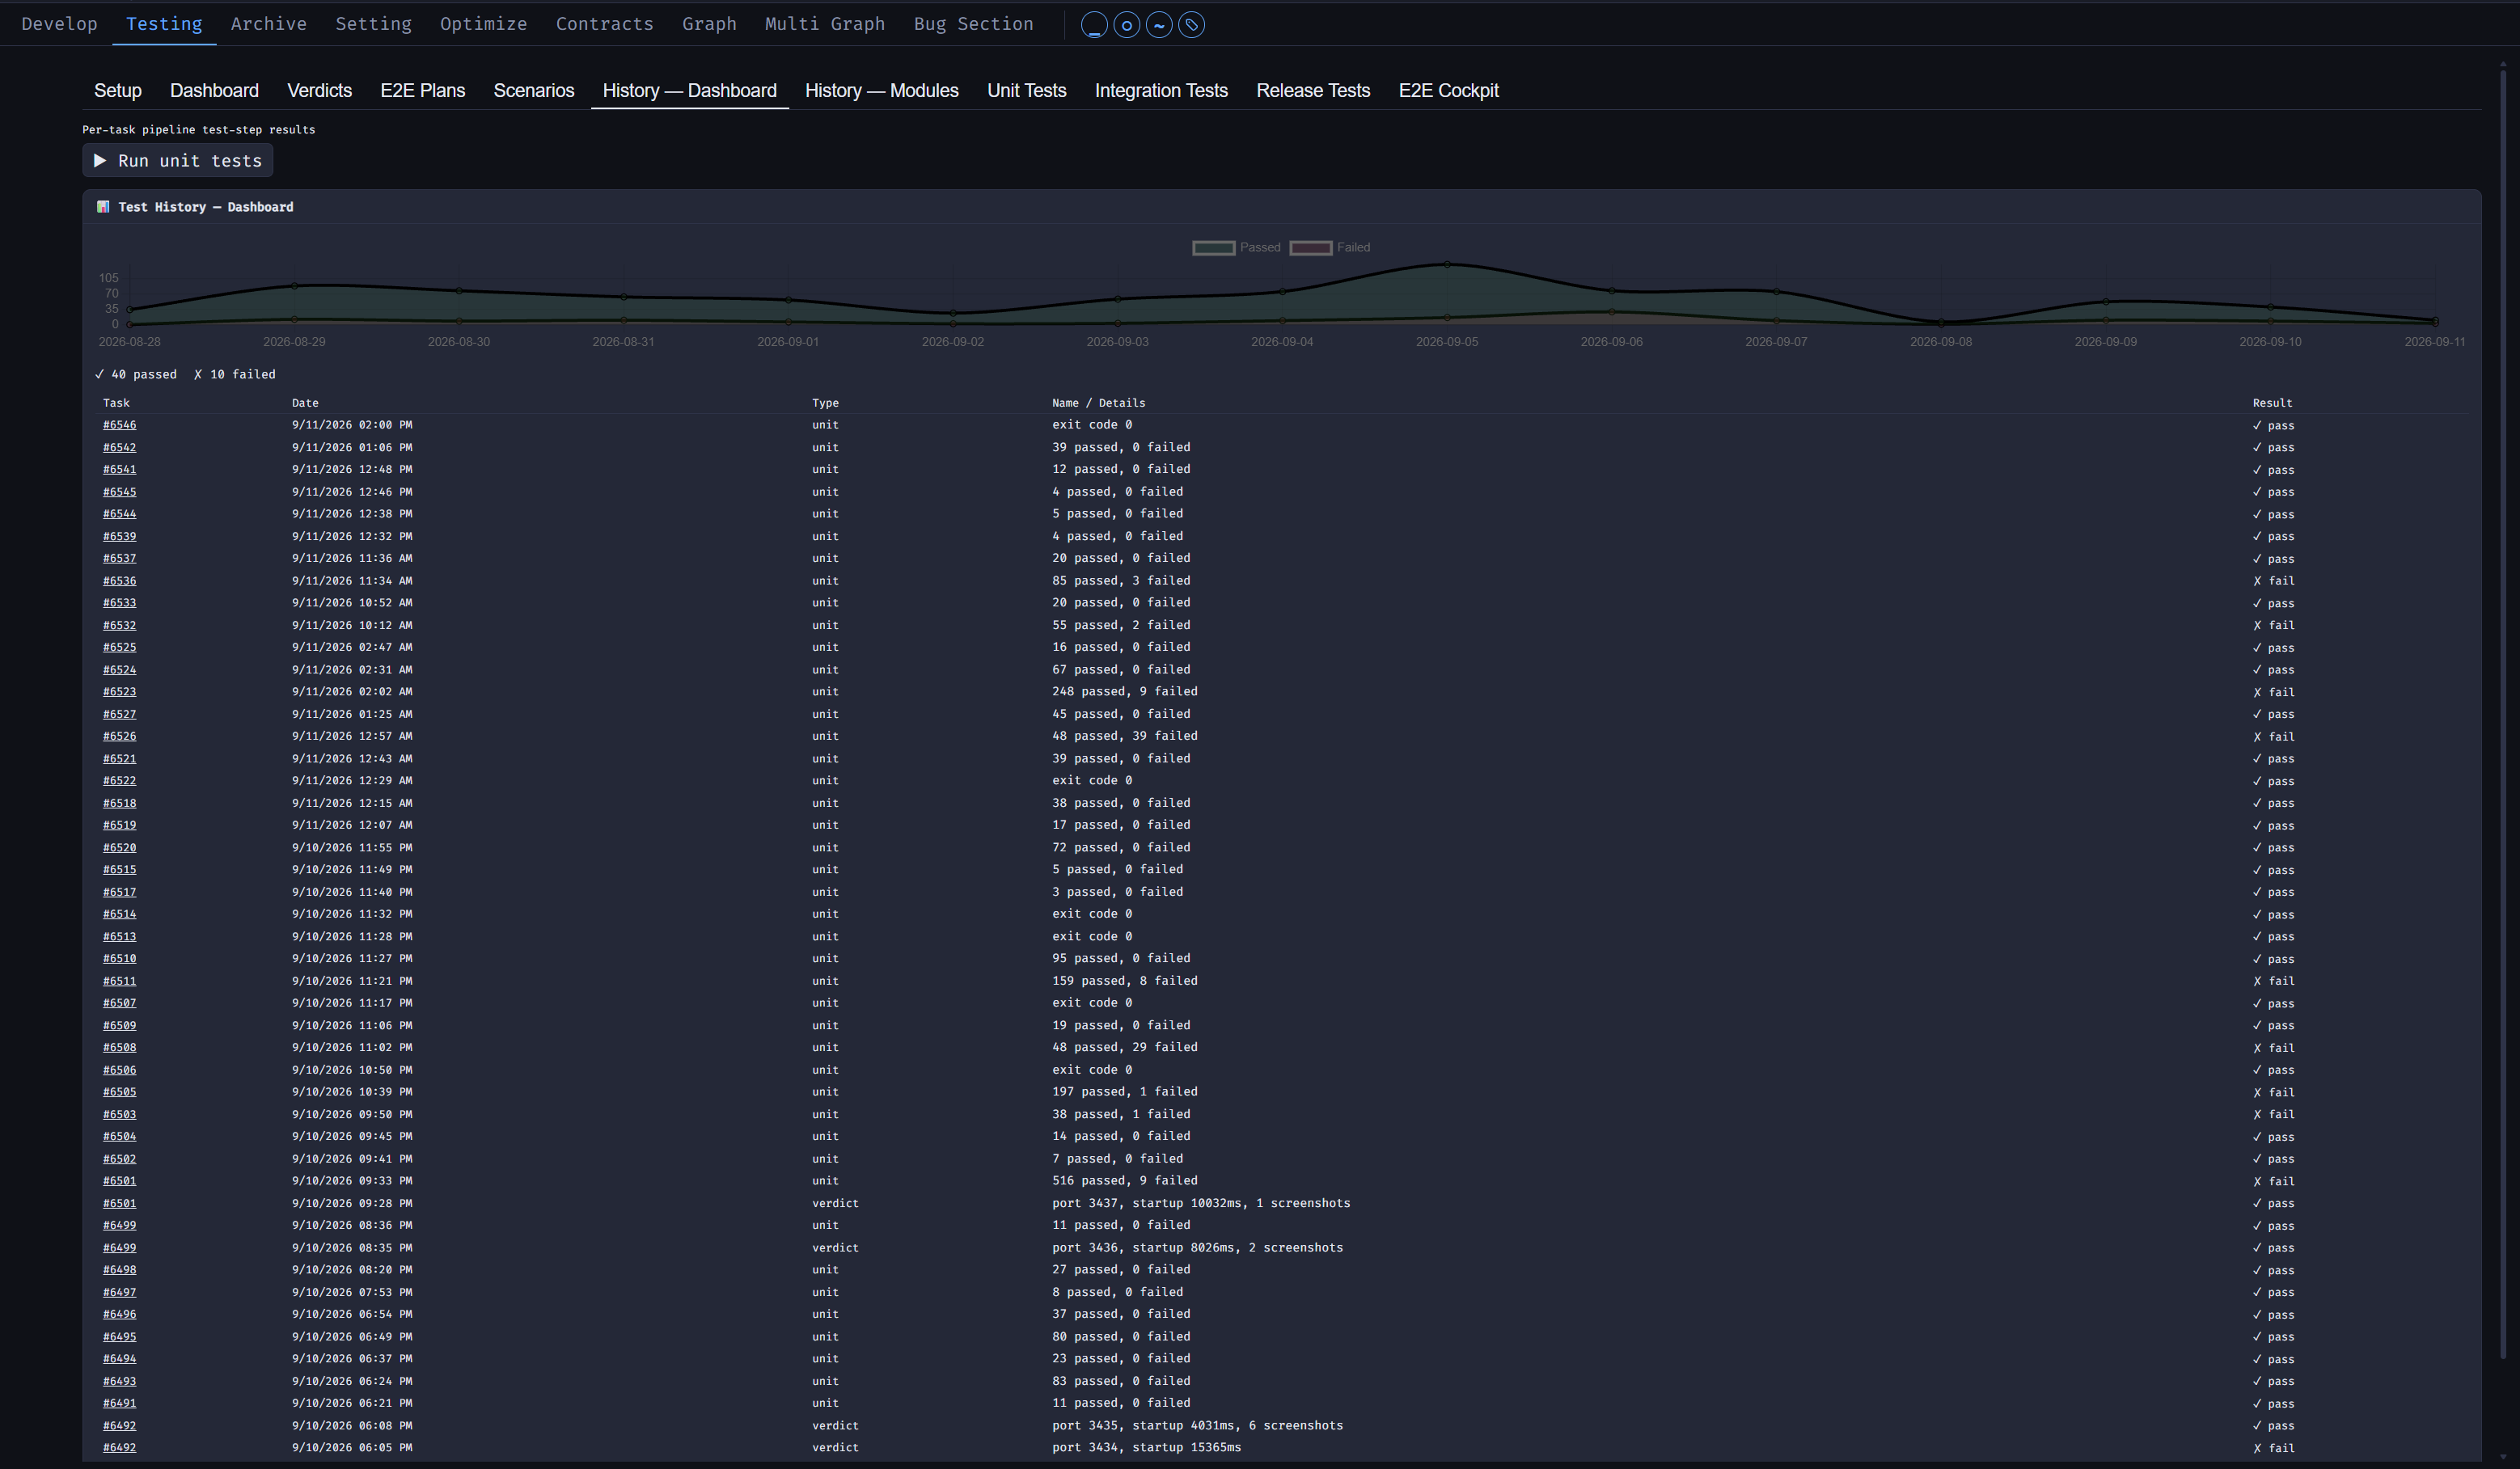
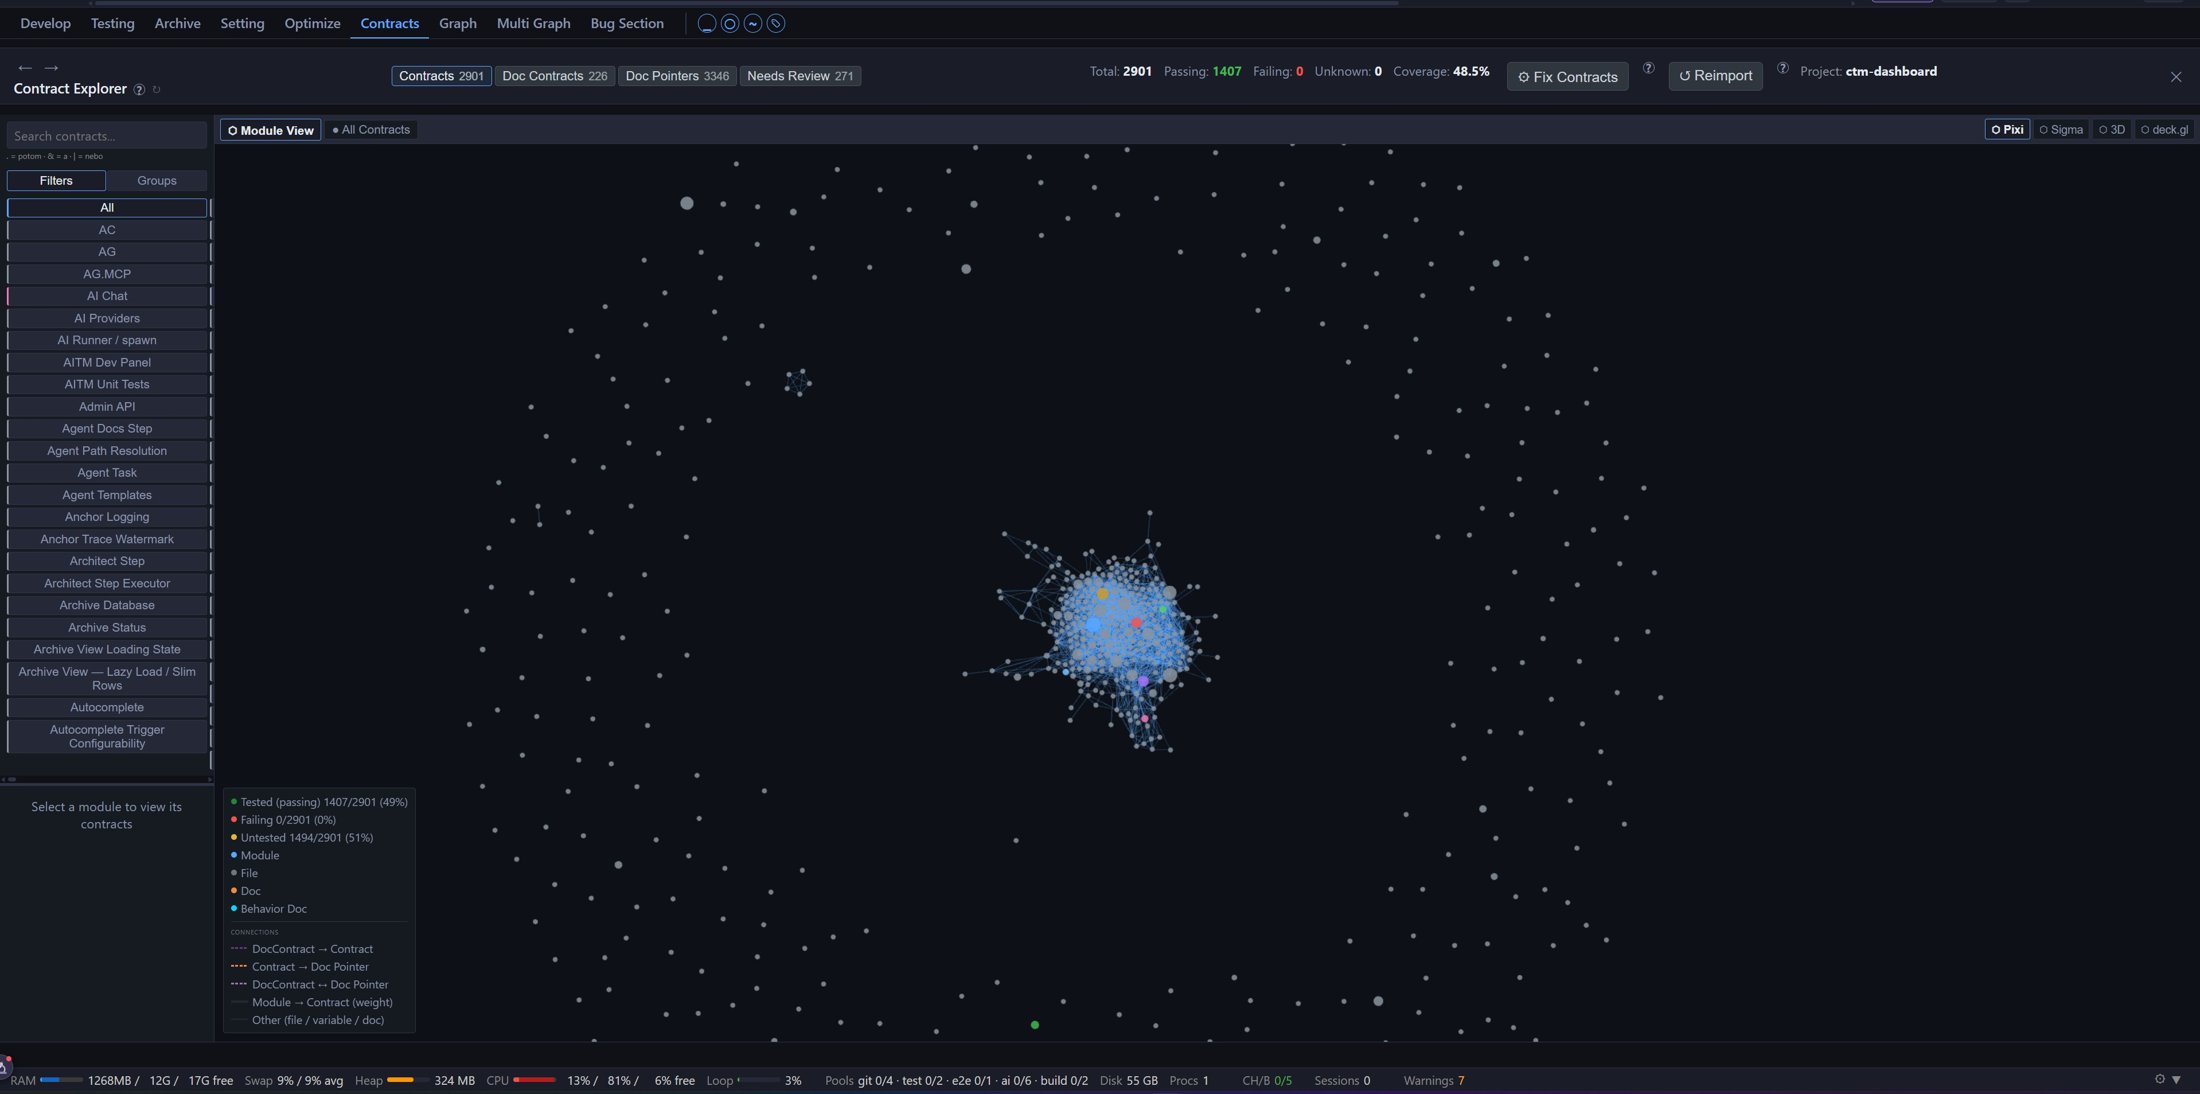
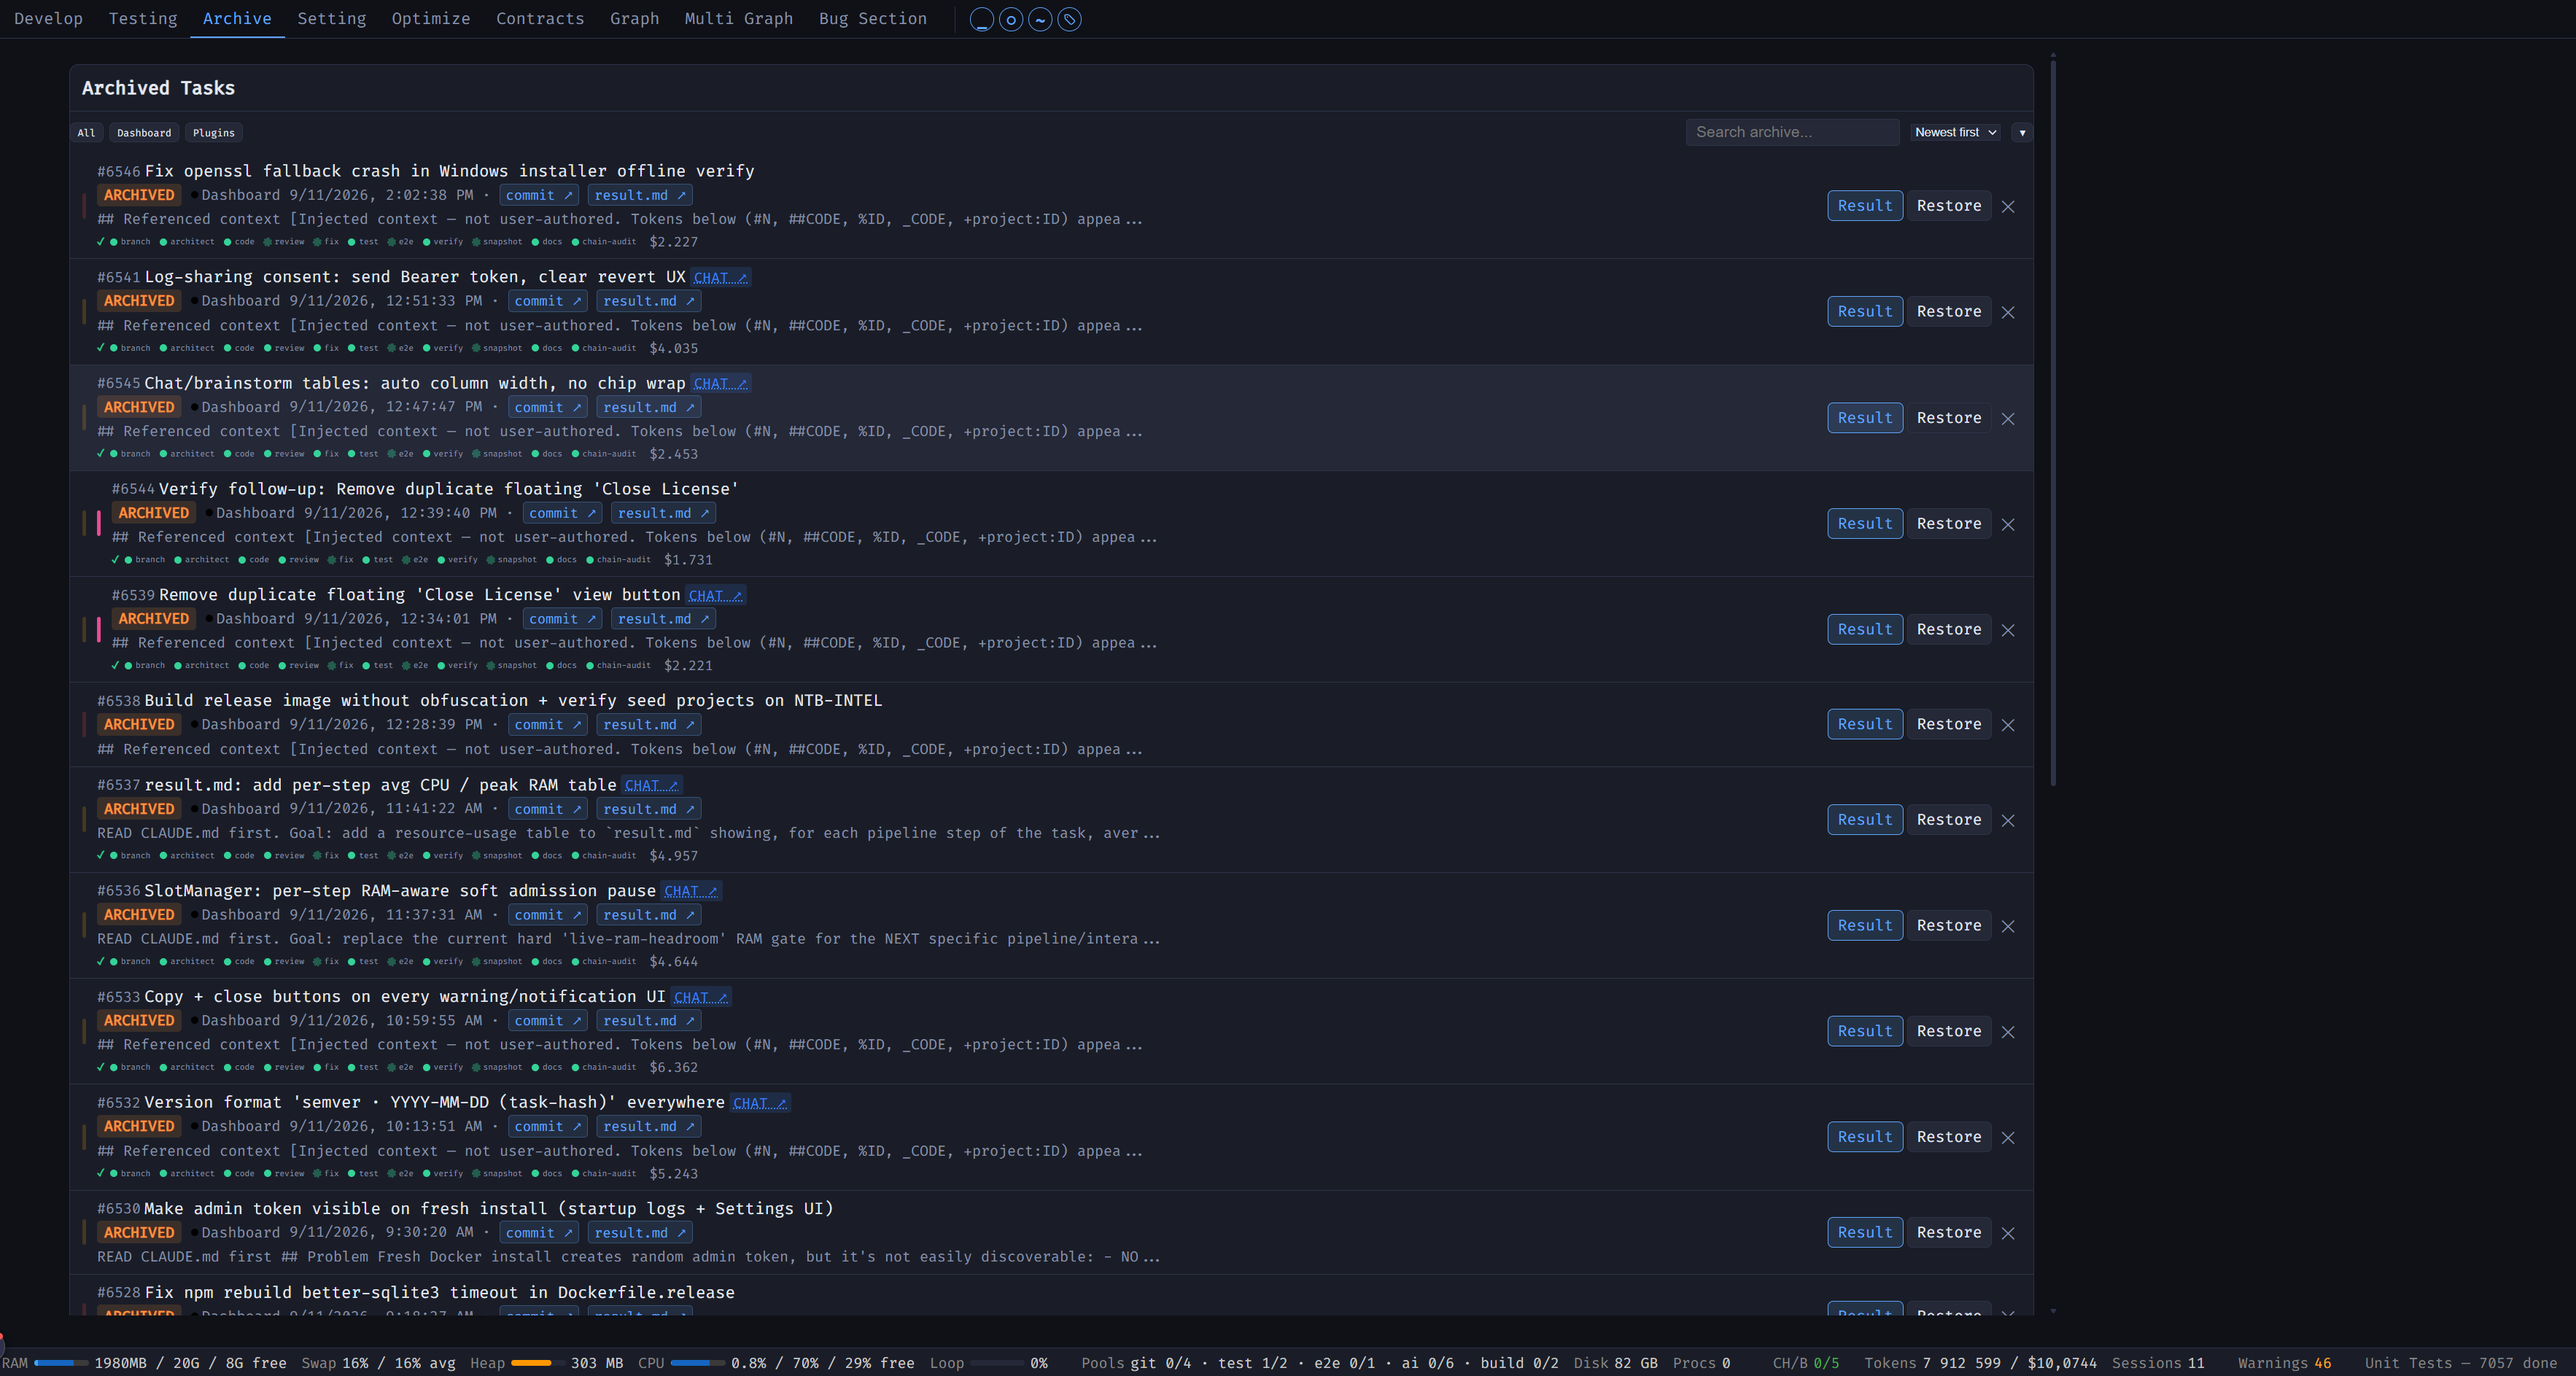
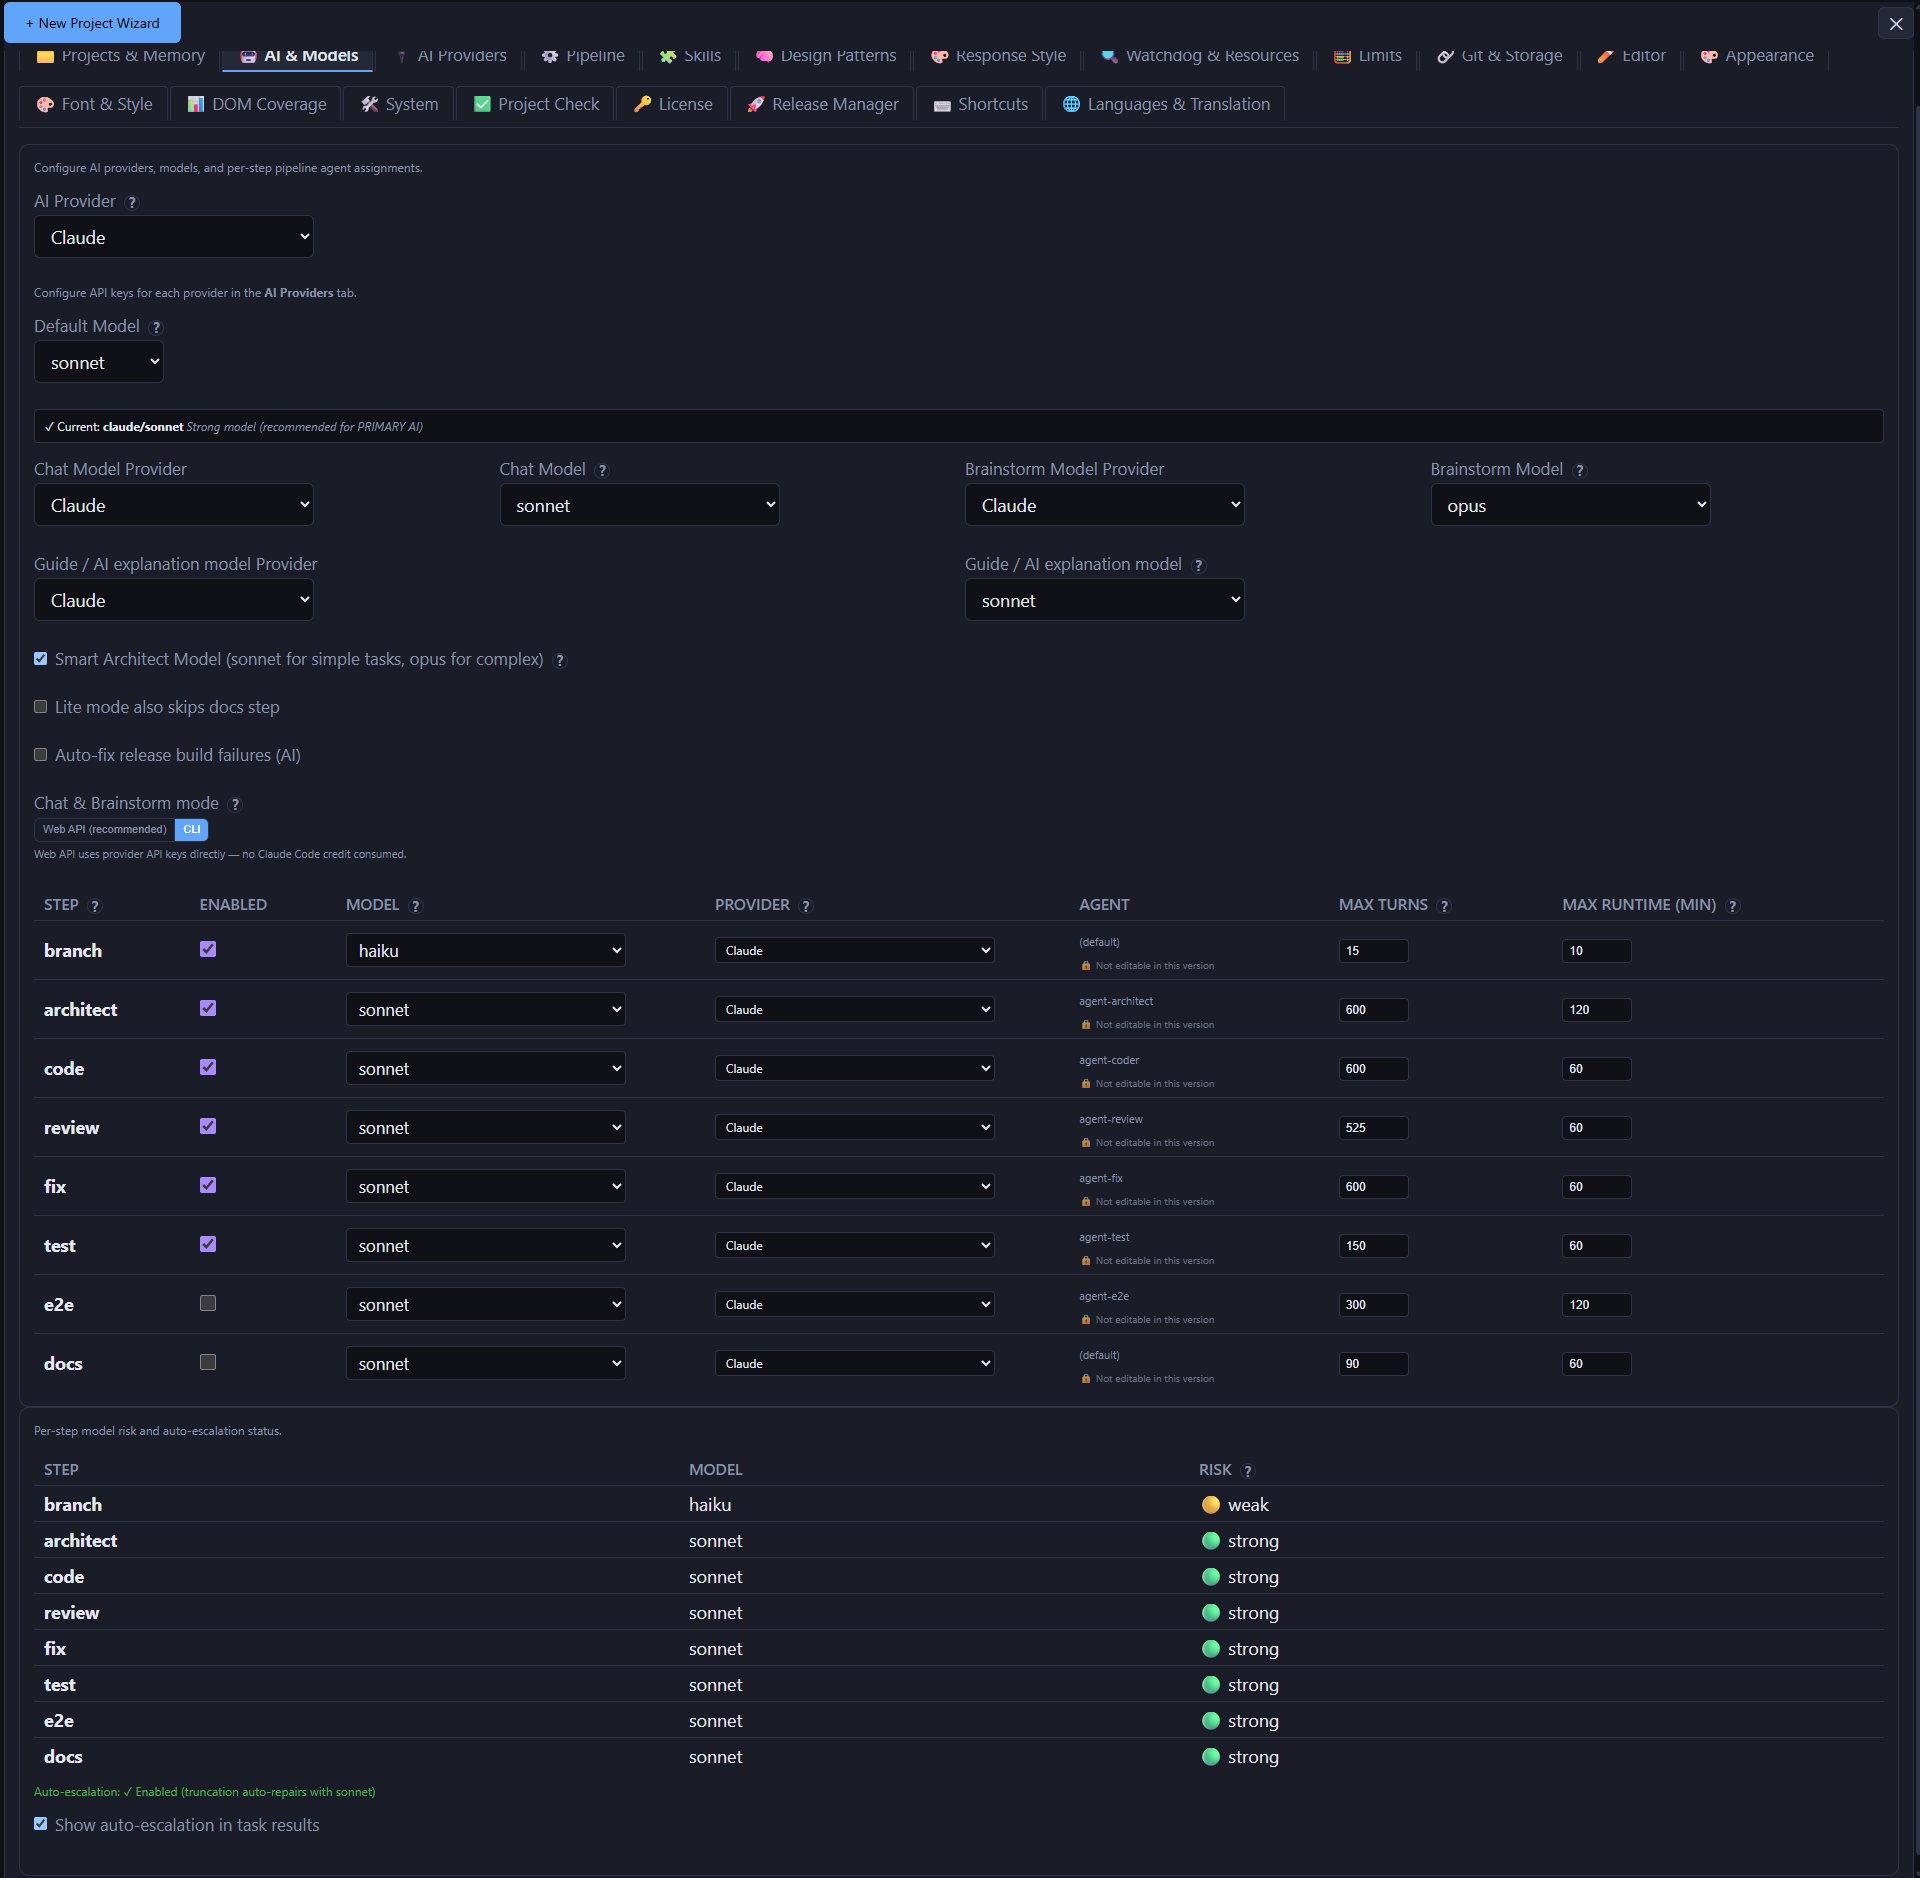
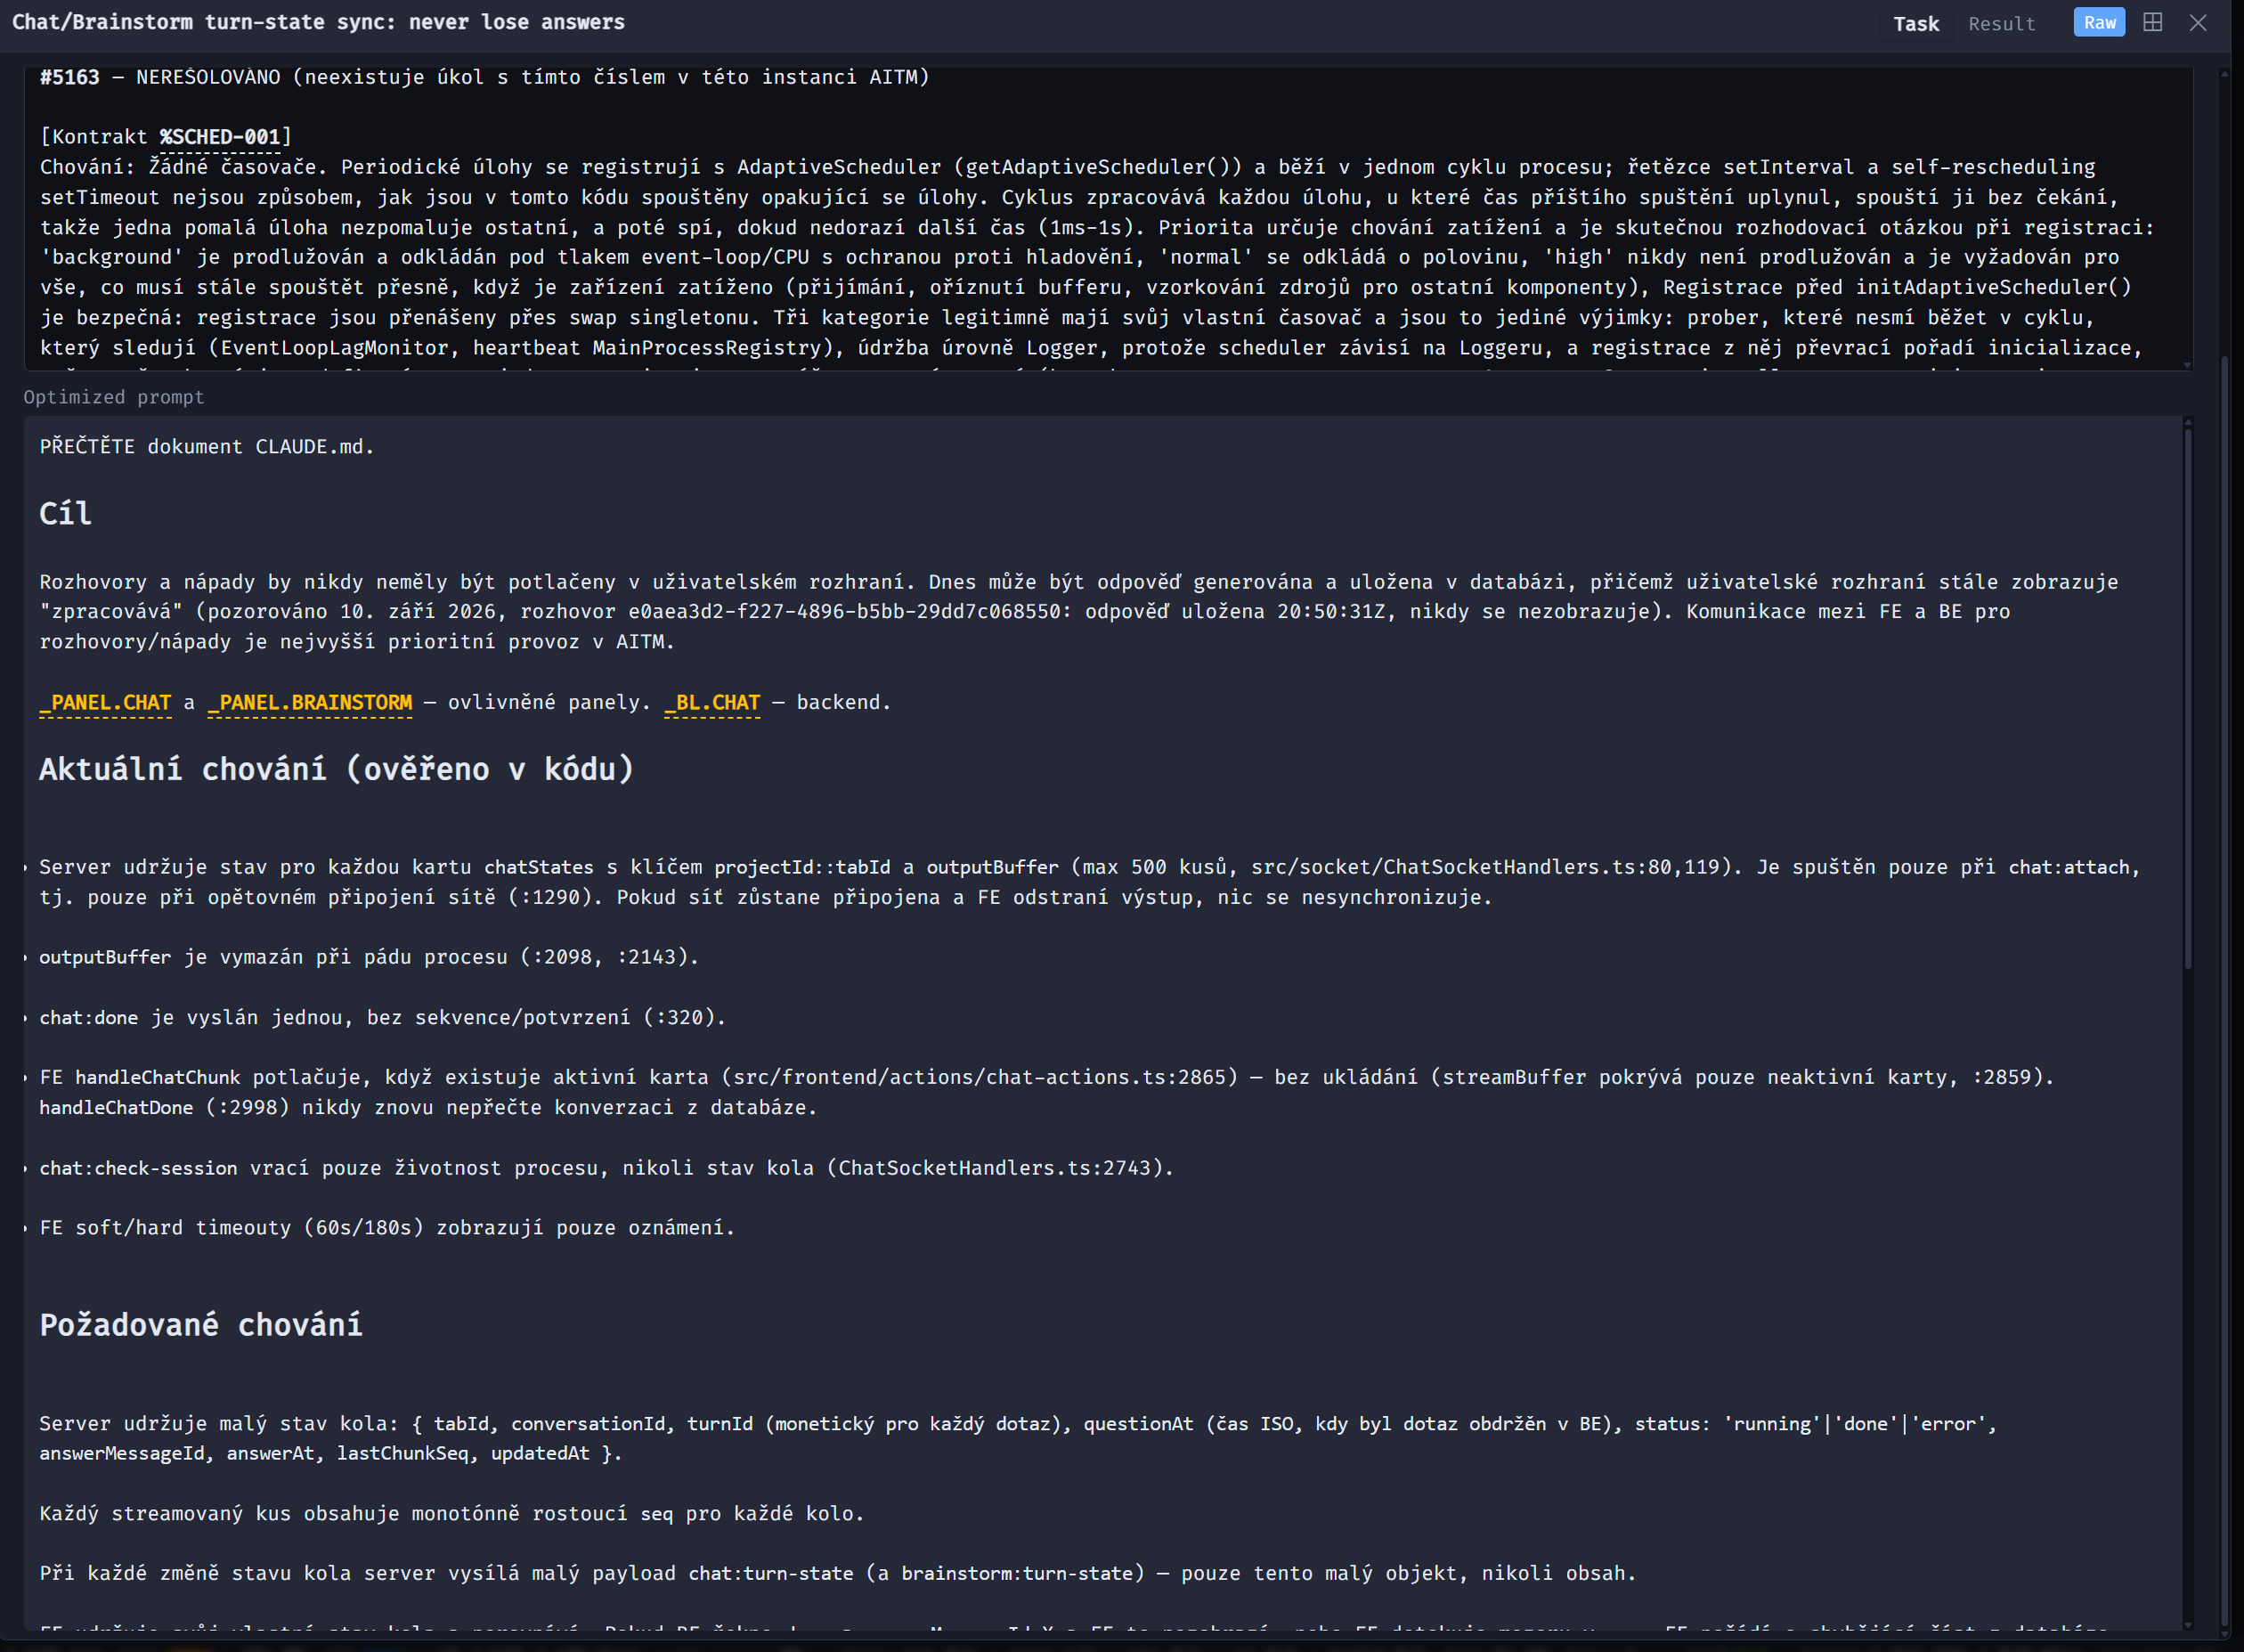
Dev Dashboard: Twoje centrum dowodzenia
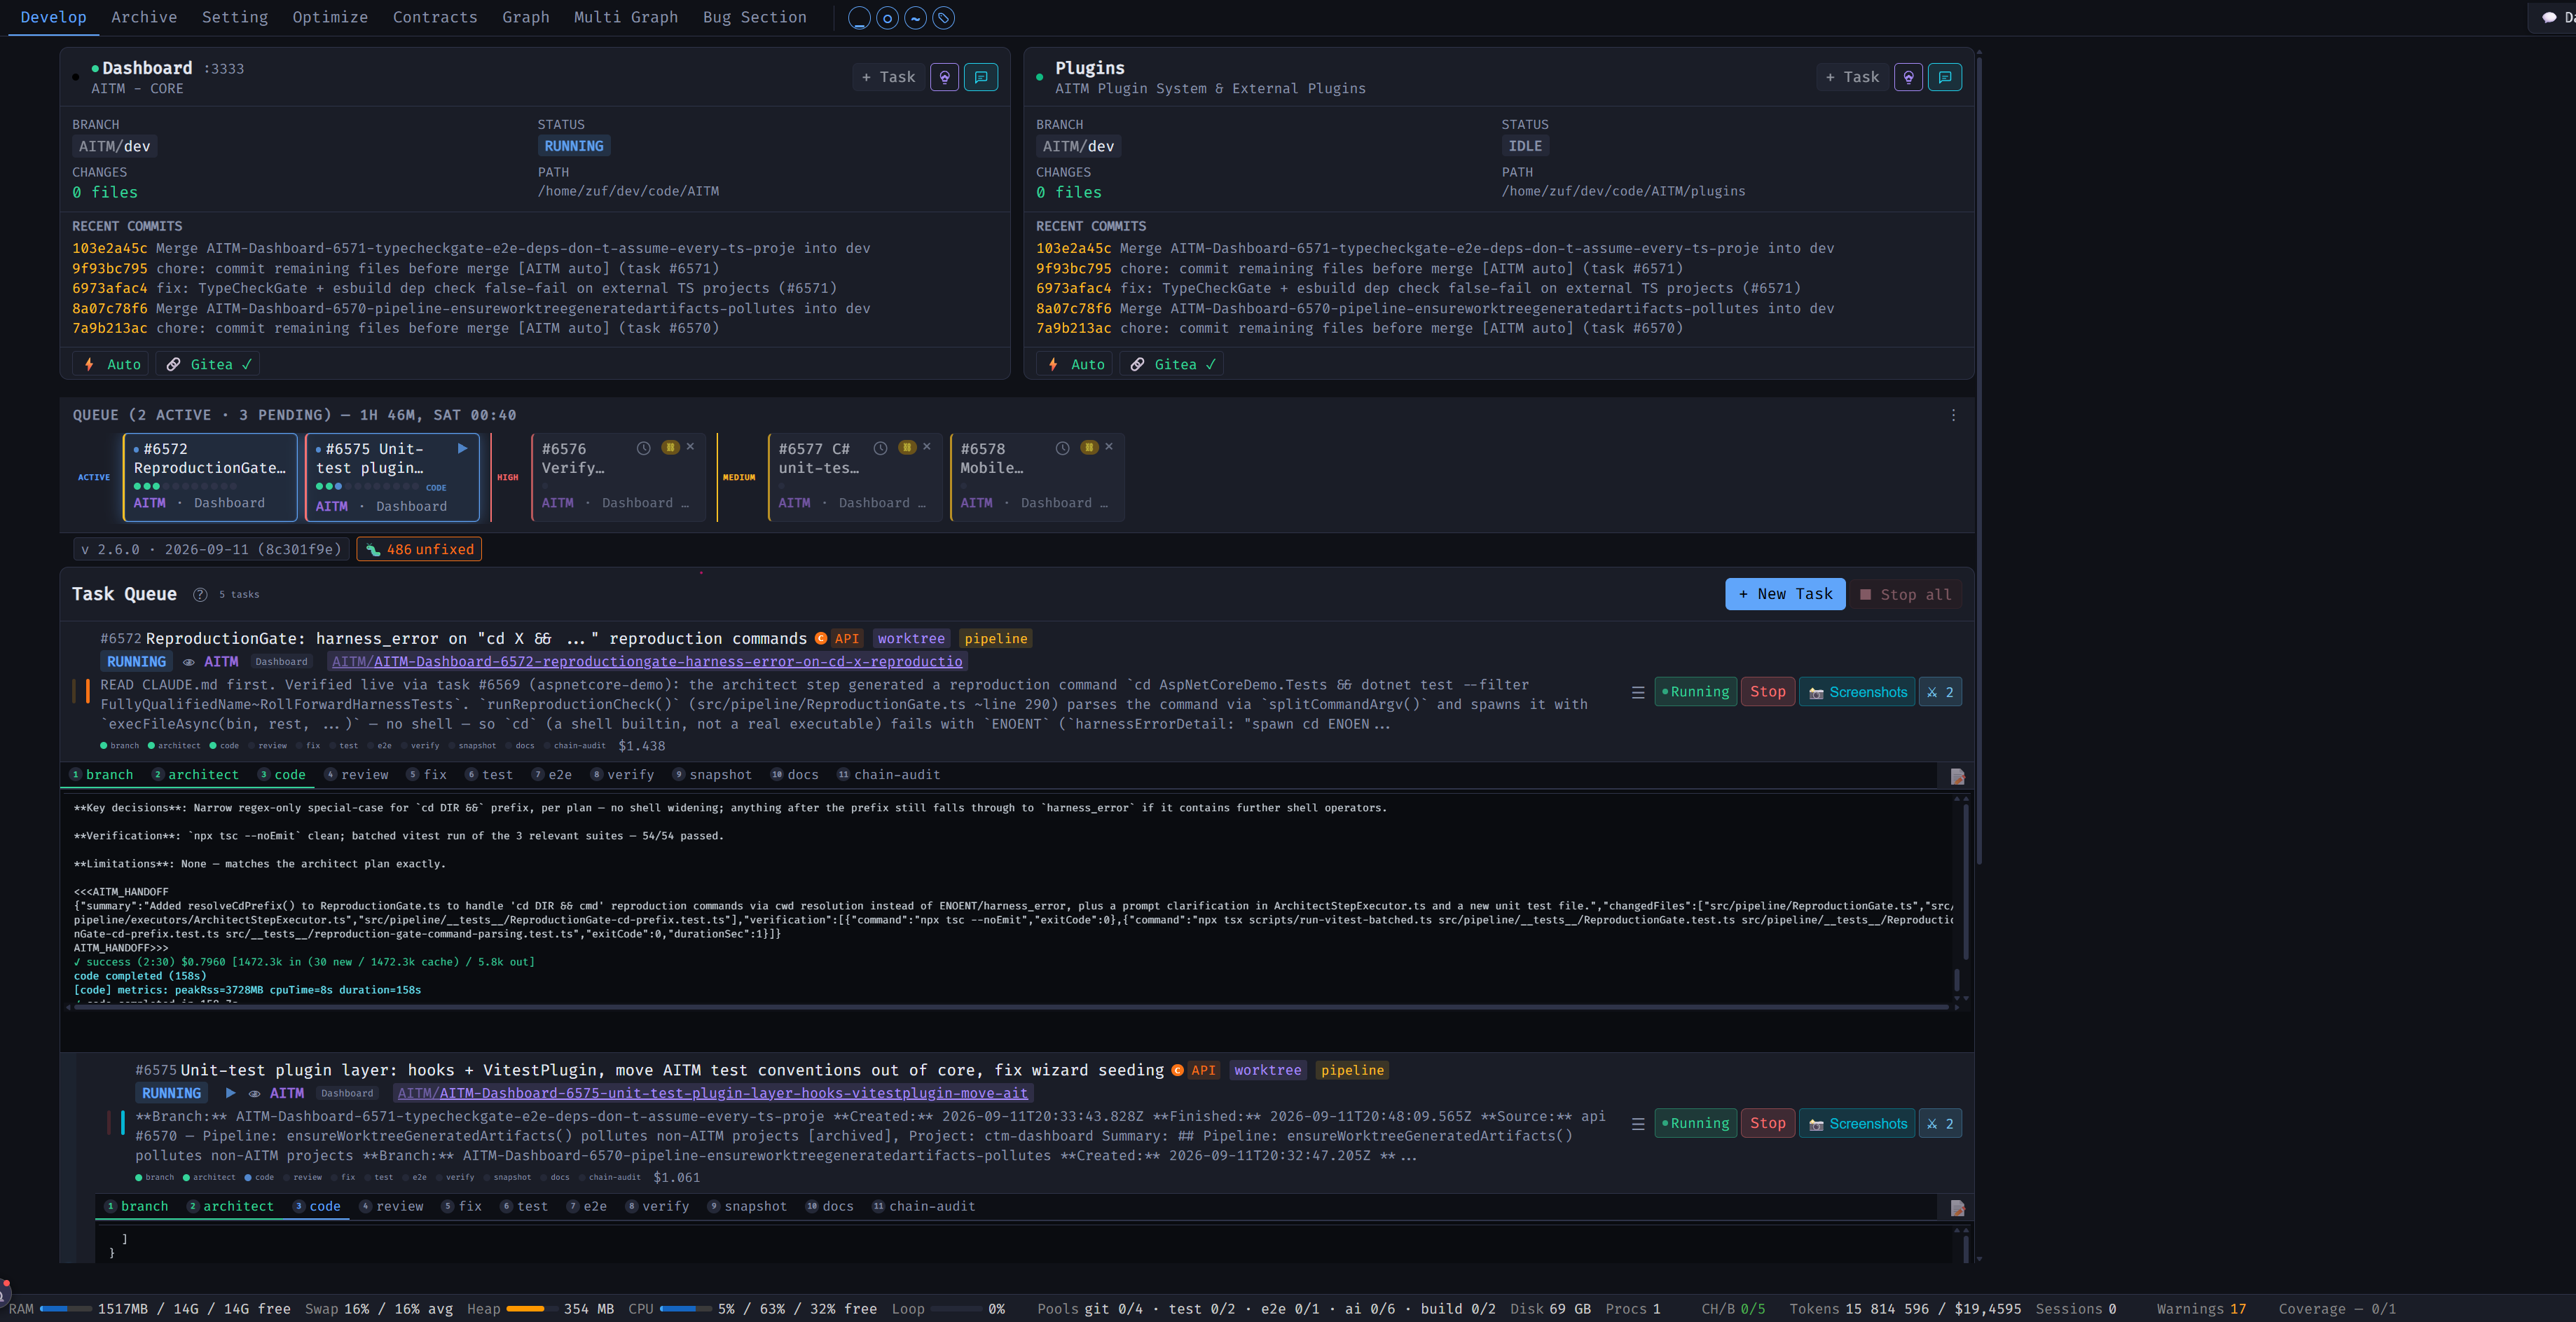
Wszystkie projekty, aktywne pipeline, status gita i kolejka zadań na jednym ekranie. Strumień konsoli na żywo pokazuje pracę AI w czasie rzeczywistym. Przeciągnij i upuść zadania, aby zmienić priorytet.
Jak to działa
12-krokowy pipeline: od izolowanej gałęzi przez compliance, review i testy po dokumentację i chain audit. Następnie kolejka scalania wprowadza wynik do dev.

Branch
Tworzy izolowaną gałąź i worktree dla zadania.

Architect
Planuje zmianę na podstawie kodu projektu i kontraktów.

Code
Wdraża zaplanowane zmiany.

Compliance check
Sprawdza złożone zadania względem wymagań; pomijany przy prostszych zadaniach.

Review
Sprawdza implementację i wydaje werdykt.

Fix
W razie potrzeby rozwiązuje ustalenia z review.

Test
Uruchamia automatyczne testy projektu.

E2E
Testuje ścieżki użytkownika w aplikacji.

Verify
Sprawdza wynik względem kryteriów akceptacji.

Snapshot
Opcjonalnie zapisuje UI do porównania wizualnego.

Docs
Aktualizuje dokumentację i kontrakty behawioralne.

Chain audit
Ponownie sprawdza wcześniejsze zadania na końcu łańcucha zadań.
Przewodnik użytkownika
Dowiedz się, jak korzystać z każdej funkcji. Kliknij, aby rozwinąć.
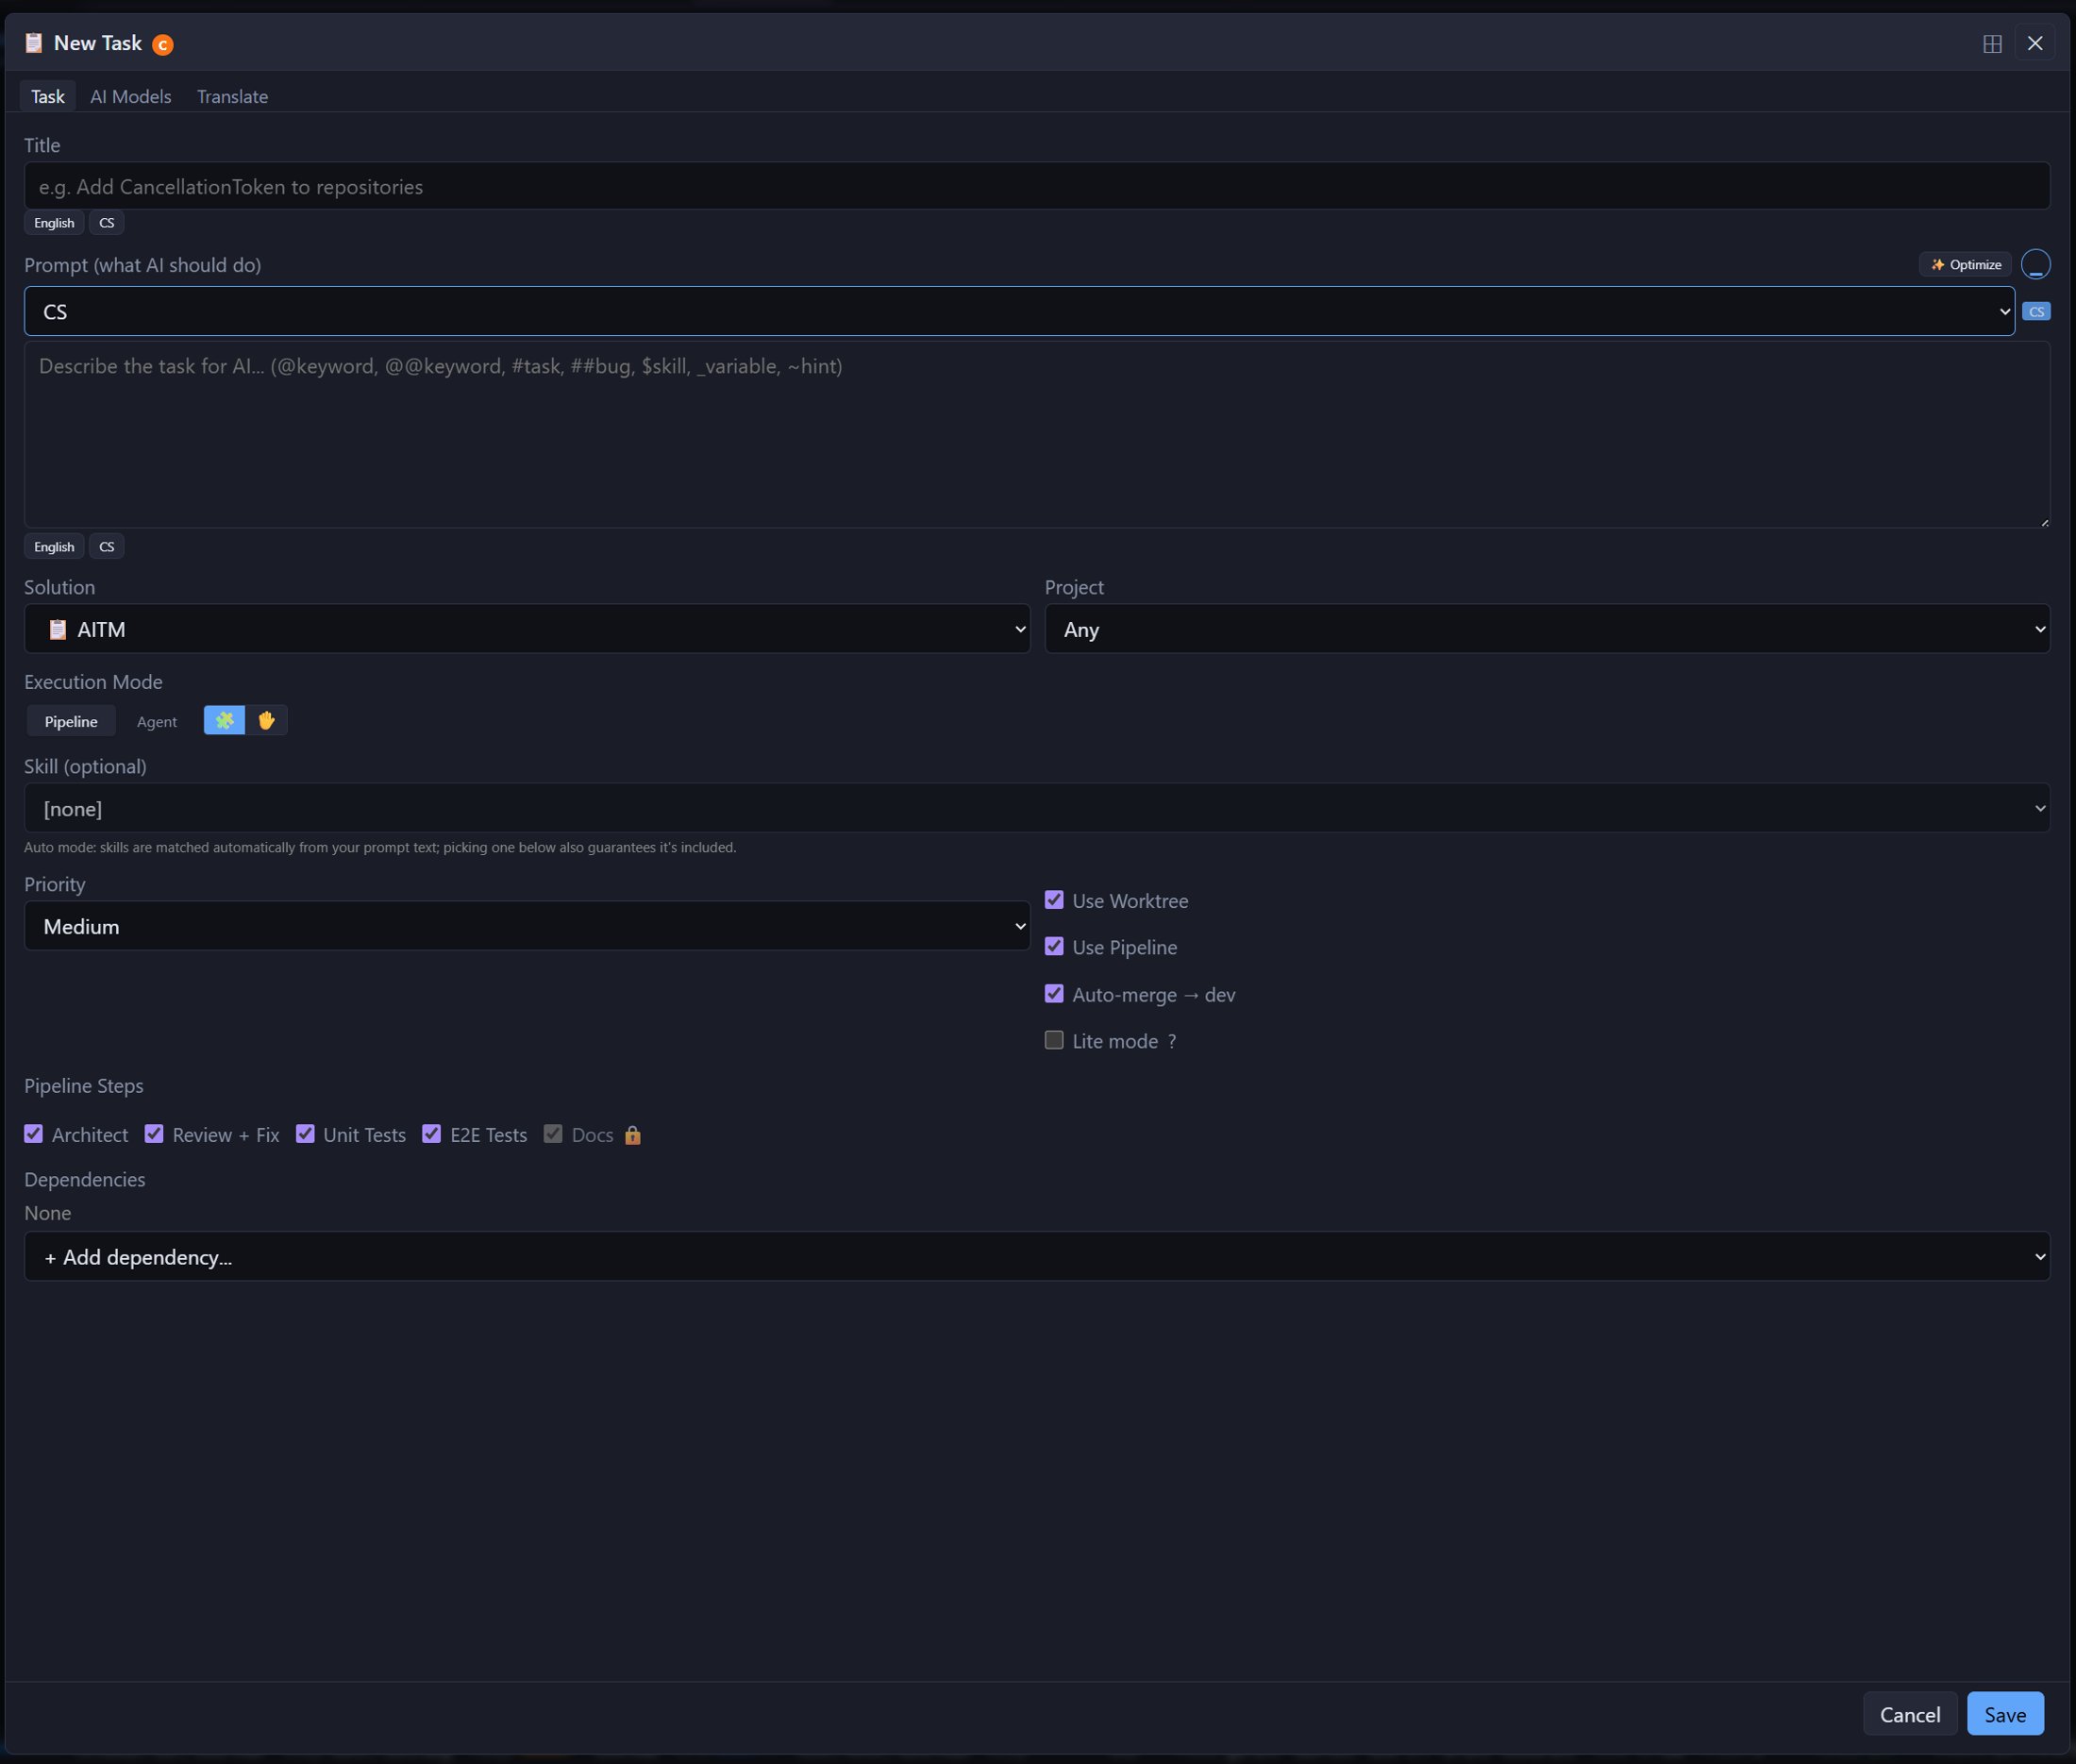
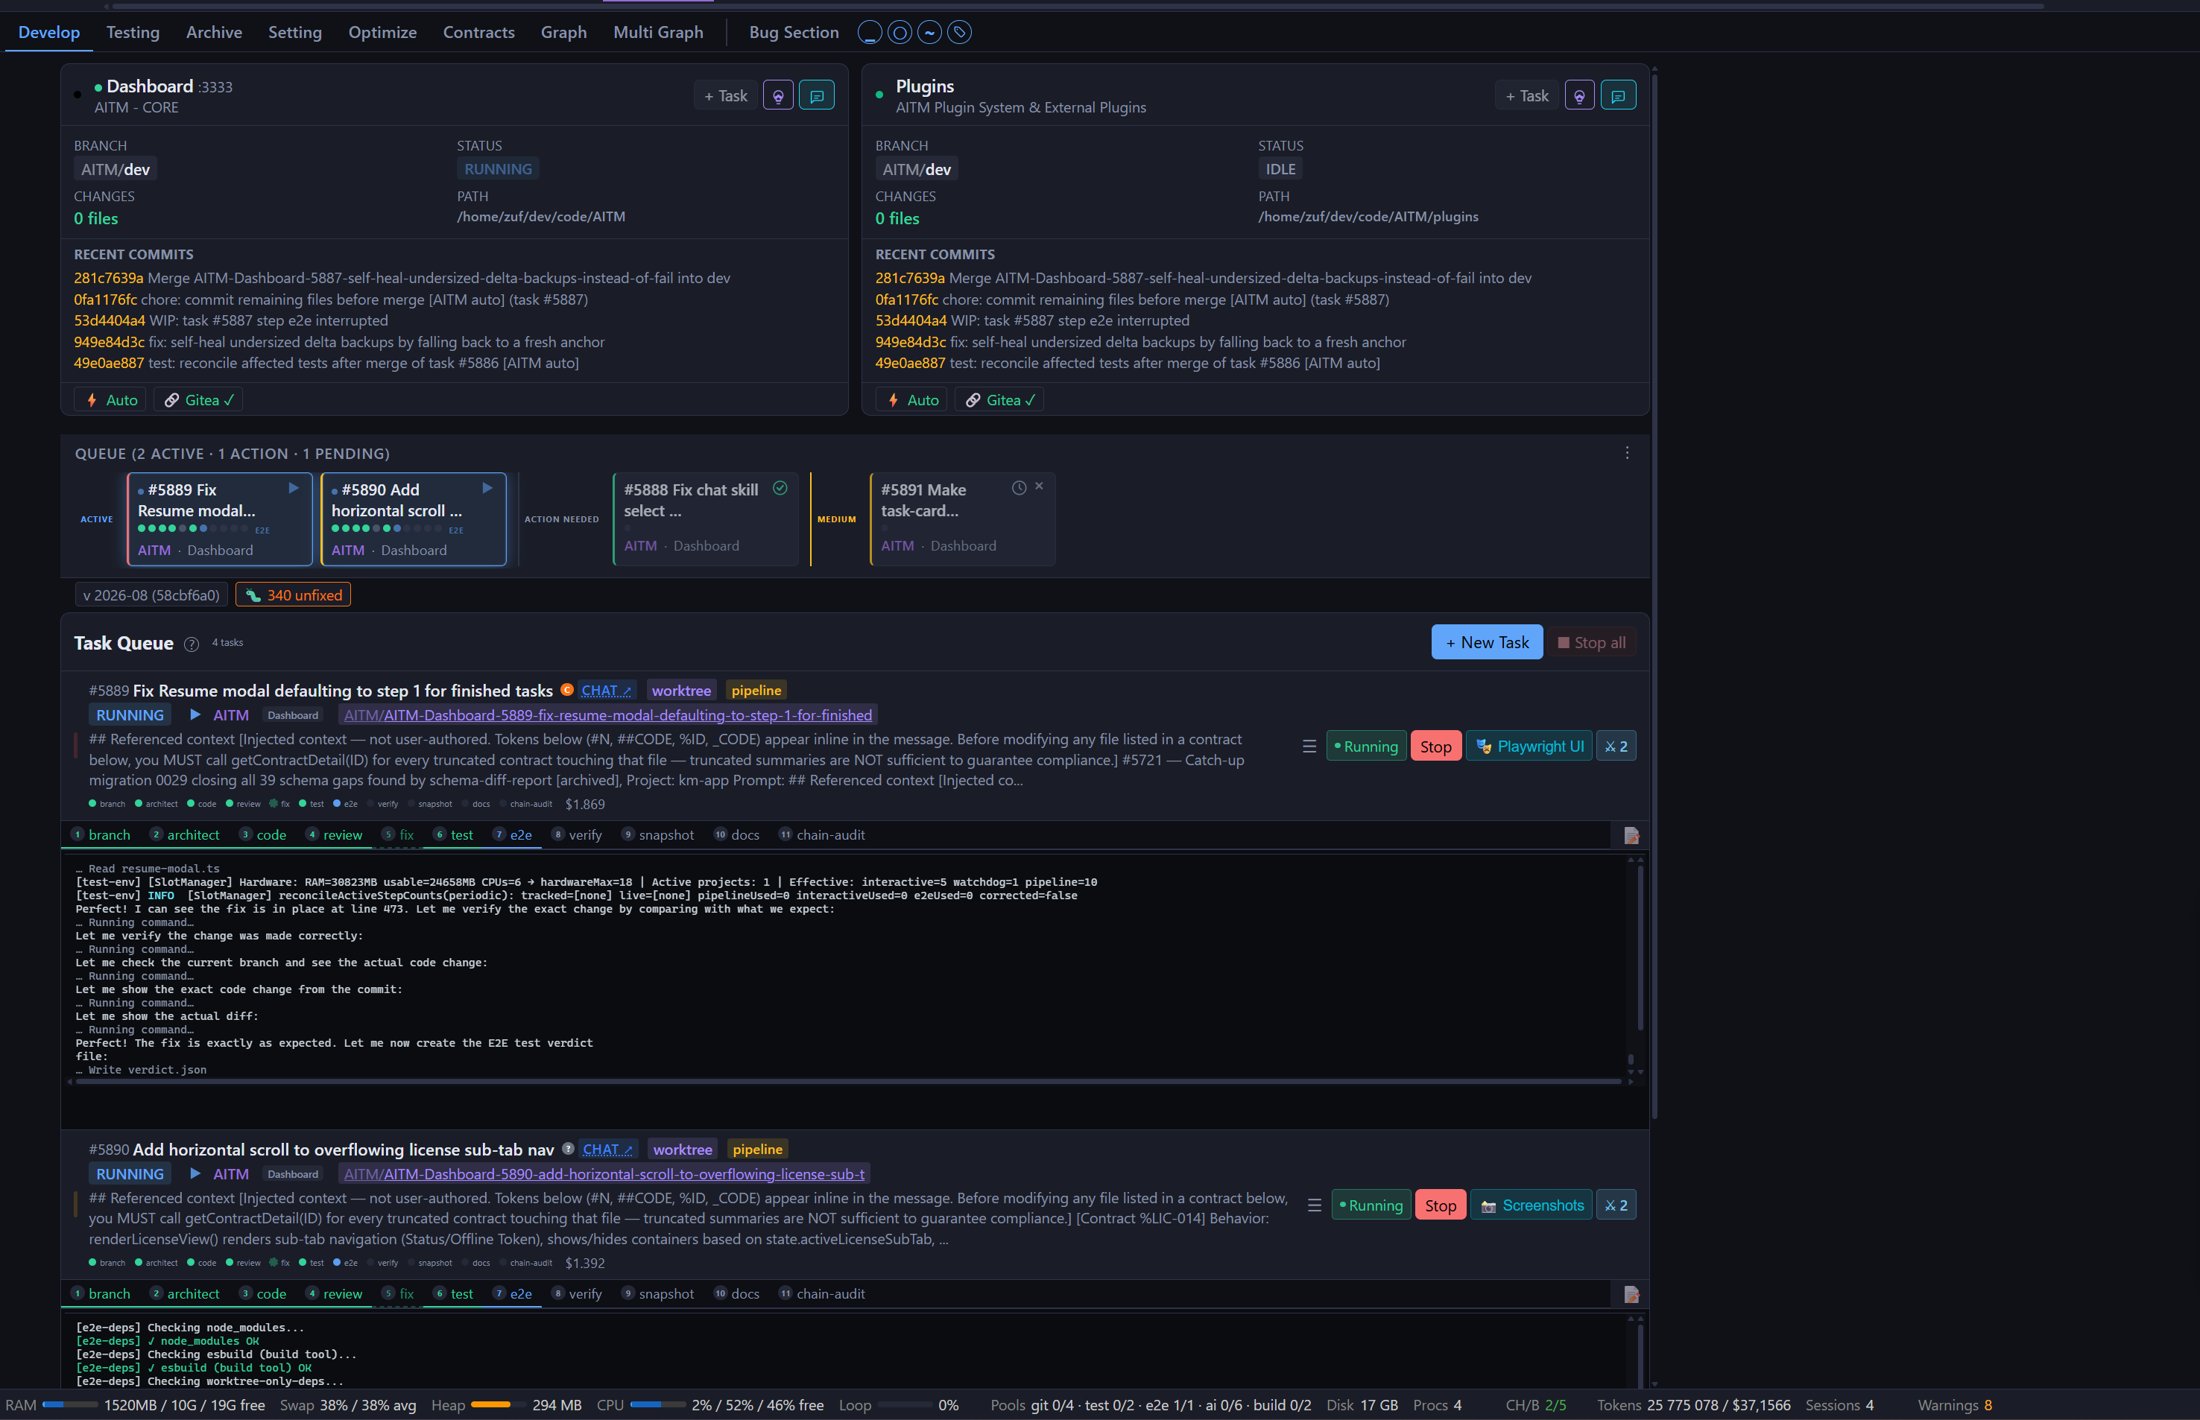
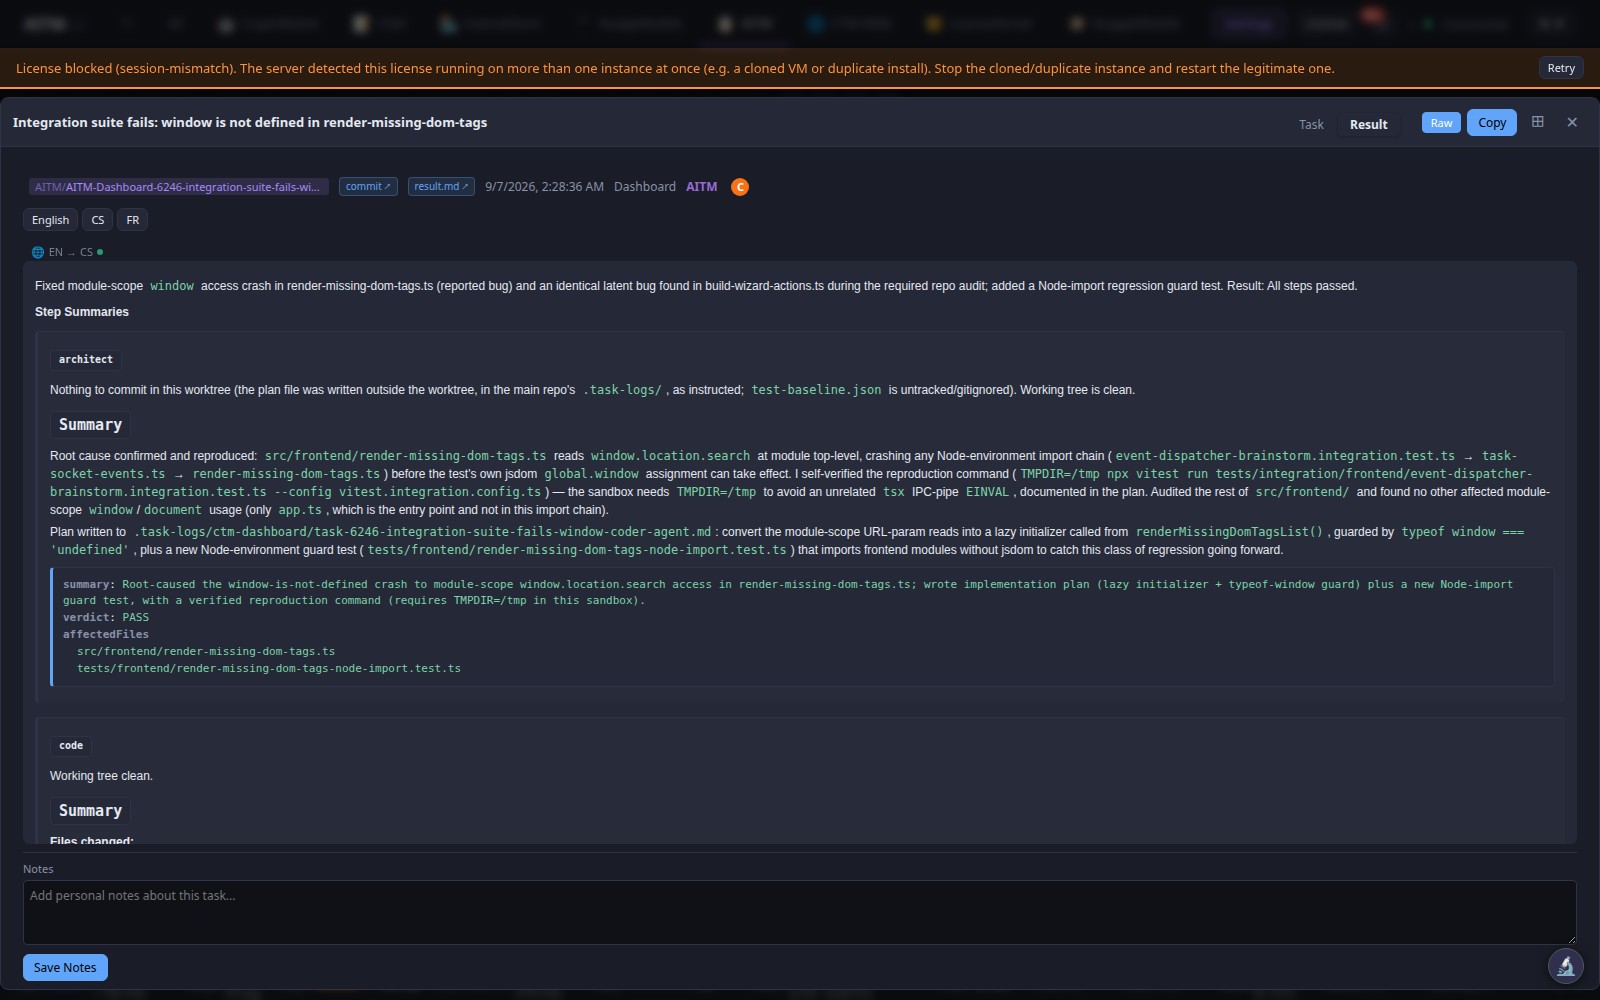
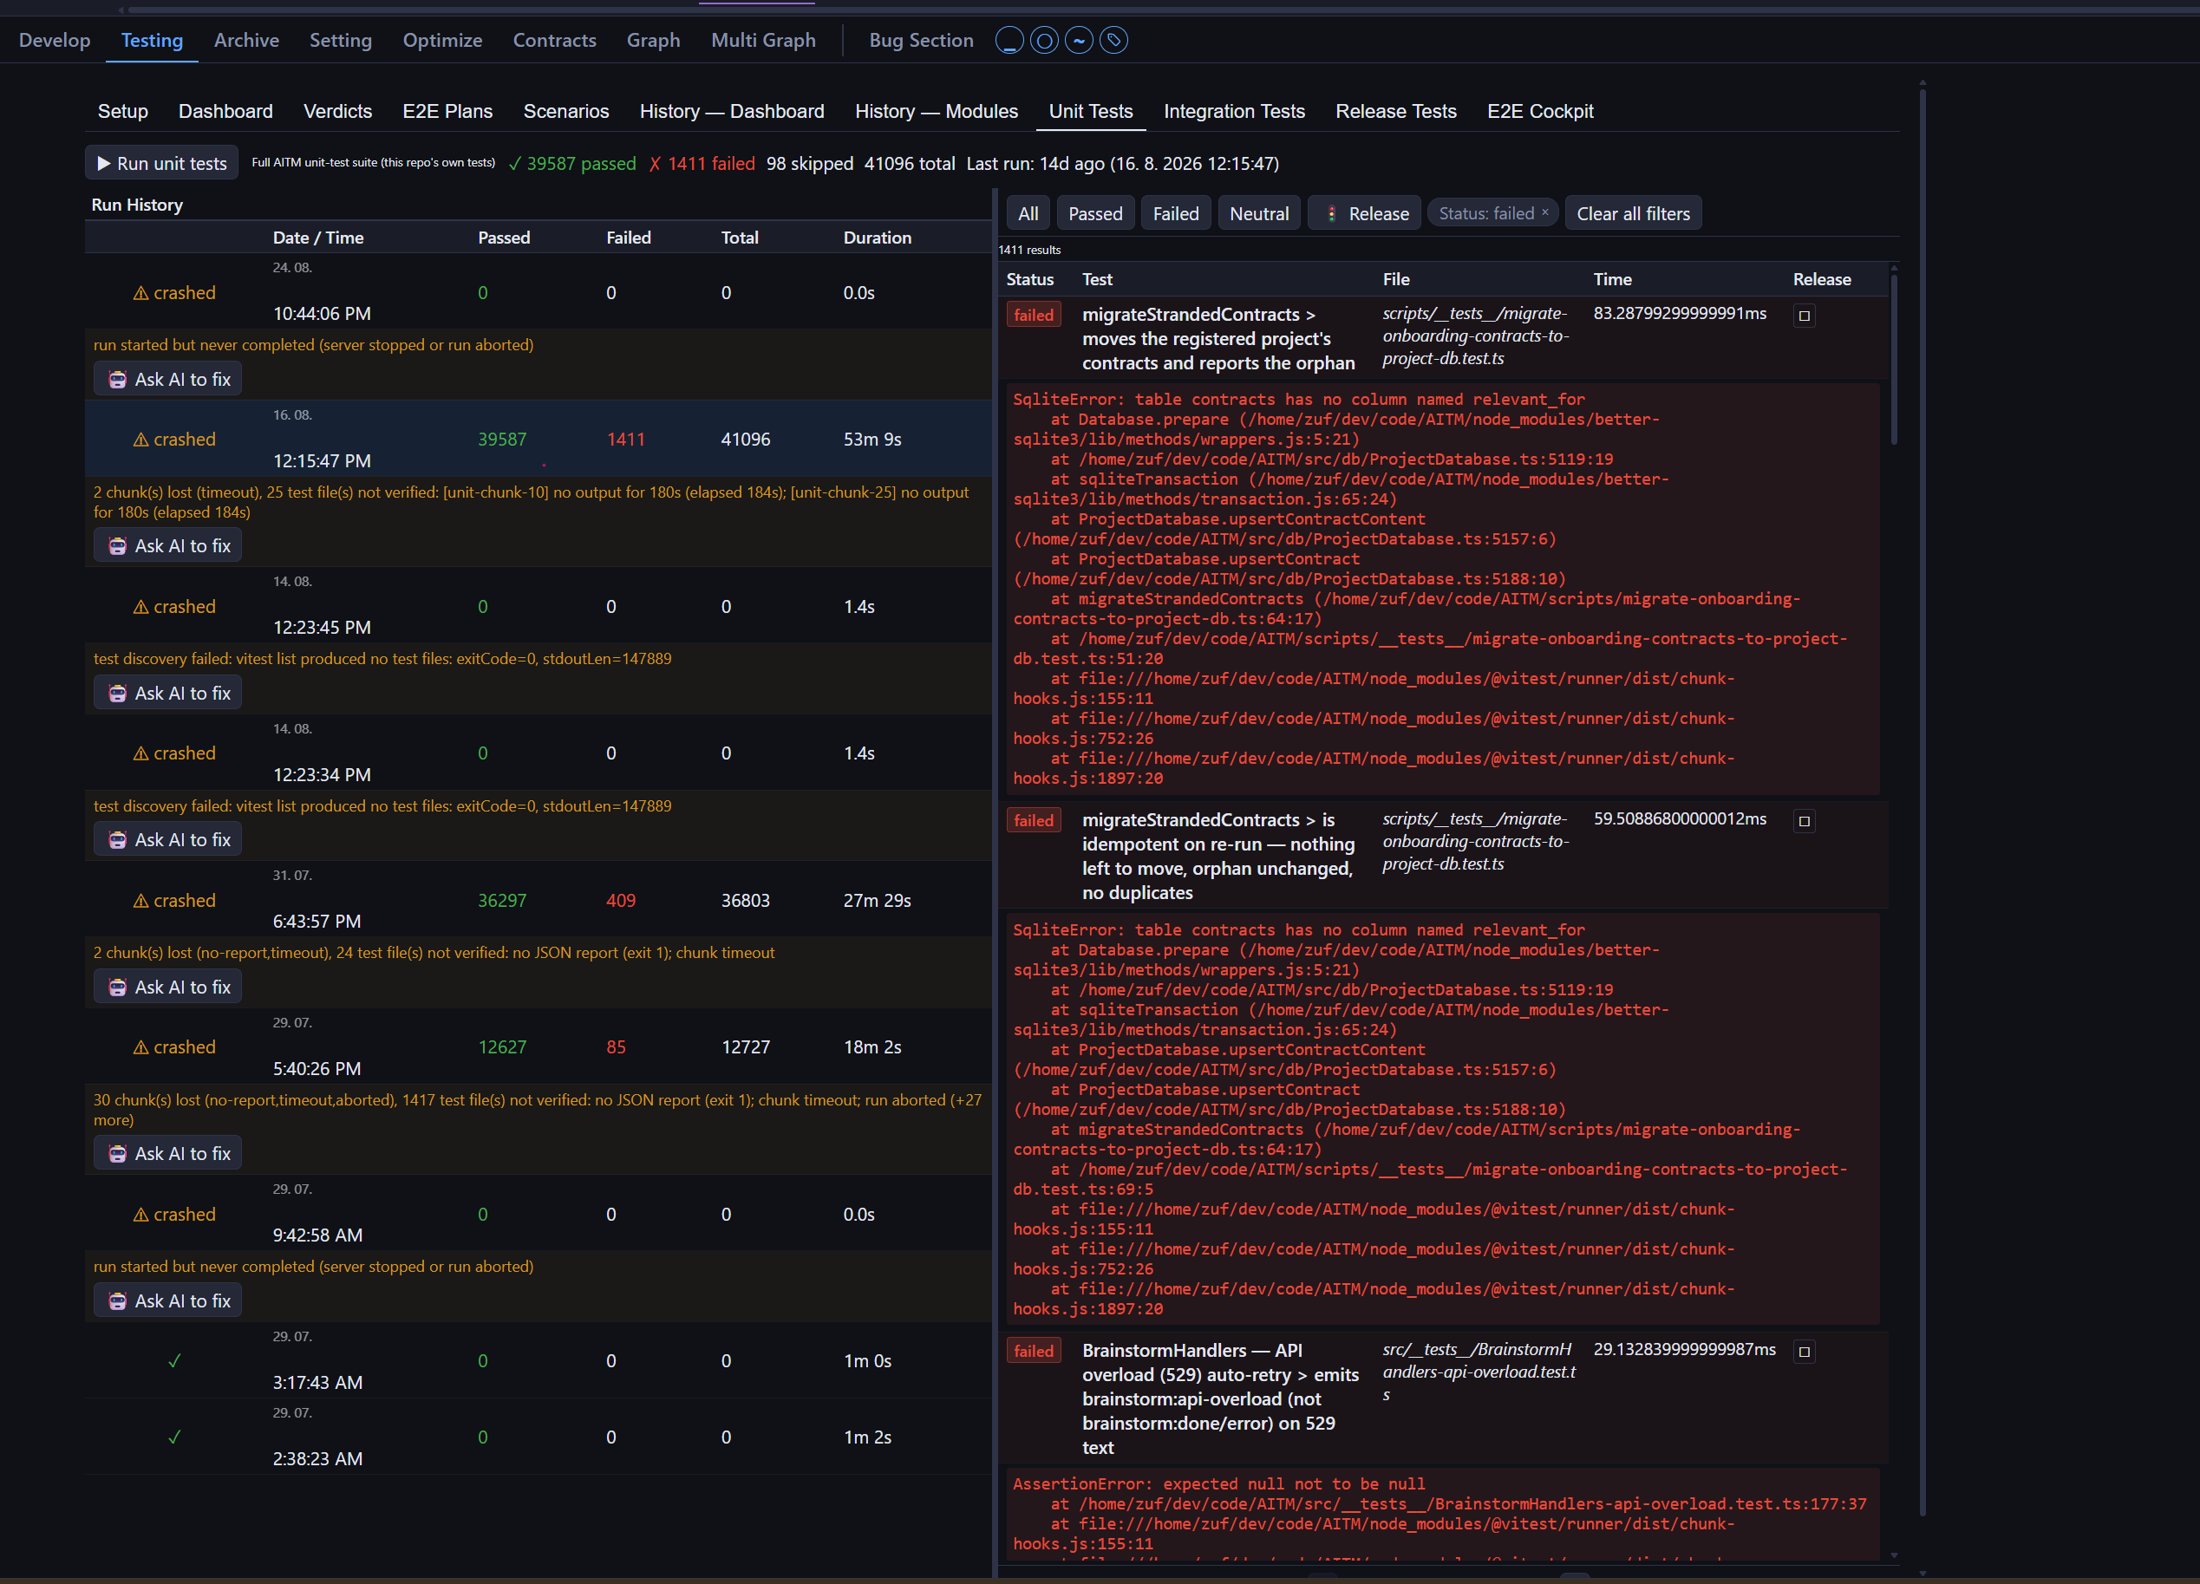
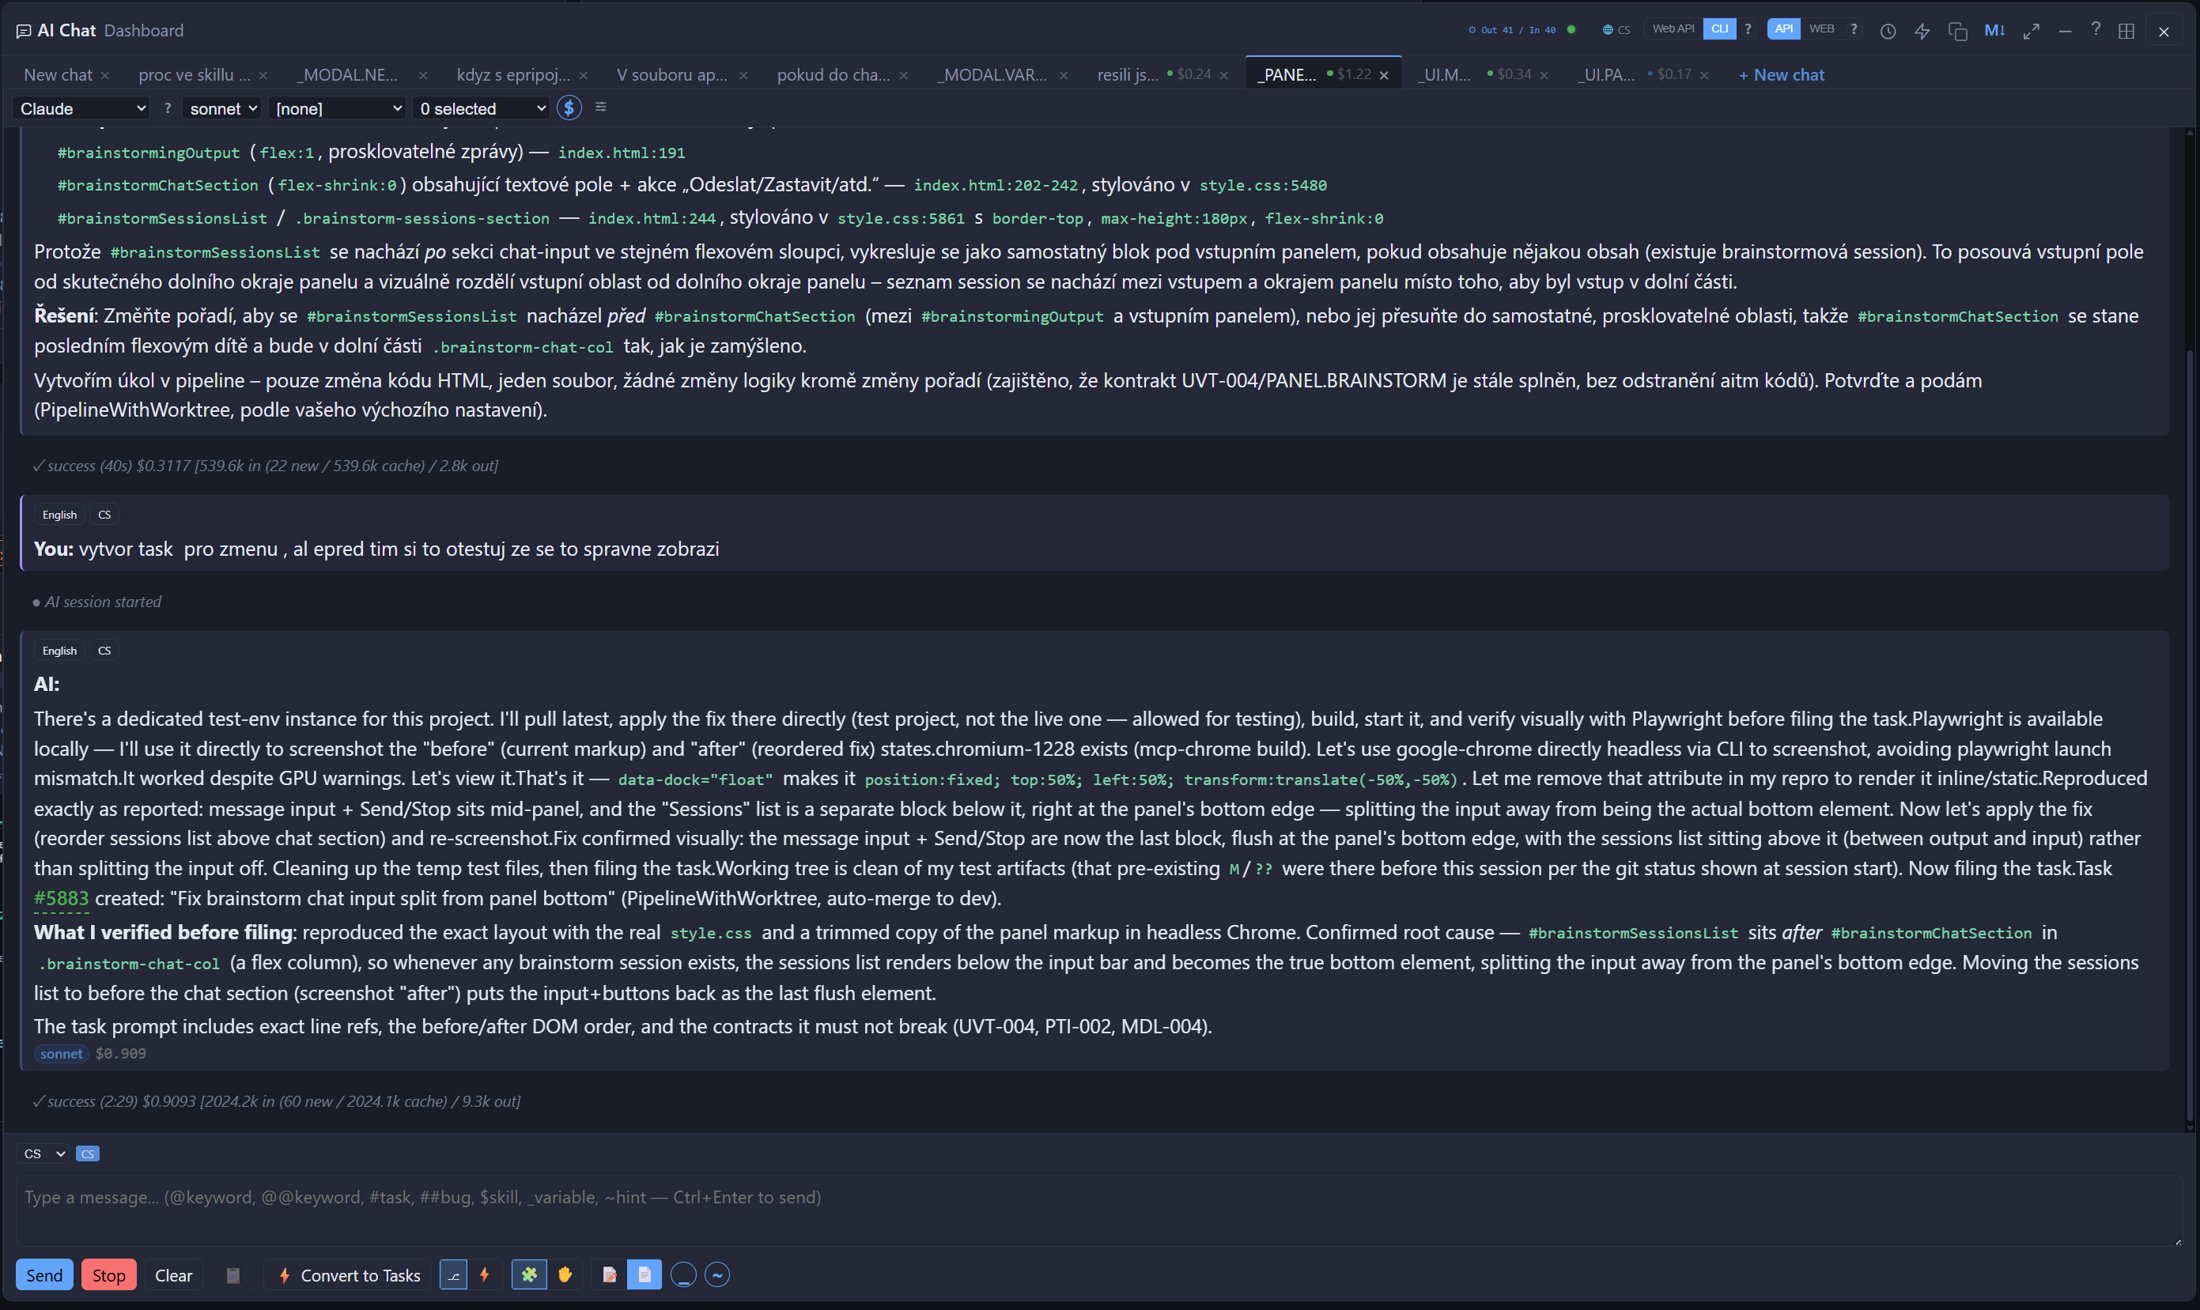
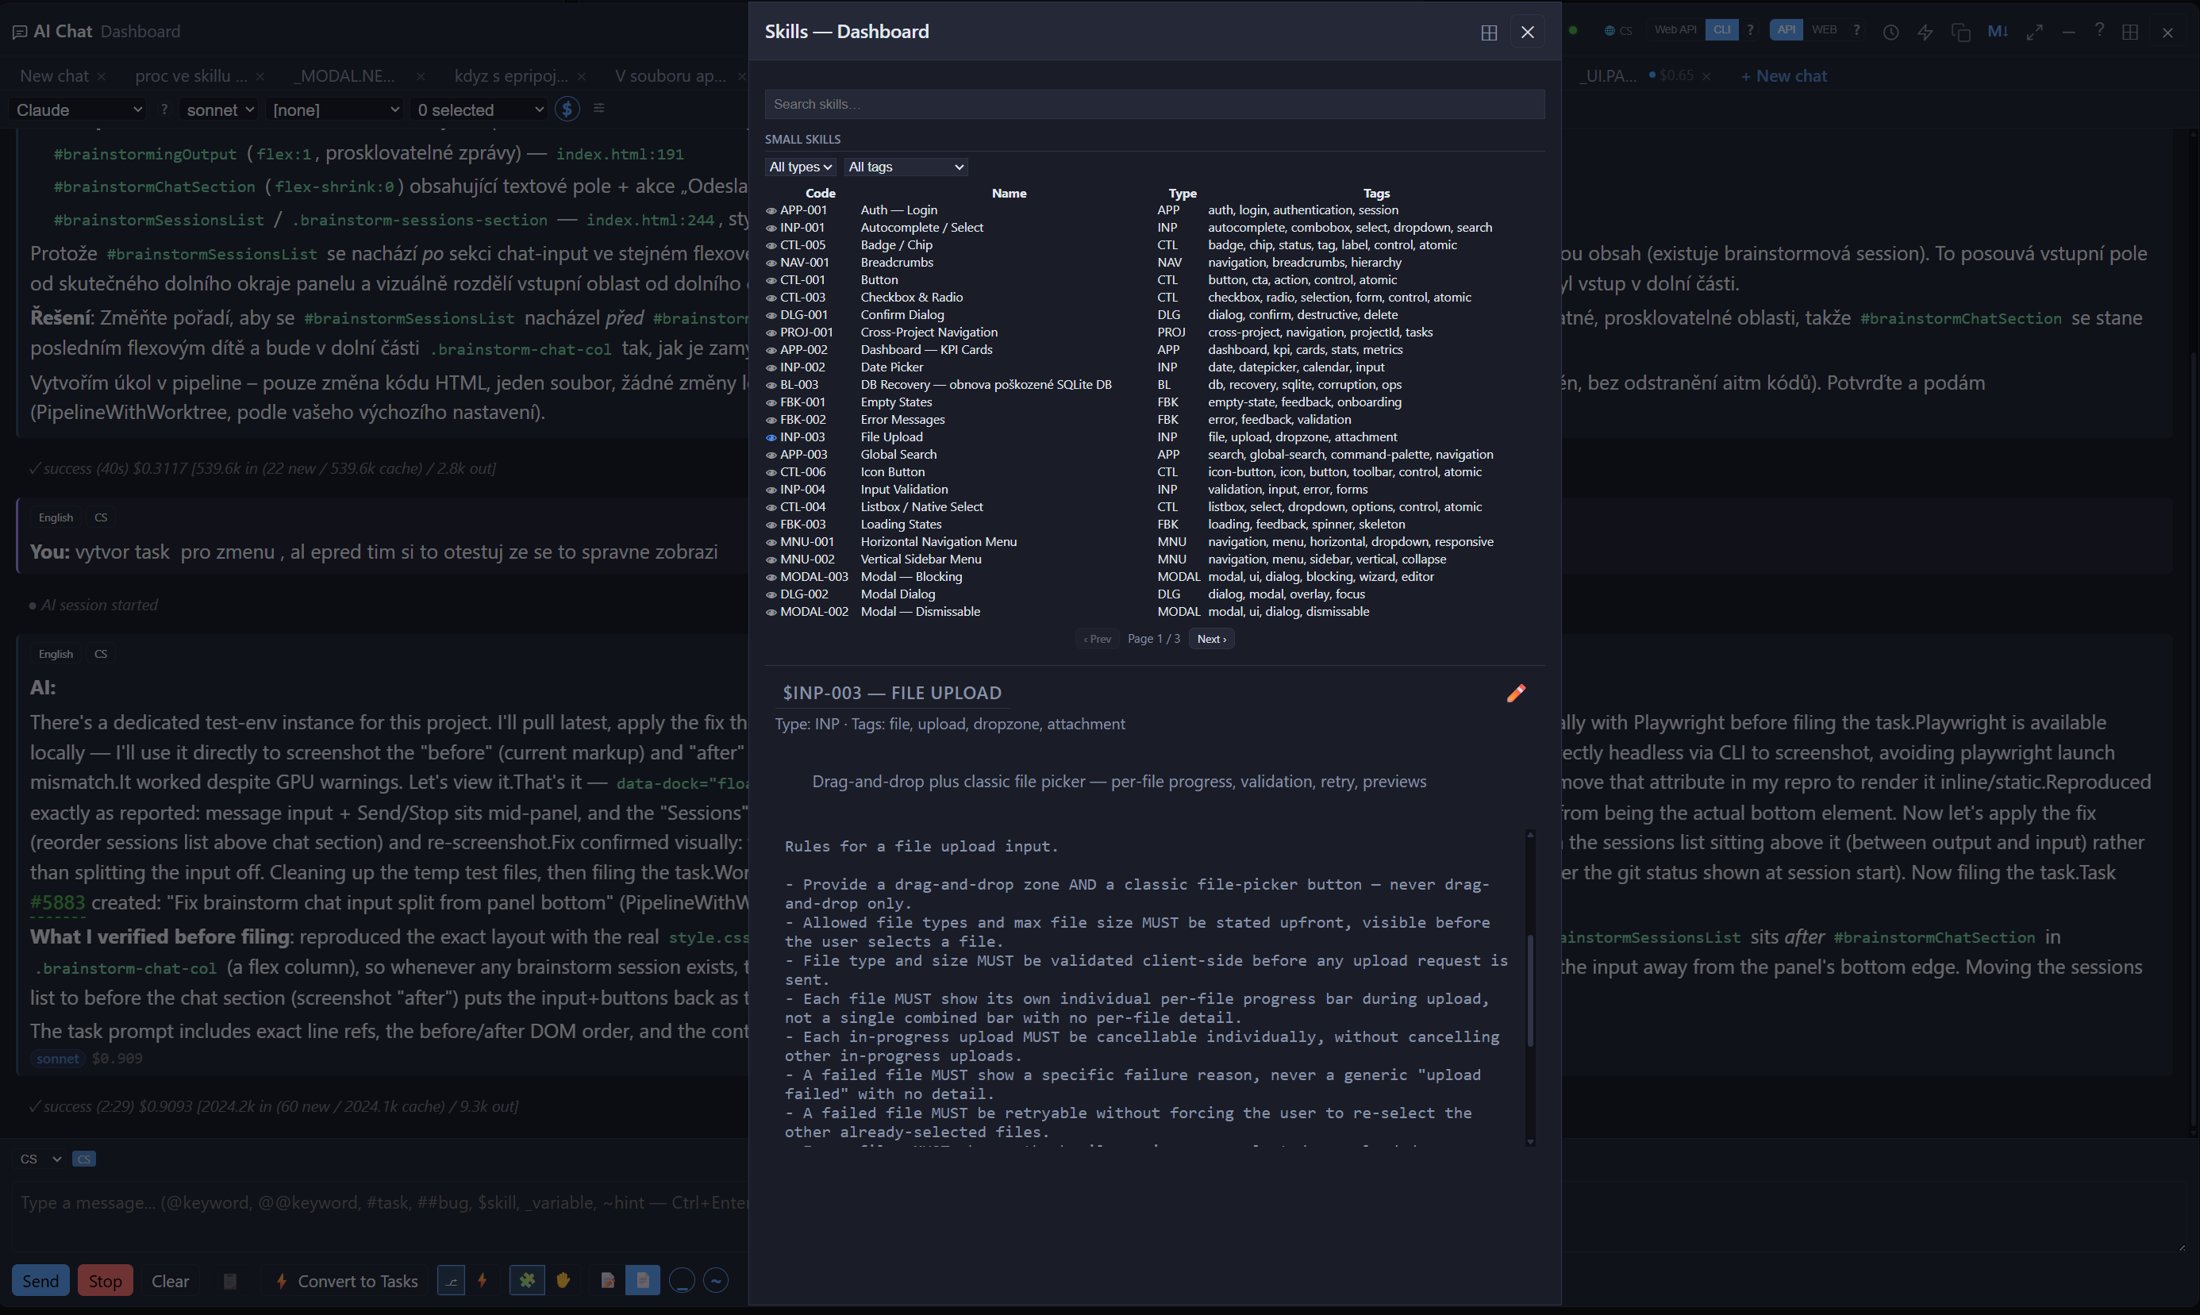
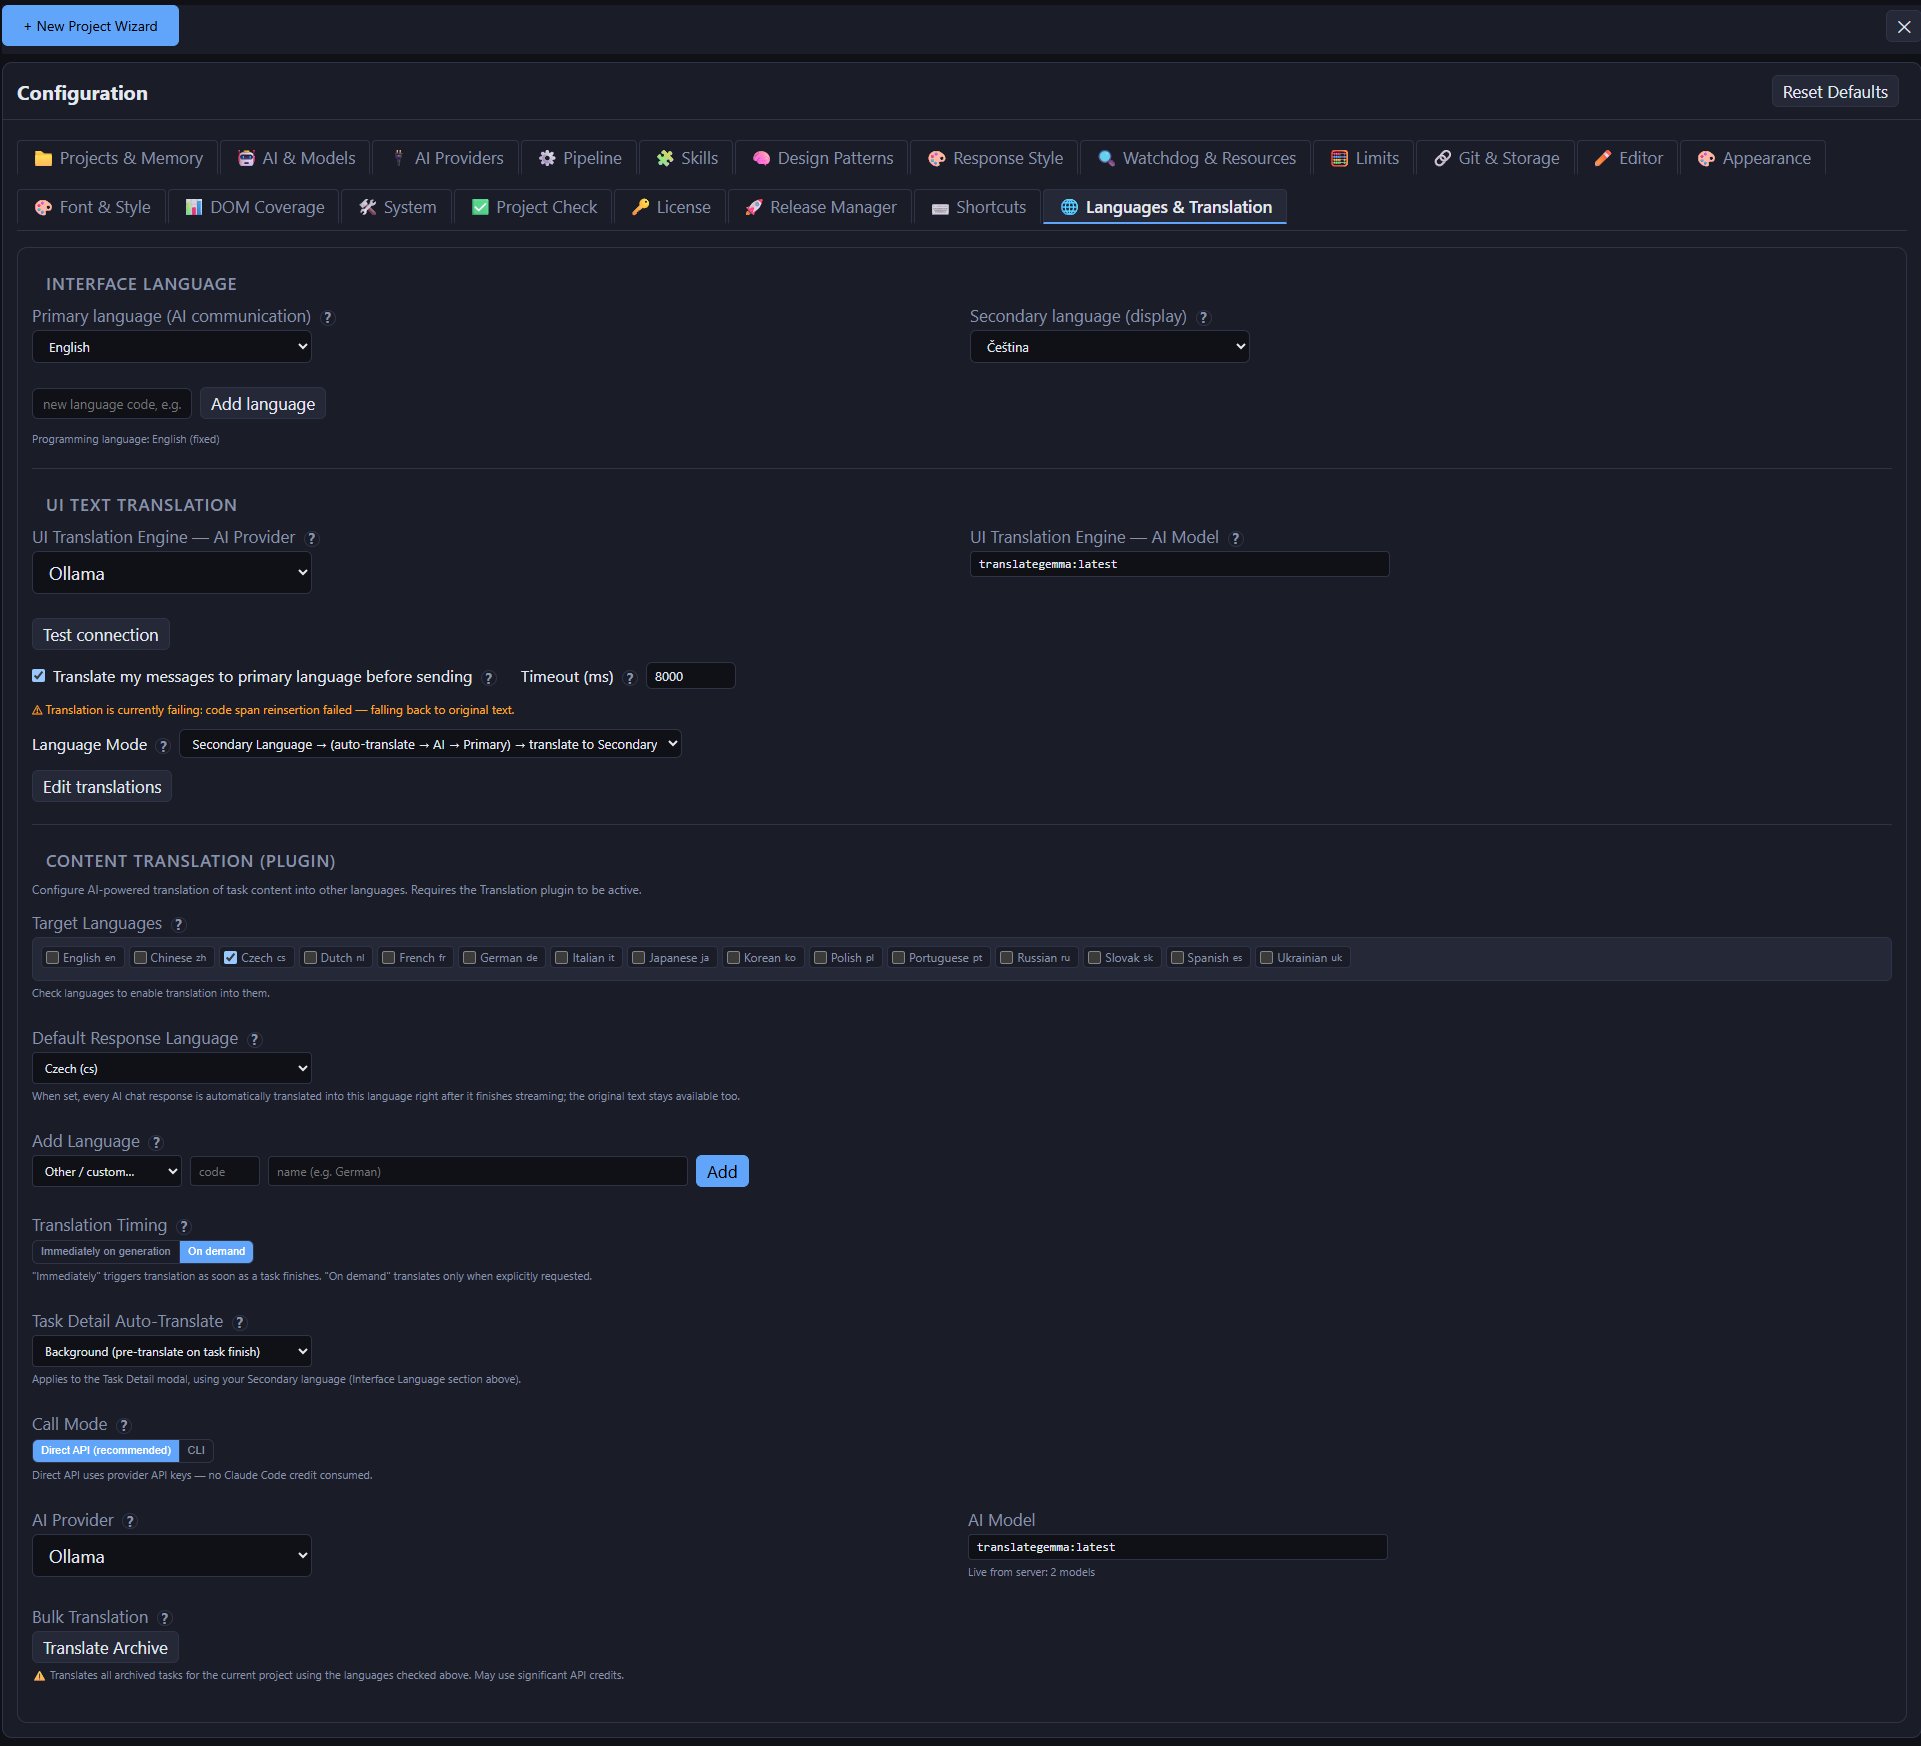
AITM generuje Twój kod
AI wykonuje rutynowe kodowanie, więc zespoły działają szybciej. AI pisze kod za pomocą wybranych przez Ciebie modeli. Twój zespół przydziela pracę, sprawdza ją i decyduje.
Nowe funkcje i całe moduły z opisu w zwykłym języku
Poprawki błędów z obowiązkową reprodukcją: zadanie najpierw dowodzi błędu, a po poprawce dowodzi jego braku
Refaktoryzacja i modernizacja dużych, długo żyjących baz kodu bez ryzyka dla głównej gałęzi
Testy jednostkowe, scenariusze end-to-end i dokumentacja, które same się generują i utrzymują
Dziesiątki zadań równolegle, każde w osobnej izolowanej kopii projektu
Wszystko na serwerze, nic na stacjach roboczych
AITM działa na Twoim serwerze, a użytkownicy pracują przez przeglądarkę. Kod źródłowy, worktree i dane nigdy nie opuszczają serwera.
Serwer przejmuje obciążenie
Buildy, testy i agenci AI działają na serwerze. Stacje robocze pozostają lekkie i nic się na nich nie instaluje.
Zamknięte środowisko Docker
AITM działa w kontenerach odizolowanych od innych systemów, z własnym magazynem na projekty, worktree i dane.
Szyfrowanie danych w spoczynku
Bazy danych, wyniki zadań, prompty, artefakty i kopie zapasowe są szyfrowane za pomocą AES-256. Skradziony dysk lub wyciek kopii zapasowej są nieczytelne.
Twój kod zostaje w Twojej sieci
AITM jest hostowany samodzielnie. Dostawcę AI wybierasz dla każdego kroku, w tym lokalny model Ollama, więc wrażliwy projekt nigdy nie musi opuszczać Twojej infrastruktury.
Każda zmiana odizolowana
Każde zadanie dostaje własną gałąź git i worktree. Trafia do głównej gałęzi dopiero po review, testach i sprawdzeniu buildu.
Pełny ślad audytowy
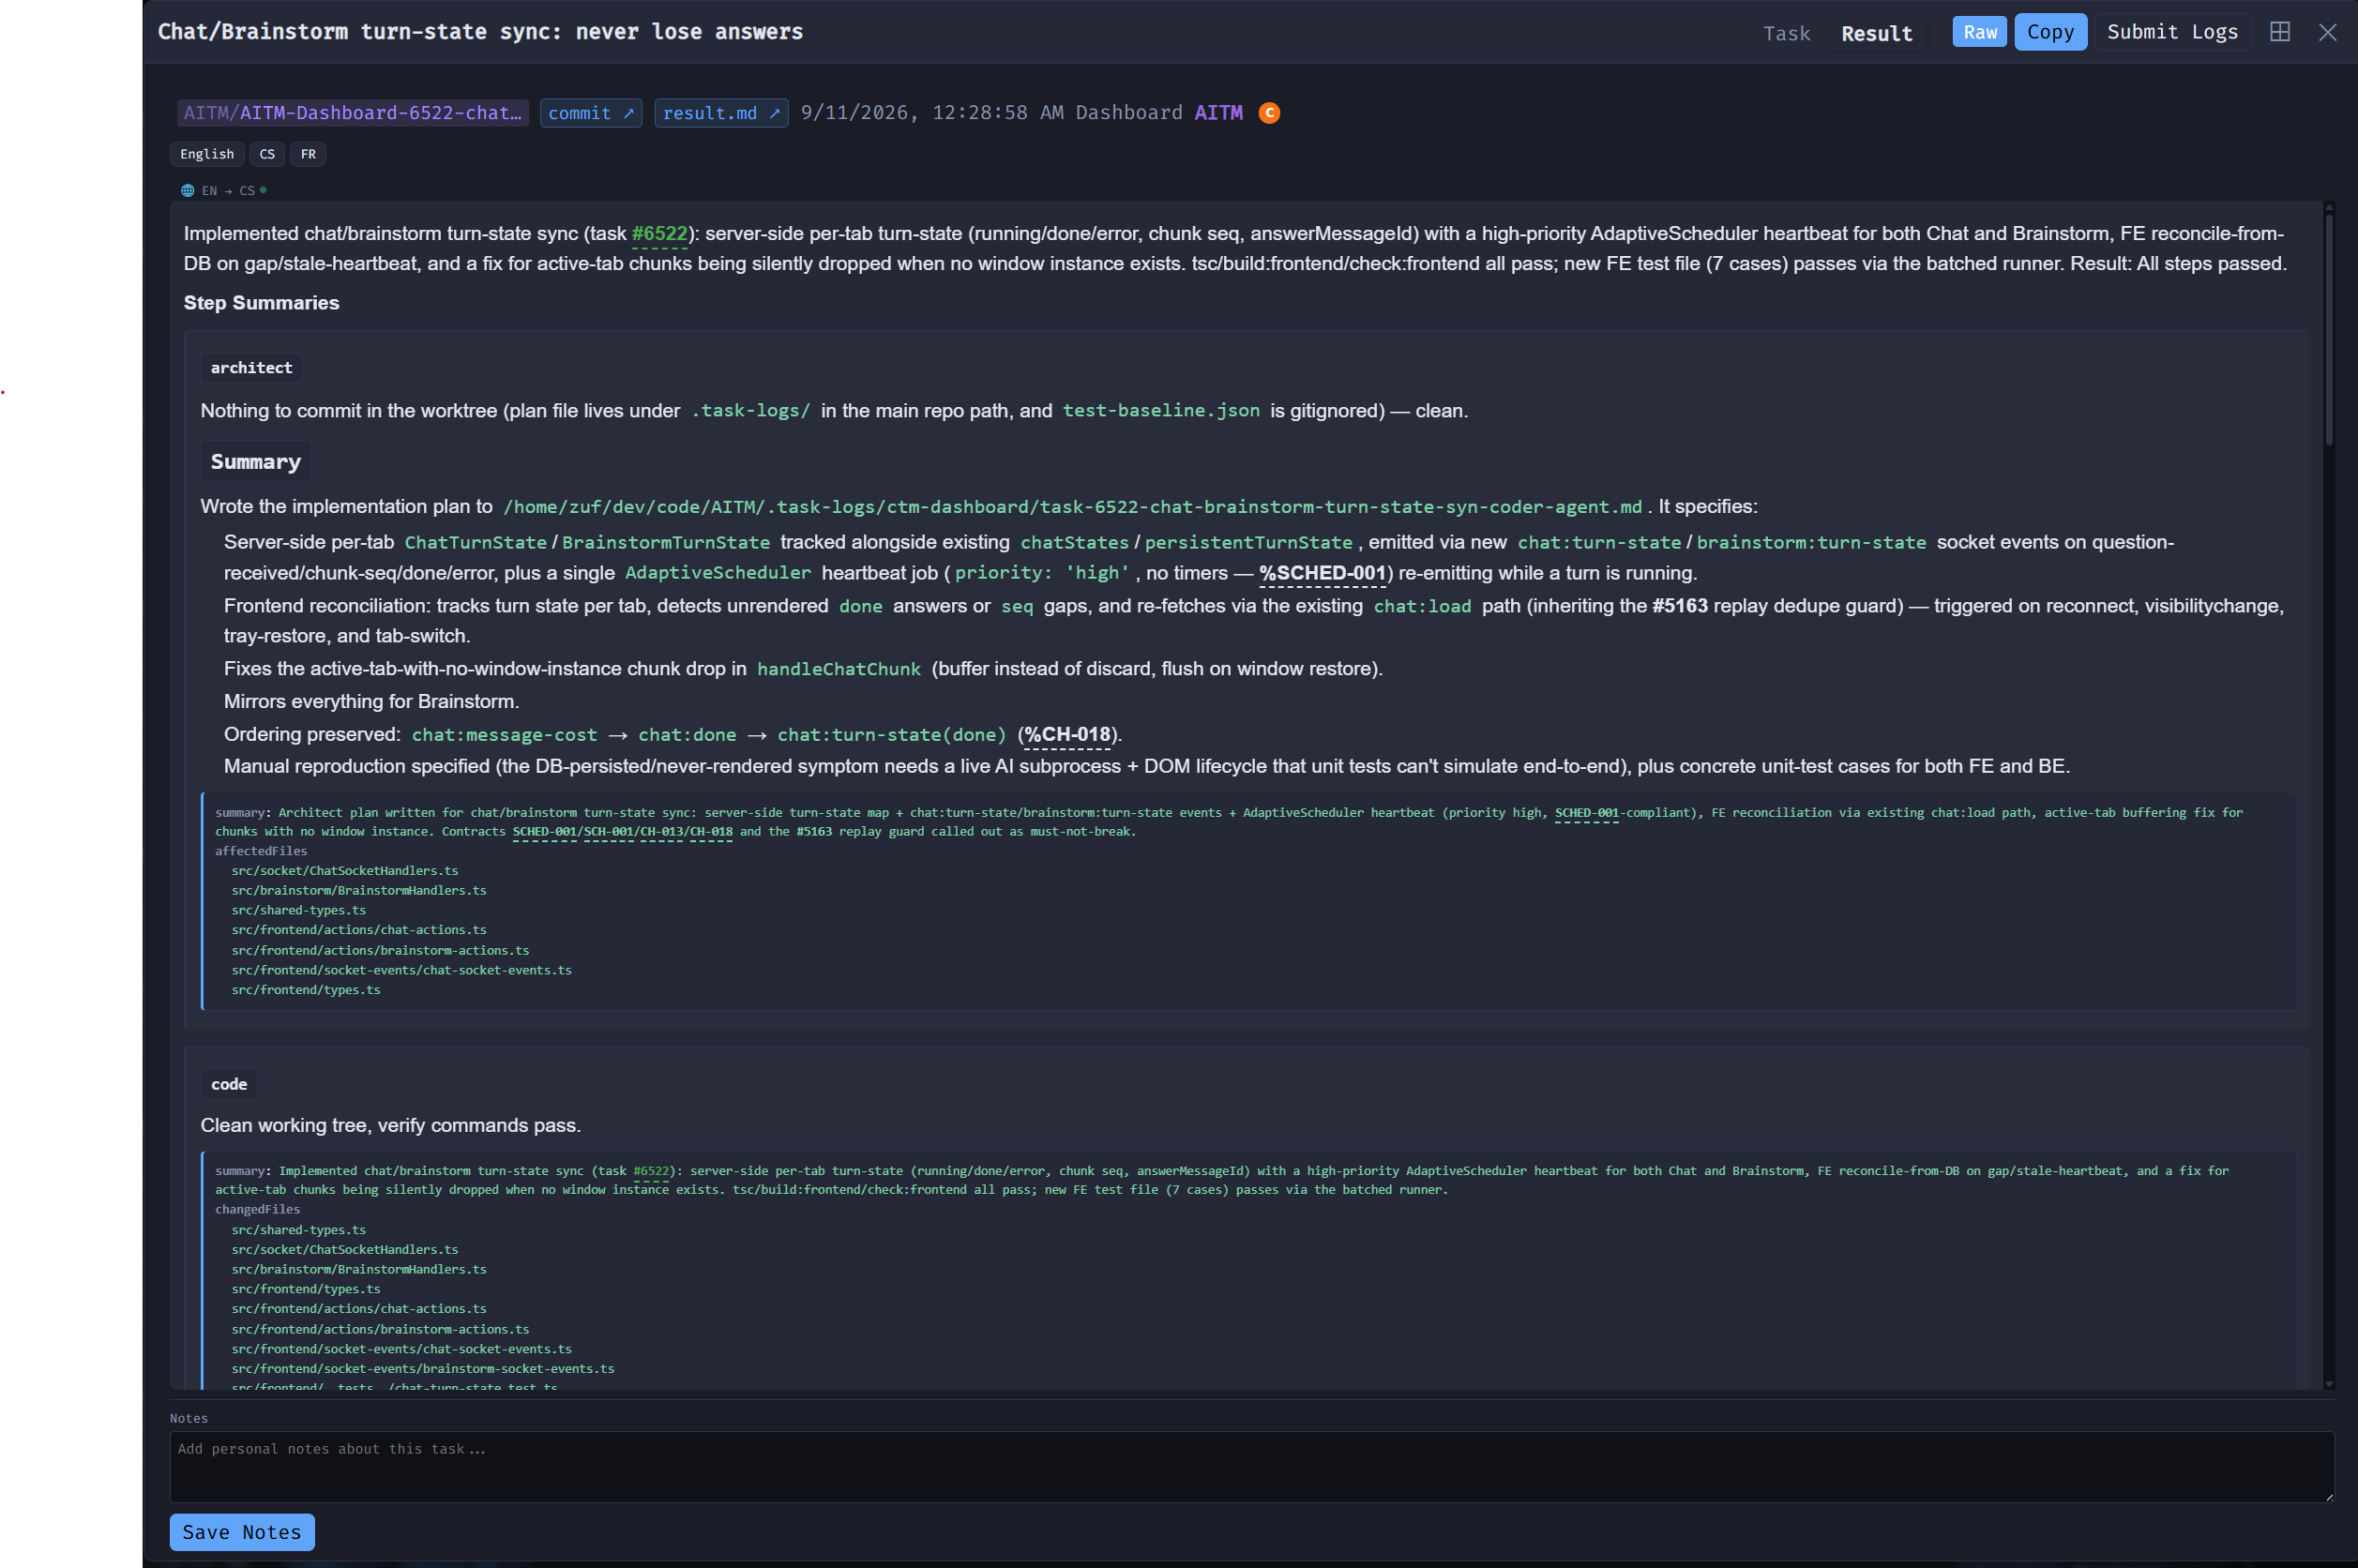
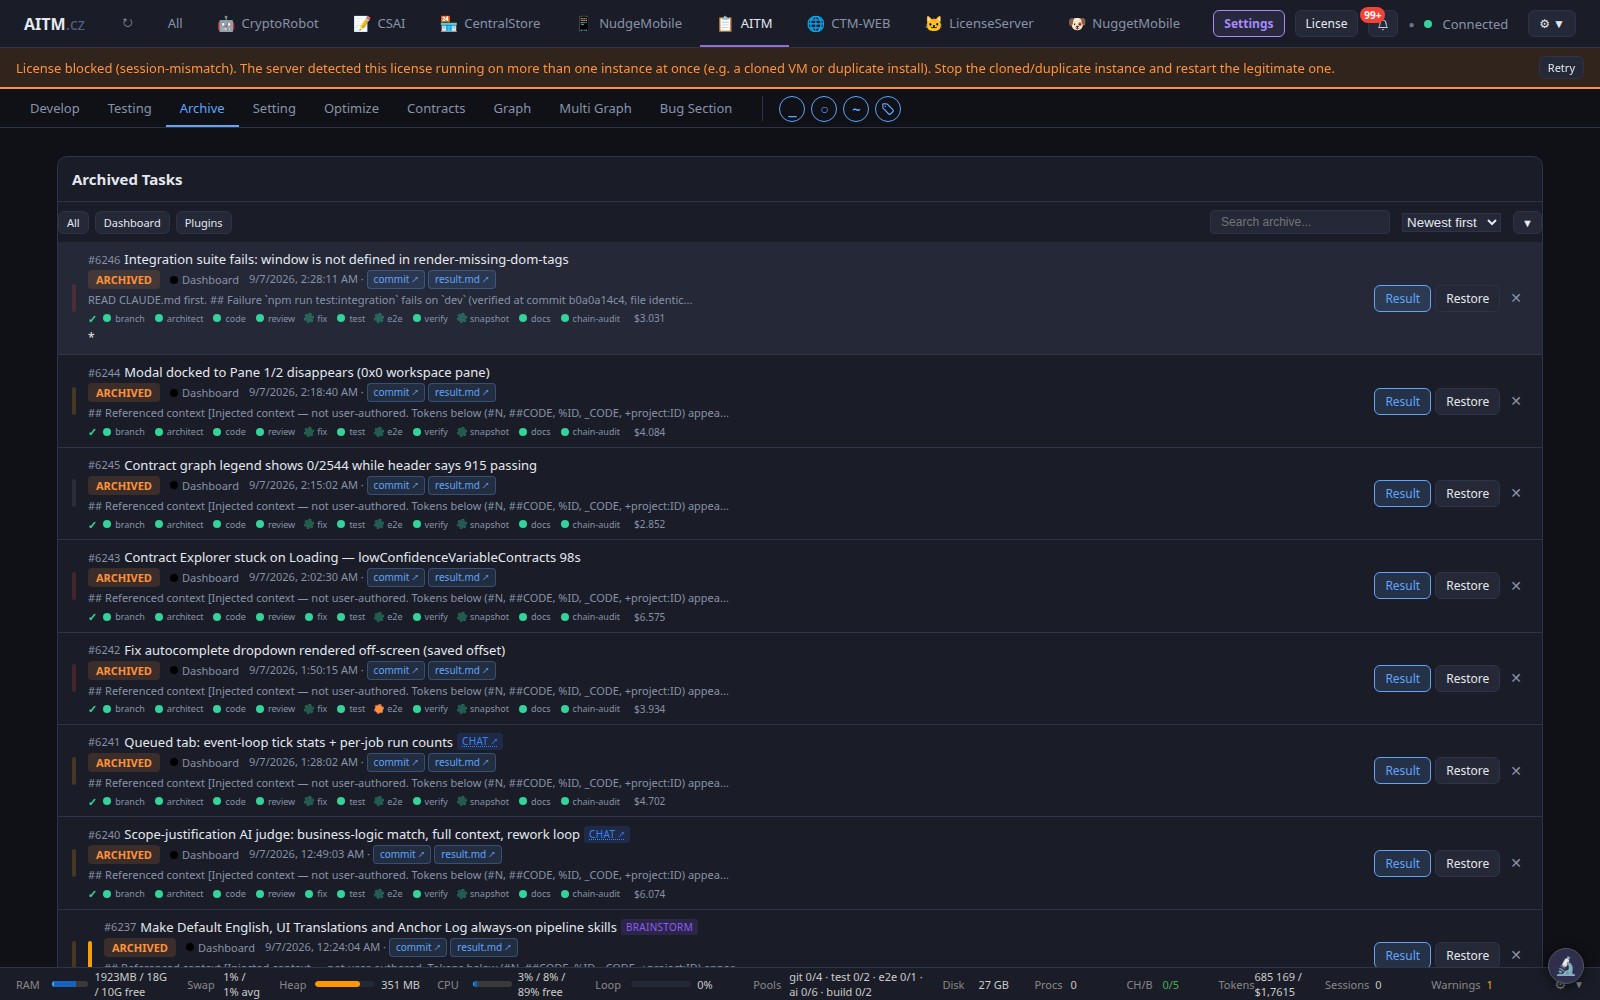
Każdy krok ma log, werdykt i uzasadnienie. Zawsze możesz prześledzić, kto o co poprosił, co zmieniła AI i dlaczego zmiana przeszła.
AI, która zna Twój projekt
AITM nie pozwala AI czytać repozytorium na ślepo. Kontrakty, mapa UI i graf wiedzy są wstrzykiwane do każdego zadania, więc edytuje właściwe miejsce. Architekt, programista, recenzent i agent poprawek działają w jednym przebiegu; czytasz wynik, a nie czat. Kolejka scalania rozwiązuje konflikty za Ciebie.
Dostawa, której możesz ufać
Każda zmiana jest sprawdzona, przetestowana, udokumentowana i możliwa do prześledzenia. Rozwój trwa całą dobę, a pipeline naprawia się sam zamiast czekać na człowieka. Koszt kontrolujesz, wybierając model dla każdego kroku. Bezpieczeństwo jest częścią projektu, a nie dodatkiem.
Ty decydujesz CO. AITM zajmuje się JAK.
Dlaczego AITaskManager?
Wszystko, co musiałbyś robić ręcznie ze zwykłym narzędziem AI do kodowania, zautomatyzowane.
Koniec z terminalem
Branch, architect, code, compliance-check, review, fix, test, e2e, verify, snapshot, docs, chain-audit: jeden pipeline wykonuje każdy krok za Ciebie, a potem scala wynik do dev. Pomiń dowolny krok lub wznów po błędzie.
Najlepsza AI do każdego zadania
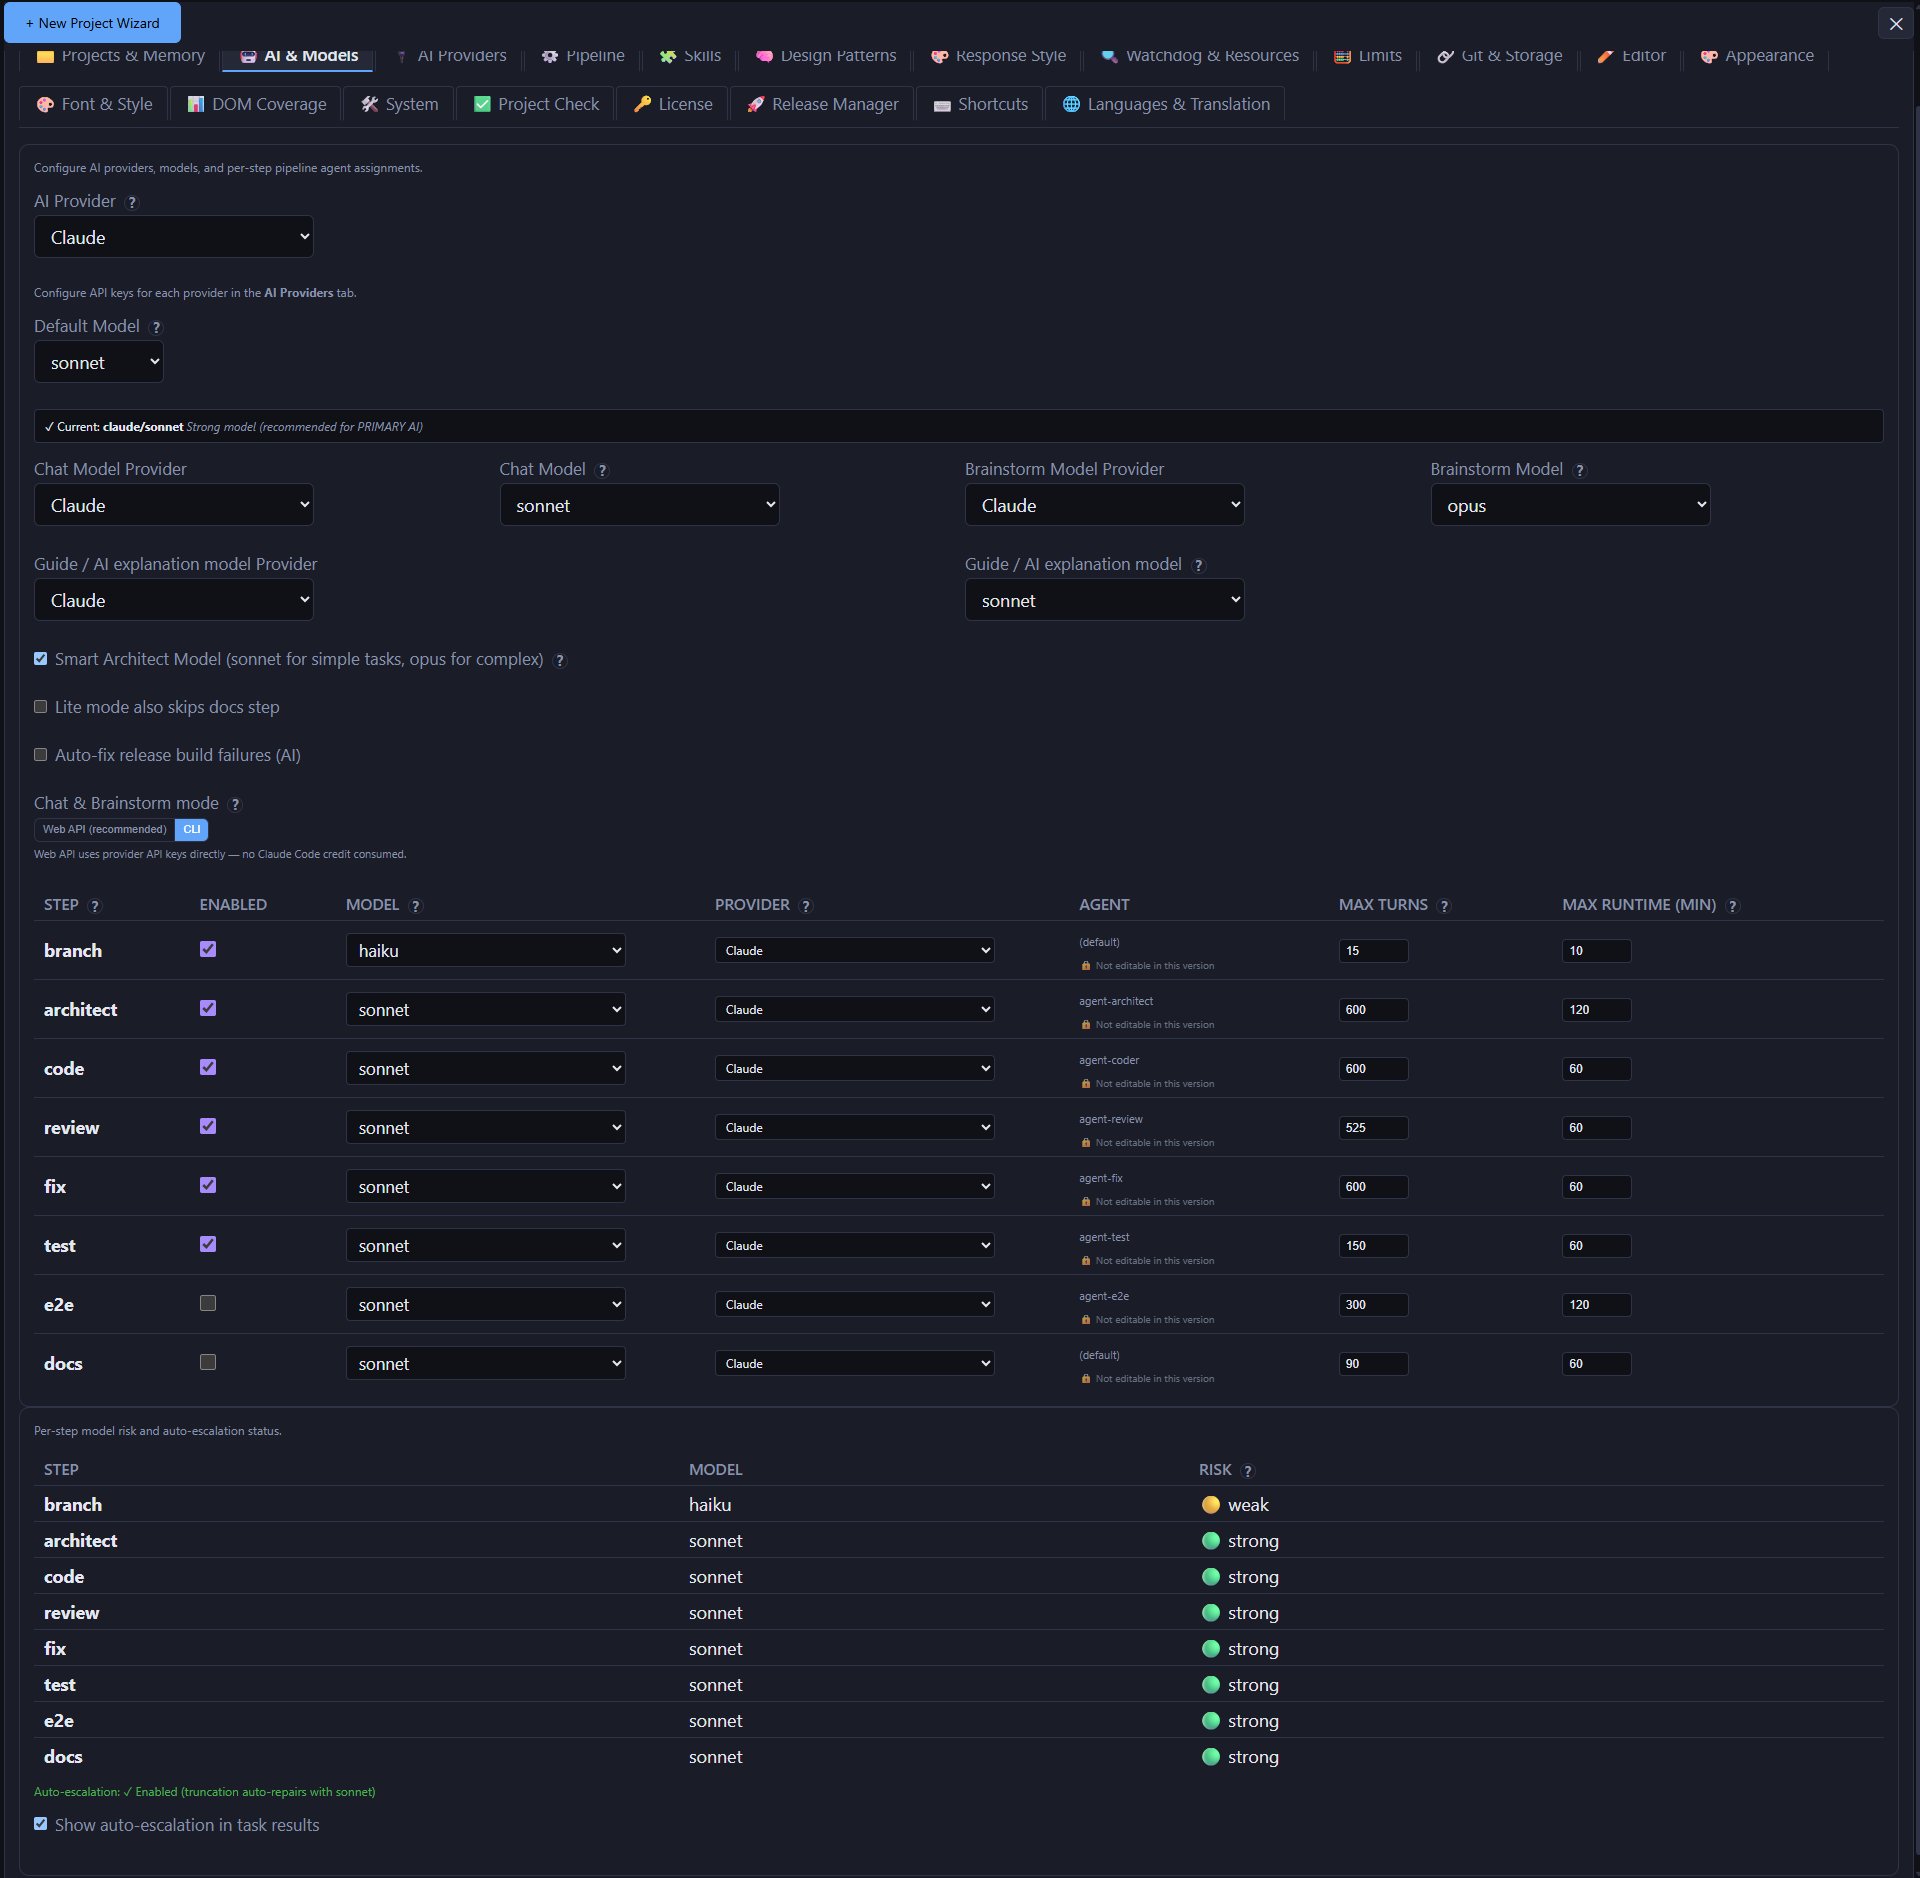
Claude do kodu, Gemini lub OpenAI do review, DeepSeek lub modele hostowane przez NVIDIA do testów, lokalny model Ollama do kroków mechanicznych: wybieraj dostawcę i model niezależnie dla każdego kroku pipeline i tnij koszty bez utraty jakości.
Koniec ze zmyślonymi API
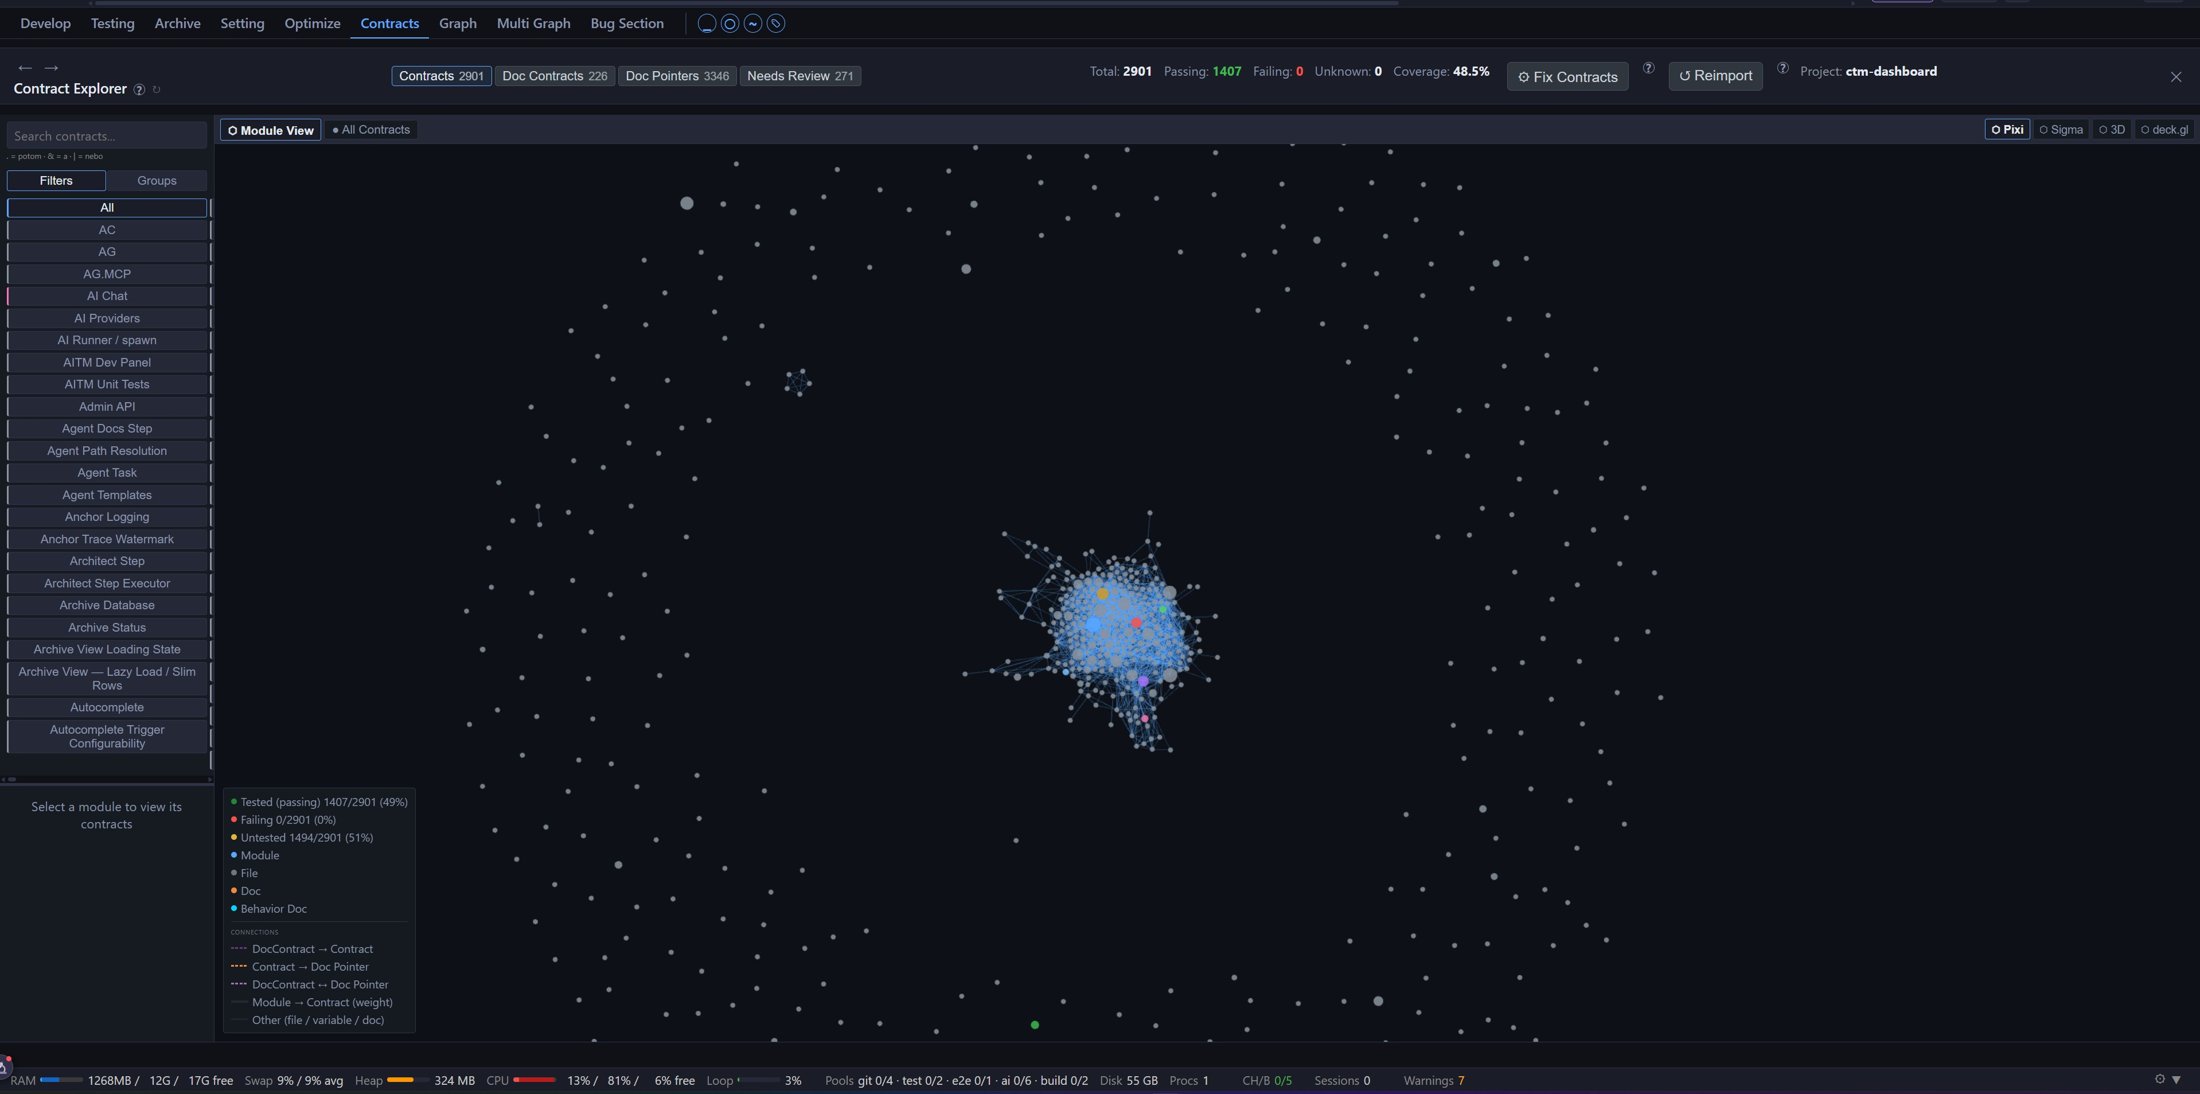
Każda funkcja to testowalny kontrakt behawioralny. AI czyta go przed kodowaniem, więc przestaje zgadywać ścieżki plików i wymyślać nieistniejące metody.
Twoja główna gałąź jest zawsze bezpieczna
Każde zadanie działa we własnym worktree i własnej gałęzi. Nic nie dotyka dev dopóki nie zostanie przetestowane i sprawdzone.
Wdrażaj bez ręcznego testowania
Testy jednostkowe i Playwright E2E uruchamiają się automatycznie przy każdym zadaniu, a opcjonalny krok snapshot może zapisać zrzuty ekranu, by łatwiej dostrzec awarie interfejsu.
Zobacz dokładnie, jak wygląda Twój kod
Interaktywny graf zależności pokazuje społeczności plików, węzły-bogów i relacje importu, bez zgadywania, czego dotyka dany plik.
Zamień rozmowę w zadanie jednym kliknięciem
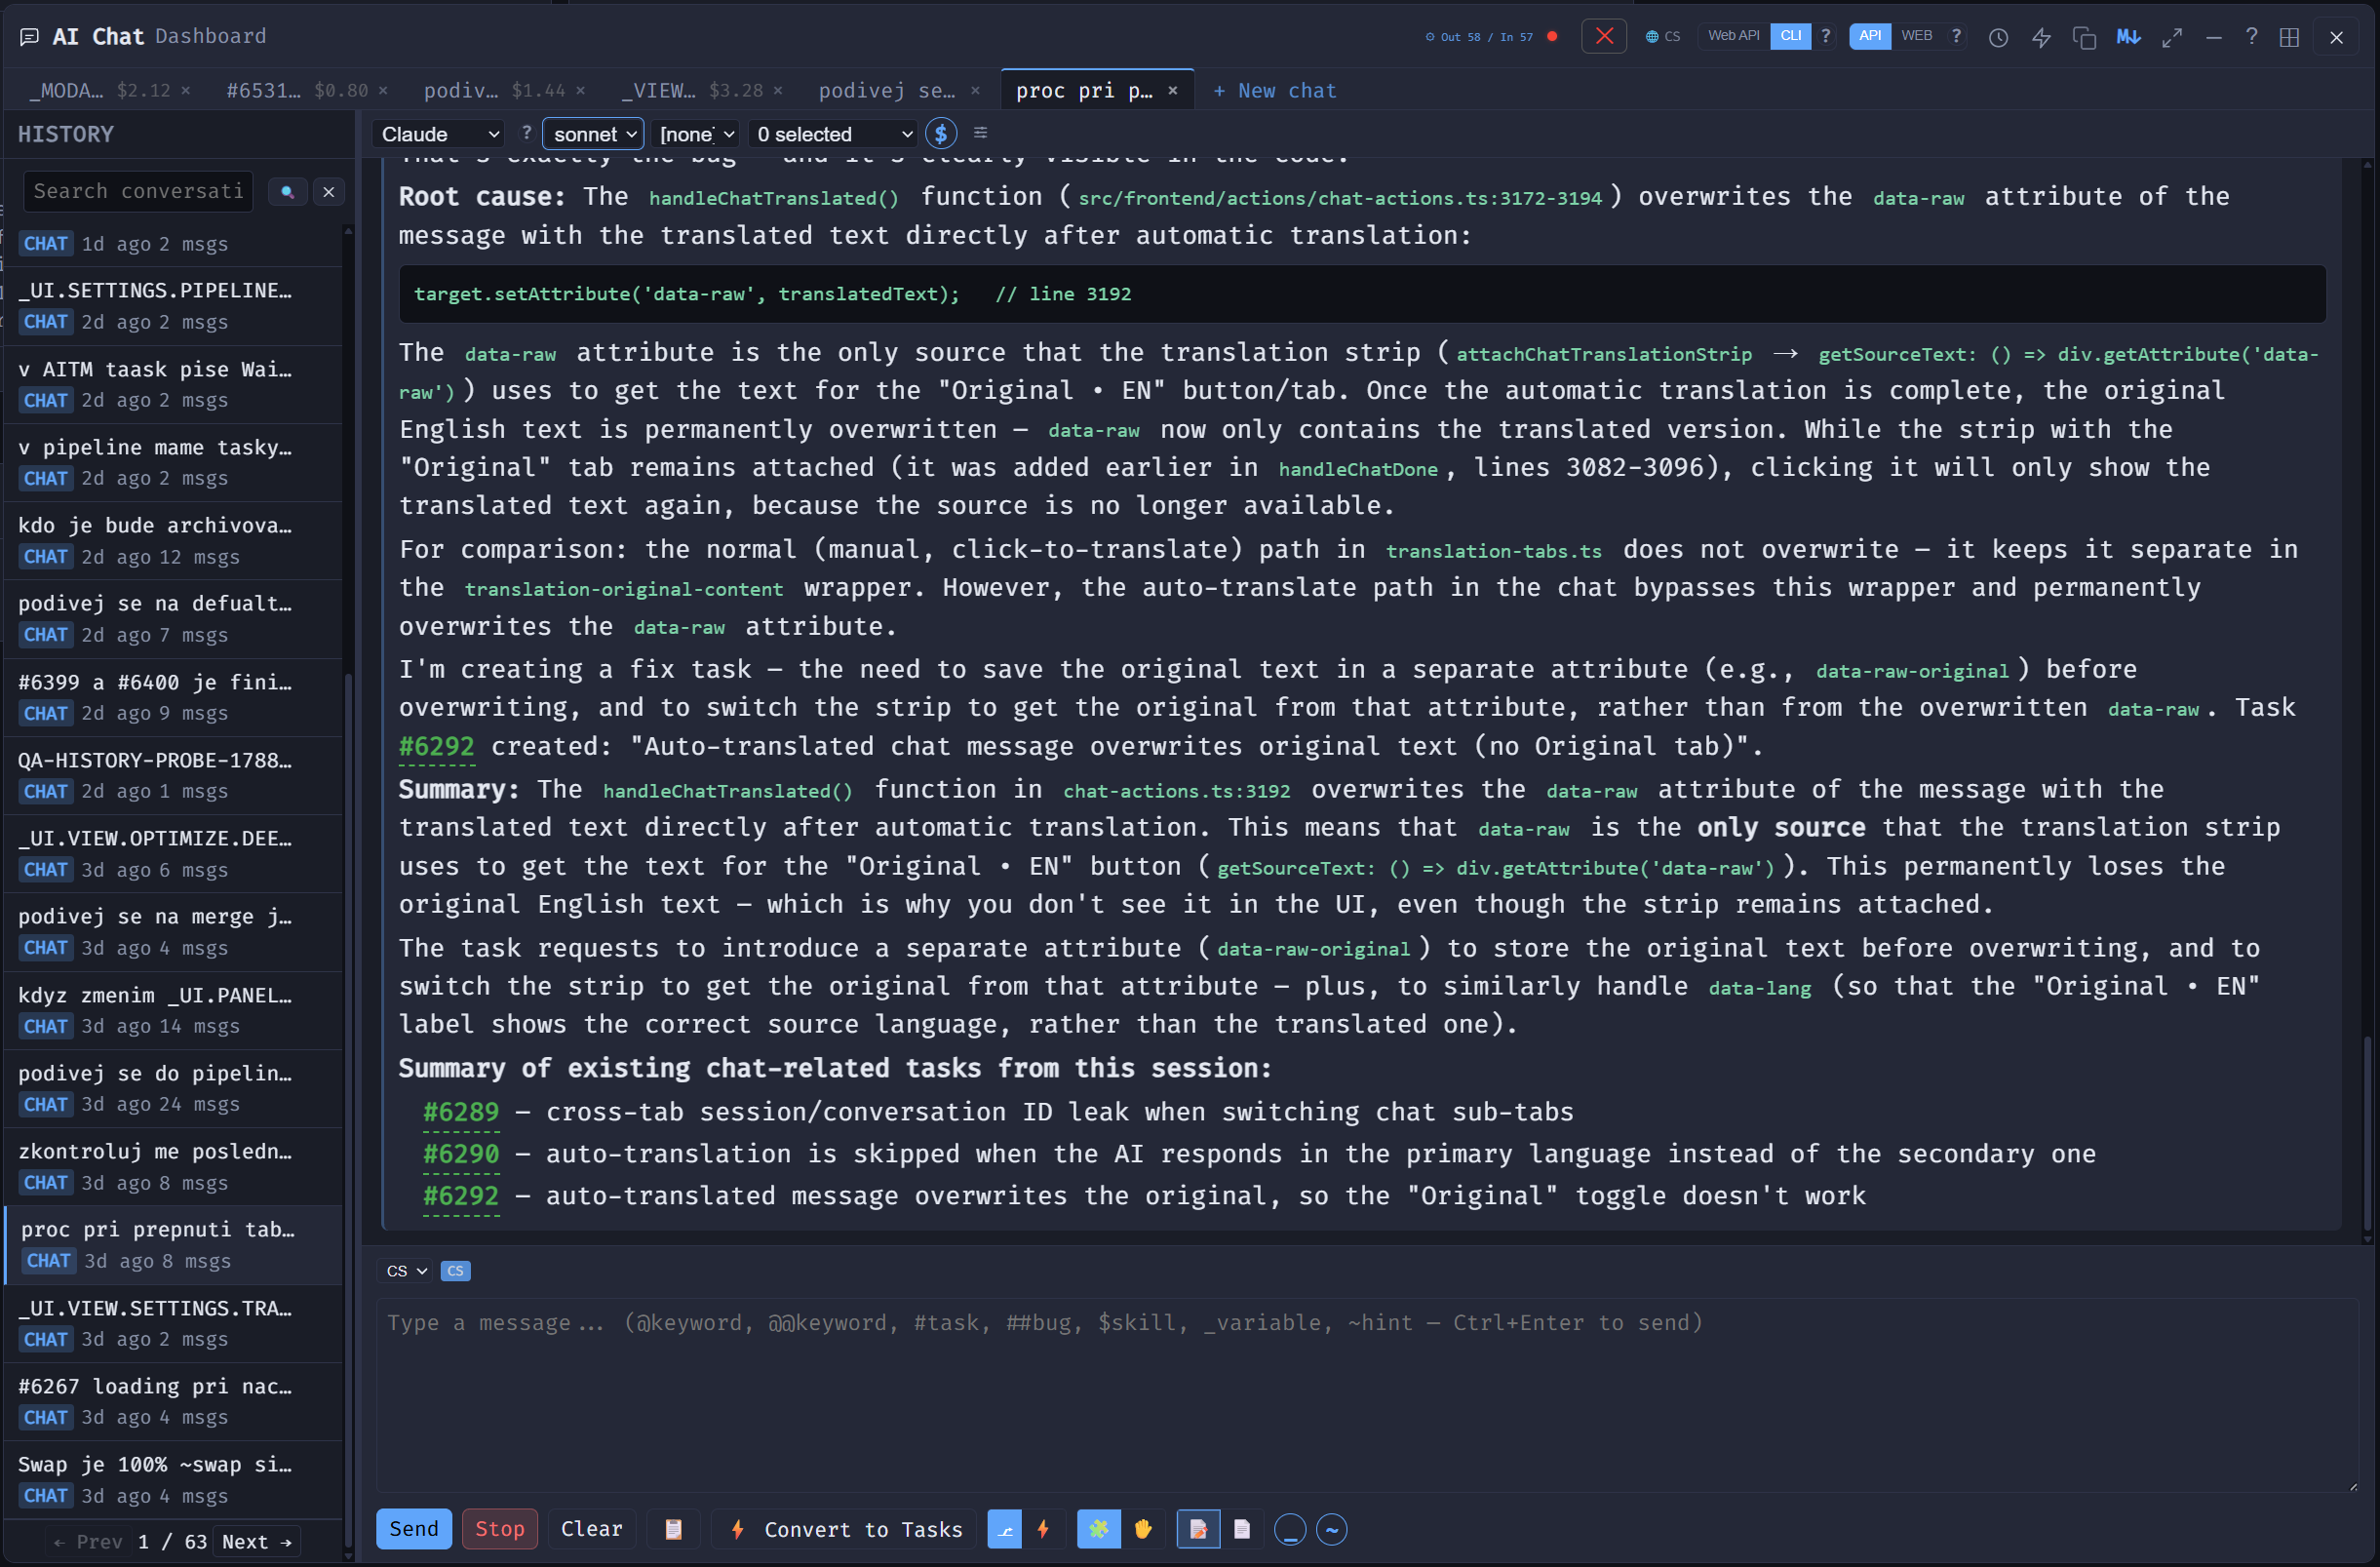
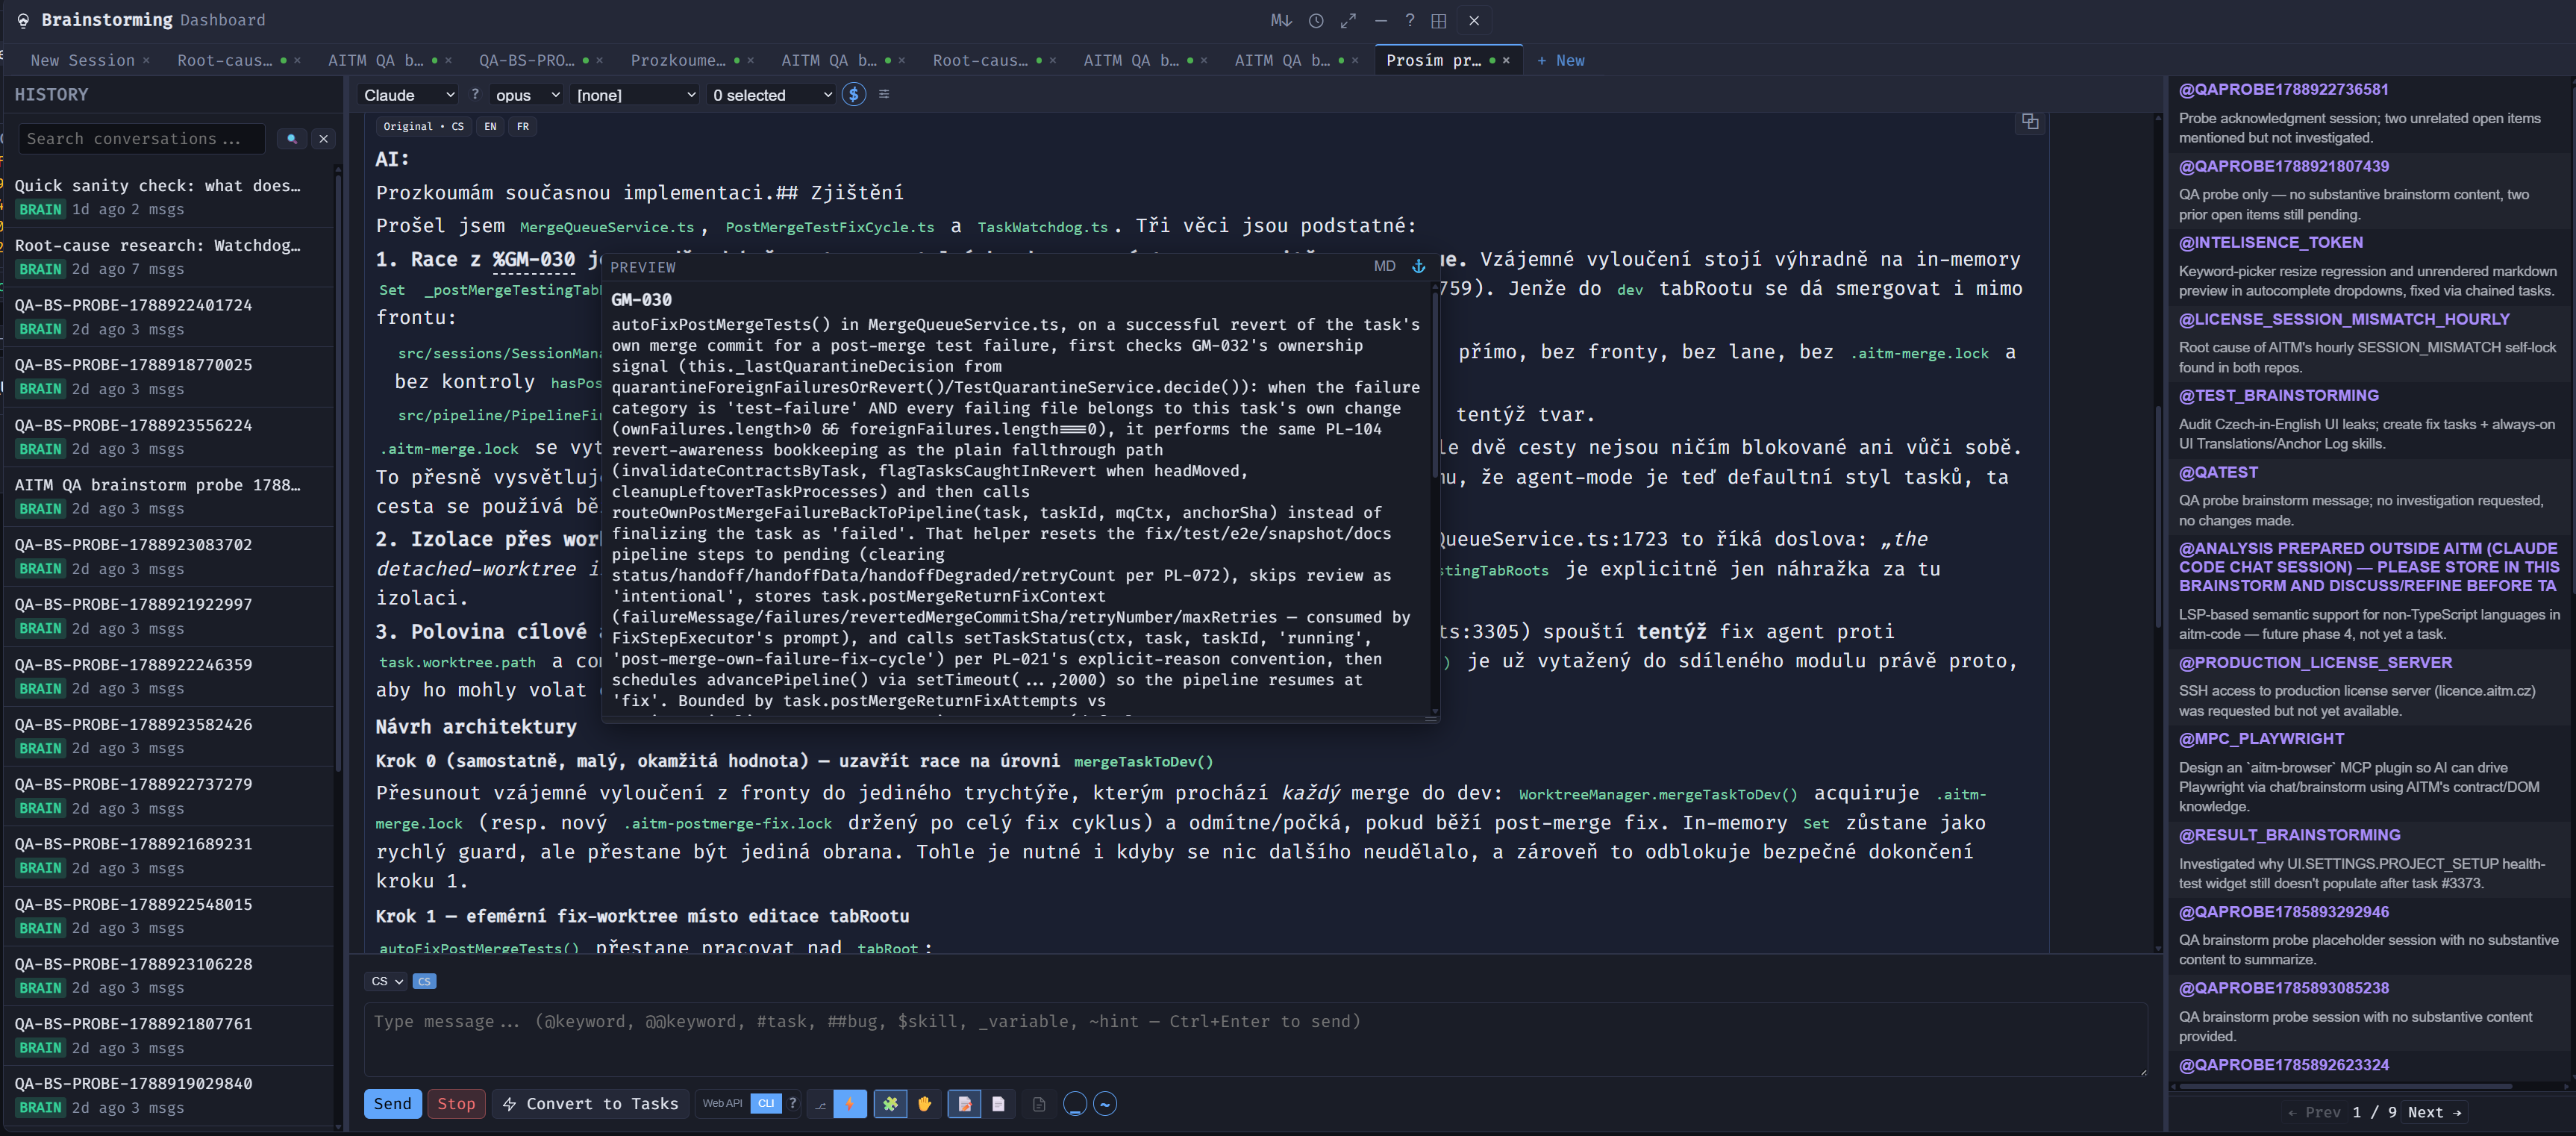
Rozmawiaj z pełnym kontekstem projektu, przeprowadź burzę mózgów nad podejściem, a potem wyślij je prosto do kolejki.
Sam się naprawia, żebyś nie musiał
Watchdog w tle wychwytuje zablokowane zadania i procesy-zombie oraz automatycznie restartuje nieudane kroki.
Twoja AI uczy się wzorców Twojego kodu
Podpowiedzi wielokrotnego użytku wstrzykują konwencje projektu do każdego promptu: wpisz ~hint aby natychmiast uzyskać kontekst.
Zarządzaj wszystkimi projektami z jednego ekranu
Przełączaj kontekst natychmiast, kolejkuj zadania w różnych projektach i śledź postępy wszędzie naraz.
Obserwuj pracę AI w czasie rzeczywistym
Pełna przejrzystość każdego polecenia, zmiany pliku i decyzji w momencie, gdy się dzieje.
Kolejkuj wieczorem, rano miej scalone funkcje
Zakolejkuj 20 zadań przed snem z priorytetami i zależnościami. AITM wykona je po kolei, gdy śpisz.
AITM uczy się Twojego projektu
Im dłużej AITM pracuje nad Twoim kodem, tym mniej musi odkrywać od nowa za każdym razem.
Kontrakty behawioralne opisują, co robi Twój kod: są sprawdzane przed każdą edycją i synchronizowane po każdym scaleniu.
Graf wiedzy łączy zmienne, kontrakty, elementy DOM, testy i dokumentację w jednym zapytaniu.
Zaimportuj repozytorium, a AITM zmapuje jego stos, kod i interfejs, zanim uruchomi się pierwsze zadanie.
Wspólne szablony agentów i ustrukturyzowane przekazania sprawiają, że każda sesja AI i każdy dostawca są na tym samym etapie.
Jakie modele AI napędzają AITM
AITM to warstwa rozszerzeń, a nie model: orkiestruje wybraną przez Ciebie AI.
Model wybierasz Ty
AITM wymaga płatnego zewnętrznego modelu AI (Claude, OpenAI lub DeepSeek) albo samodzielnie hostowanego modelu lokalnego. Modele lokalne nie osiągają jeszcze jakości kodowania, jakiej wymaga pipeline AITM, więc lepiej nadają się do lżejszych zadań. Claude Sonnet na low to najczęściej używany i najlepszy wybór do kodowania, review i fix. Fable bywa używany do planowania zadań i burzy mózgów. Z OpenAI i DeepSeek używany jest tylko aktualnie najlepszy dostępny model.
Dlaczego mniej halucynacji
Zwykły system agentowy przy każdym zadaniu od zera domyśla się, jak zachowuje się Twój kod. AITM zamiast tego utrzymuje trwałą, stale aktualizowaną mapę projektu: kontrakty behawioralne, zmienne, mapę DOM i graf wiedzy, względem której każdy krok pipeline się weryfikuje zamiast zgadywać. Ta trafność rośnie, im dłużej AITM jest używany w projekcie, a jest niższa w świeżo zaimportowanym projekcie, w którym kontrakty dopiero powstają.
Dlaczego niższy koszt
Przewaga kosztowa AITM wynika z kierowania różnych kroków pipeline do różnych modeli w zależności od ich złożoności, w tym do tańszych modeli tam, gdzie prostszy krok nie potrzebuje modelu z najwyższej półki. To obniża koszt wykonania zadania w dolarach: jest to redukcja kosztu modelu dzięki routingowi, a nie redukcja zużycia tokenów.
Dlaczego AITM jest bardziej niezawodny niż zwykły agent AI
W porównaniu z ręcznym promptowaniem AI w oknie czatu.
Stop Babysitting Your AI. Start Shipping.
Every night you skip is a night of merged features you didn't ship. Queue your backlog now — AITM starts orchestrating the moment it launches.
v1.0.0 dostępna już teraz Pick a duration and a time that works for you — we'll send a confirmation link to your email.
Check your email
We've sent a confirmation link to your email address. Click it to confirm your call.
Jak AITM współpracuje z AI
Jak zarządzany jest rozmiar promptu i kontekst w całym pipeline.
Rozmiar promptu na krok pipeline
Każdy krok pipeline (Architect, Code, Review, Fix, Test, Docs) startuje ze skoncentrowanego promptu dla danego kroku, a nie z jednego wielkiego promptu ogólnego. Późniejsze kroki potrzebujące więcej kontekstu (jak Code) budują większy kontekst roboczy podczas eksplorowania zadania; wcześniejsze lub węższe kroki (jak Docs) pozostają stosunkowo małe. W każdym przypadku kontekst roboczy mieści się z zapasem w oknie tokenów skonfigurowanego modelu.
Ponowne użycie zamiast ponownego wysyłania
Stała część każdego promptu (rola, reguły, narzędzia) jest identyczna w każdym kroku, więc jest serwowana z pamięci podręcznej promptów dostawcy AI: zwykle dla kroku potrzeba tylko niewielkiej ilości nowych danych wejściowych, a większość kontekstu jest używana ponownie zamiast wysyłana od nowa.
Wiedza o projekcie, nie czytanie plików
AI najpierw sprawdza wiedzę o projekcie: zmienne, kontrakty logiki biznesowej, mapę UI, a dopiero potem kod, przed czytaniem plików, więc każdy krok opiera się na zweryfikowanych faktach o projekcie.
Dostrojone do modelu AI
| Dostawca | Okno kontekstu |
|---|---|
| Claude | 200K |
| Gemini | 1M |
| OpenAI | 128K |
| NVIDIA | 128K |
| DeepSeek | 64K |
| Lokalny Ollama (domyślnie) | 8K |
Modele z mniejszymi oknami kontekstu lub słabszym rozumowaniem dostają bardziej zwartą wersję promptu, która nadal zawiera te same reguły pracy, więc nawet model lokalny postępuje według tego samego procesu.
Jeden system: GUI, pipeline, dane i kontrakty
AITM nie zastępuje Claude Code, Cursor ani Twojego ulubionego narzędzia AI do kodowania, tylko je orkiestruje. Wskaż te same modele, których już używasz, a AITM doda wokół nich pipeline, siatkę bezpieczeństwa i pamięć projektu.
Warstwa wizualna, którą naprawdę widzisz
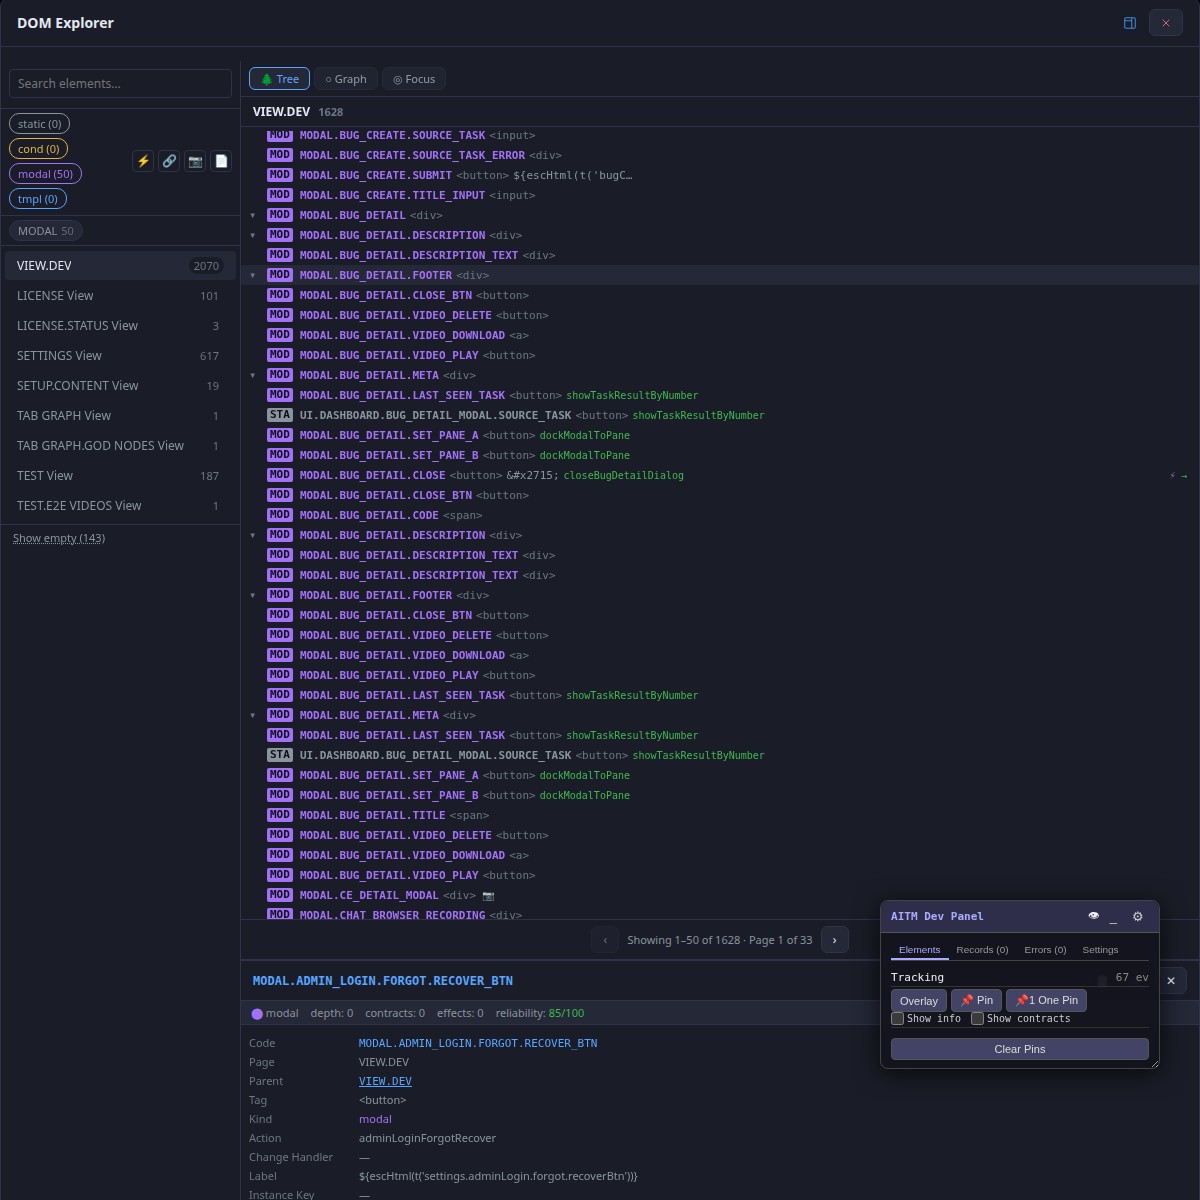
Dashboard na żywo pokazuje każdy projekt, działający pipeline i zadanie w kolejce w czasie rzeczywistym. DOM Explorer mapuje każdy element interfejsu na jego data-aitm kod, a historia zrzutów ekranu zapisuje wizualnie, jak każdy ekran zmieniał się w czasie.
Pipeline, a nie okno czatu
Jeden prompt uruchamia pełny 12-krokowy pipeline: branch → architect → code → compliance-check → review → fix → test → e2e → verify → snapshot → docs → chain-audit, a potem kolejka scalania scala zmianę do dev. Każde zadanie dostaje własny izolowany git worktree, więc Twoja główna gałąź nigdy nie jest dotykana w trakcie, a watchdog wykrywa zawieszone kroki i automatycznie je ponawia.
Wszystko jest zapisane, nic nie jest zgadywane
Każdy projekt ma własną bazę danych z kontraktami behawioralnymi i historią zadań. Globalna baza przechowuje ustawienia, podpowiedzi i rejestr zmiennych współdzielony między projektami. Każde zadanie ma własny folder logów i zarchiwizowany wynik, więc zawsze możesz wrócić do dowolnego uruchomienia.
Ścisły podział danych między projektami
Dane jednego projektu nigdy nie mieszają się z danymi innego, bo każdy projekt ma osobny plik bazy danych. Praca w toku zostaje w swoim worktree, dopóki nie zostanie sprawdzona, przetestowana i scalona, więc nic niedokończonego nie trafia do głównej gałęzi.
Dane, logika biznesowa i GUI są powiązane
Każdy element interfejsu ma data-aitm kod powiązany z kontraktem behawioralnym, który opisuje oczekiwane zachowanie i wskazuje dokładny plik źródłowy oraz zmienną w kodzie. Agenci AI czytają tę zweryfikowaną specyfikację zamiast zgadywać intencje z surowego kodu.