Entregar código con IA requiere disciplina
Sin la configuración adecuada, programar con IA conlleva riesgos reales: ¿cómo se configura la IA y sus agentes para que nunca rompan la lógica y la estructura que ya funcionan? El pipeline de AITM está diseñado justo para ese problema.
Calidad del prompt y pasos más pequeños
Cuanto más precisamente se describe un requisito, mejor lo ejecuta la IA. Dividir el trabajo en partes más pequeñas y verificadas de forma independiente supera de forma constante a un único prompt gigante.
Menos alucinaciones
Un agente de IA simple tiende a elegir la respuesta que suena más cercana en lugar de la que el negocio realmente necesita. Inyectar la lógica de negocio y restricciones explícitas de no romper nada en el prompt, y no solo probar después, es lo que lo mantiene en el camino correcto.
Verificación que acota el radio de impacto
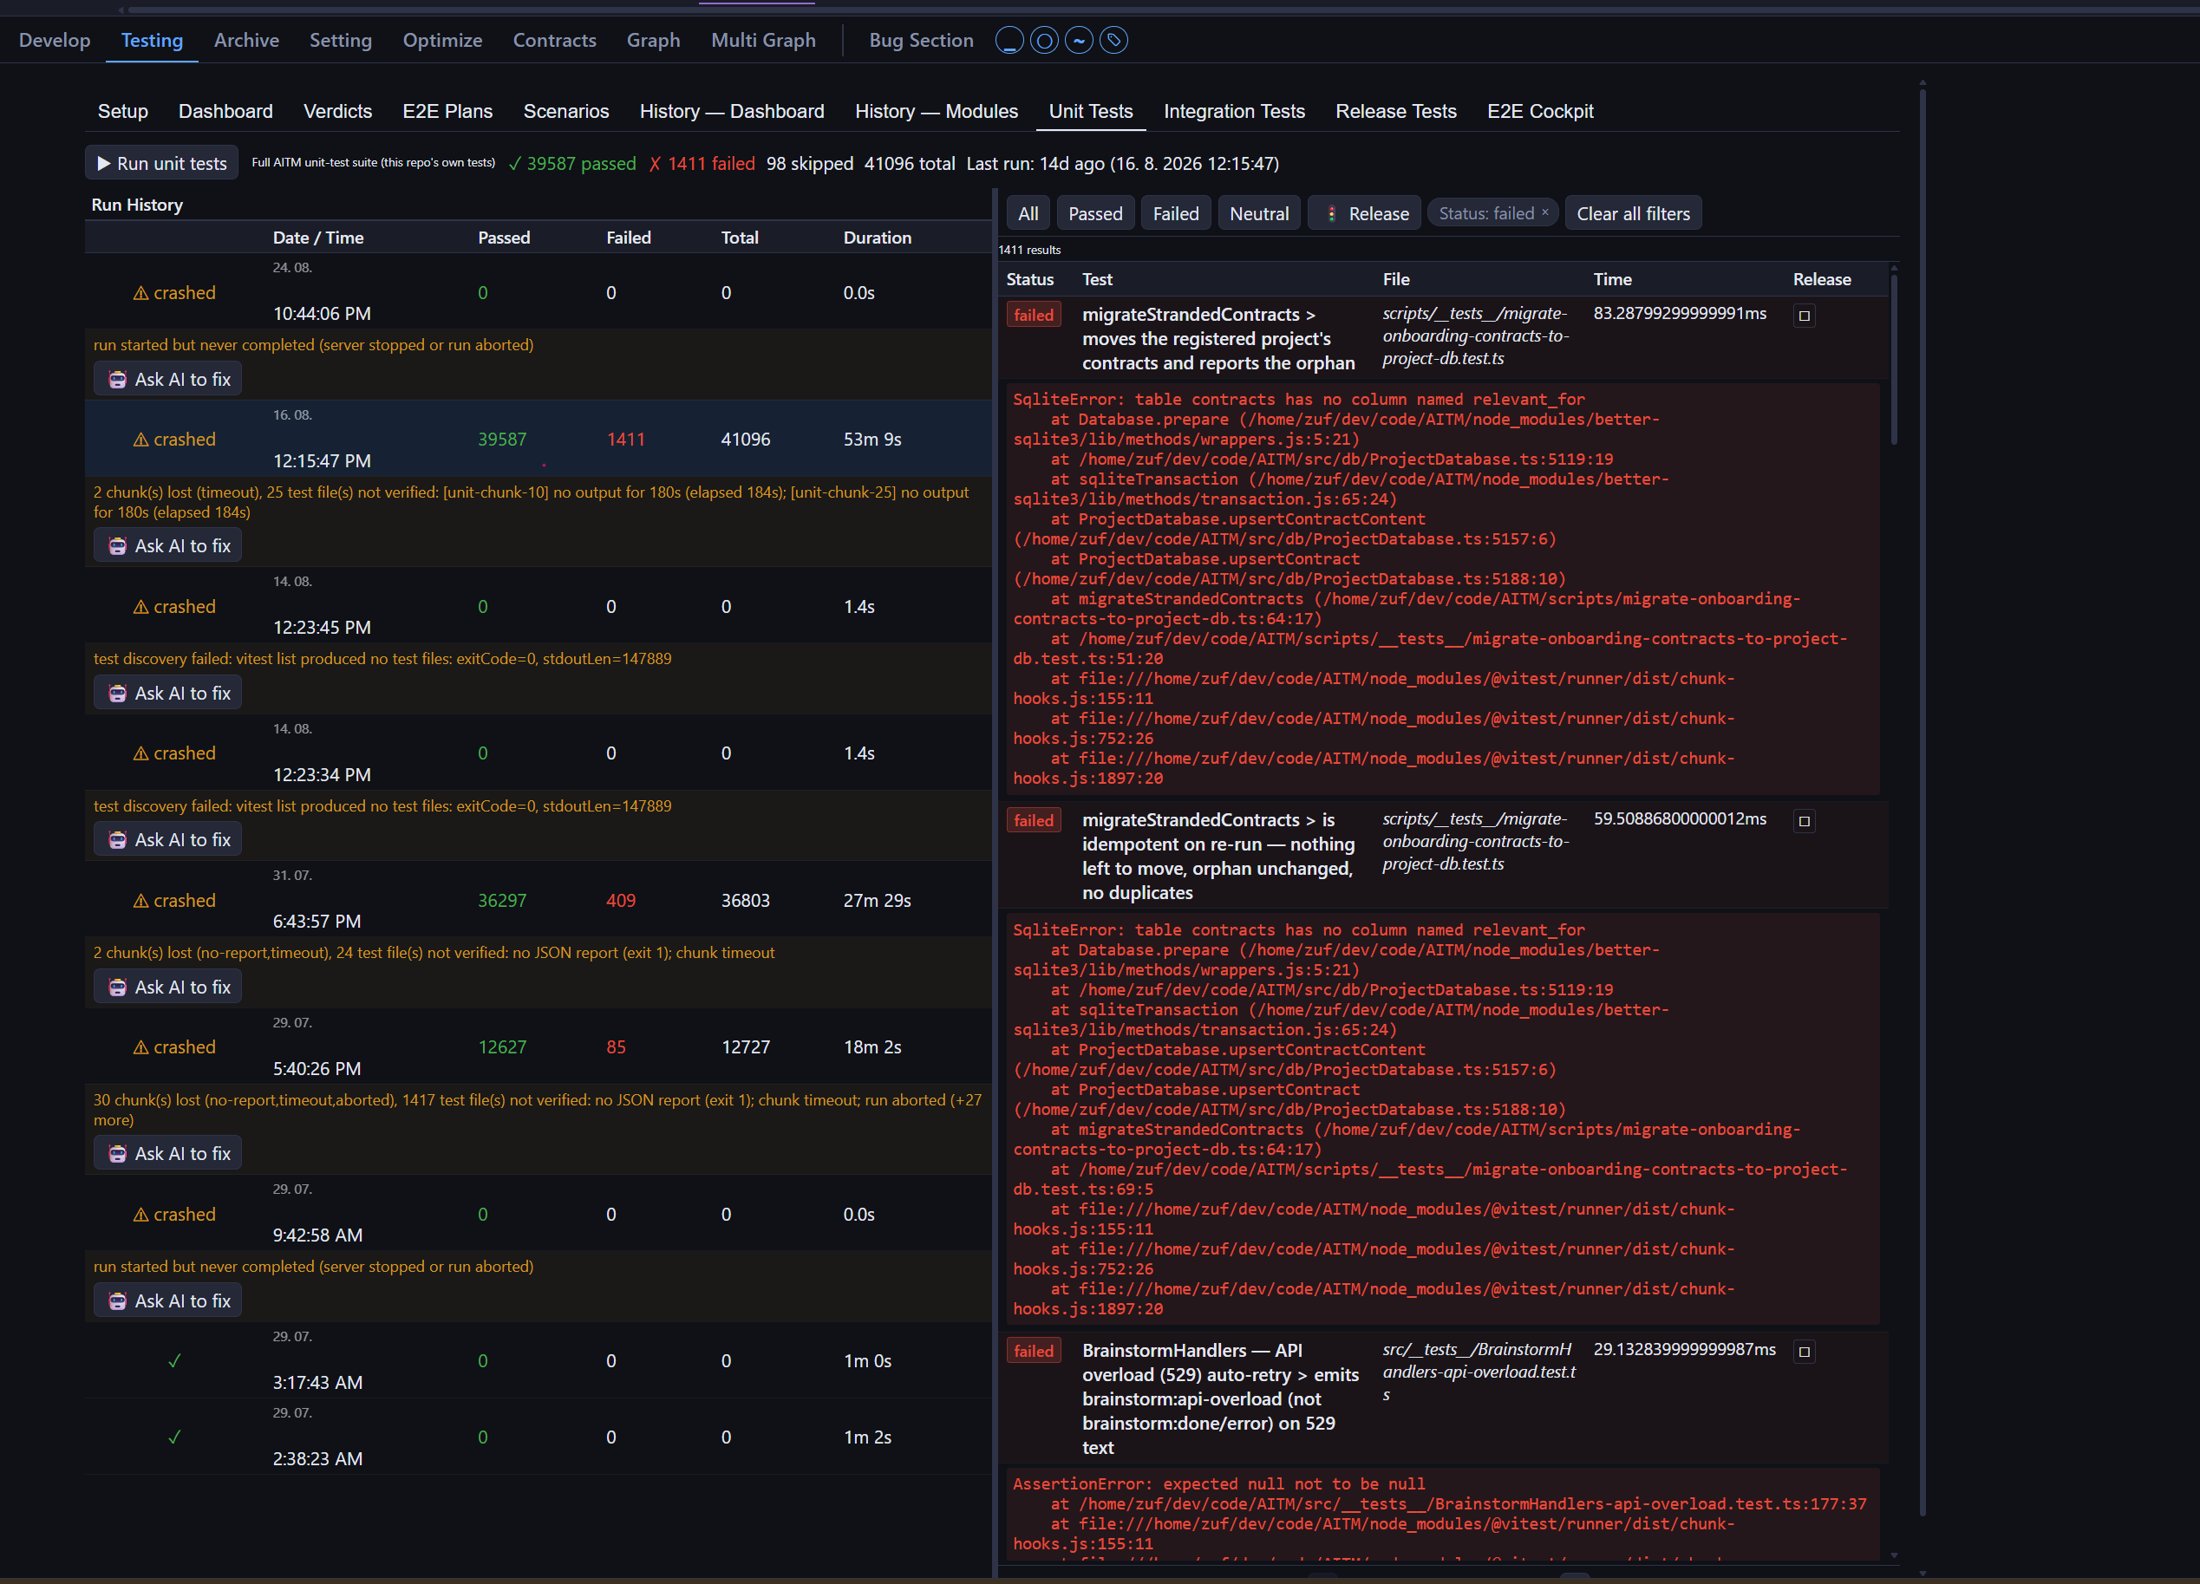
Las pruebas unitarias, de integración y de extremo a extremo demuestran que un cambio no rompió nada fuera de su propia tarea.
Contexto antes de cambiar una sola línea
El paso architect lee contratos, elementos DOM y cadenas de comportamiento antes de empezar a programar, de modo que el prompt generado se adapta para evitar los lugares que no deben cambiar. Además, cada tarea (Bug, Feature o Enhancement) se verifica de forma distinta, por diseño, según el tipo de riesgo que conlleva.
AITM lo utilizan equipos de desarrollo y desarrolladores independientes que quieren delegar la programación rutinaria en agentes de IA mientras se centran en la arquitectura y las decisiones. Resuelve el caos de las tareas paralelas, la pérdida de contexto entre conversaciones y la necesidad de revisar manualmente cada cambio de código. Necesitan una herramienta que garantice aislamiento mediante worktree, pruebas automatizadas y un historial auditable, sin sacrificar la velocidad de desarrollo. AITM les da la confianza de que el código generado por IA pasa por la misma disciplina que el escrito por humanos, ahorrándoles horas cada día.
 Del prompt al código fusionado: totalmente automatizado
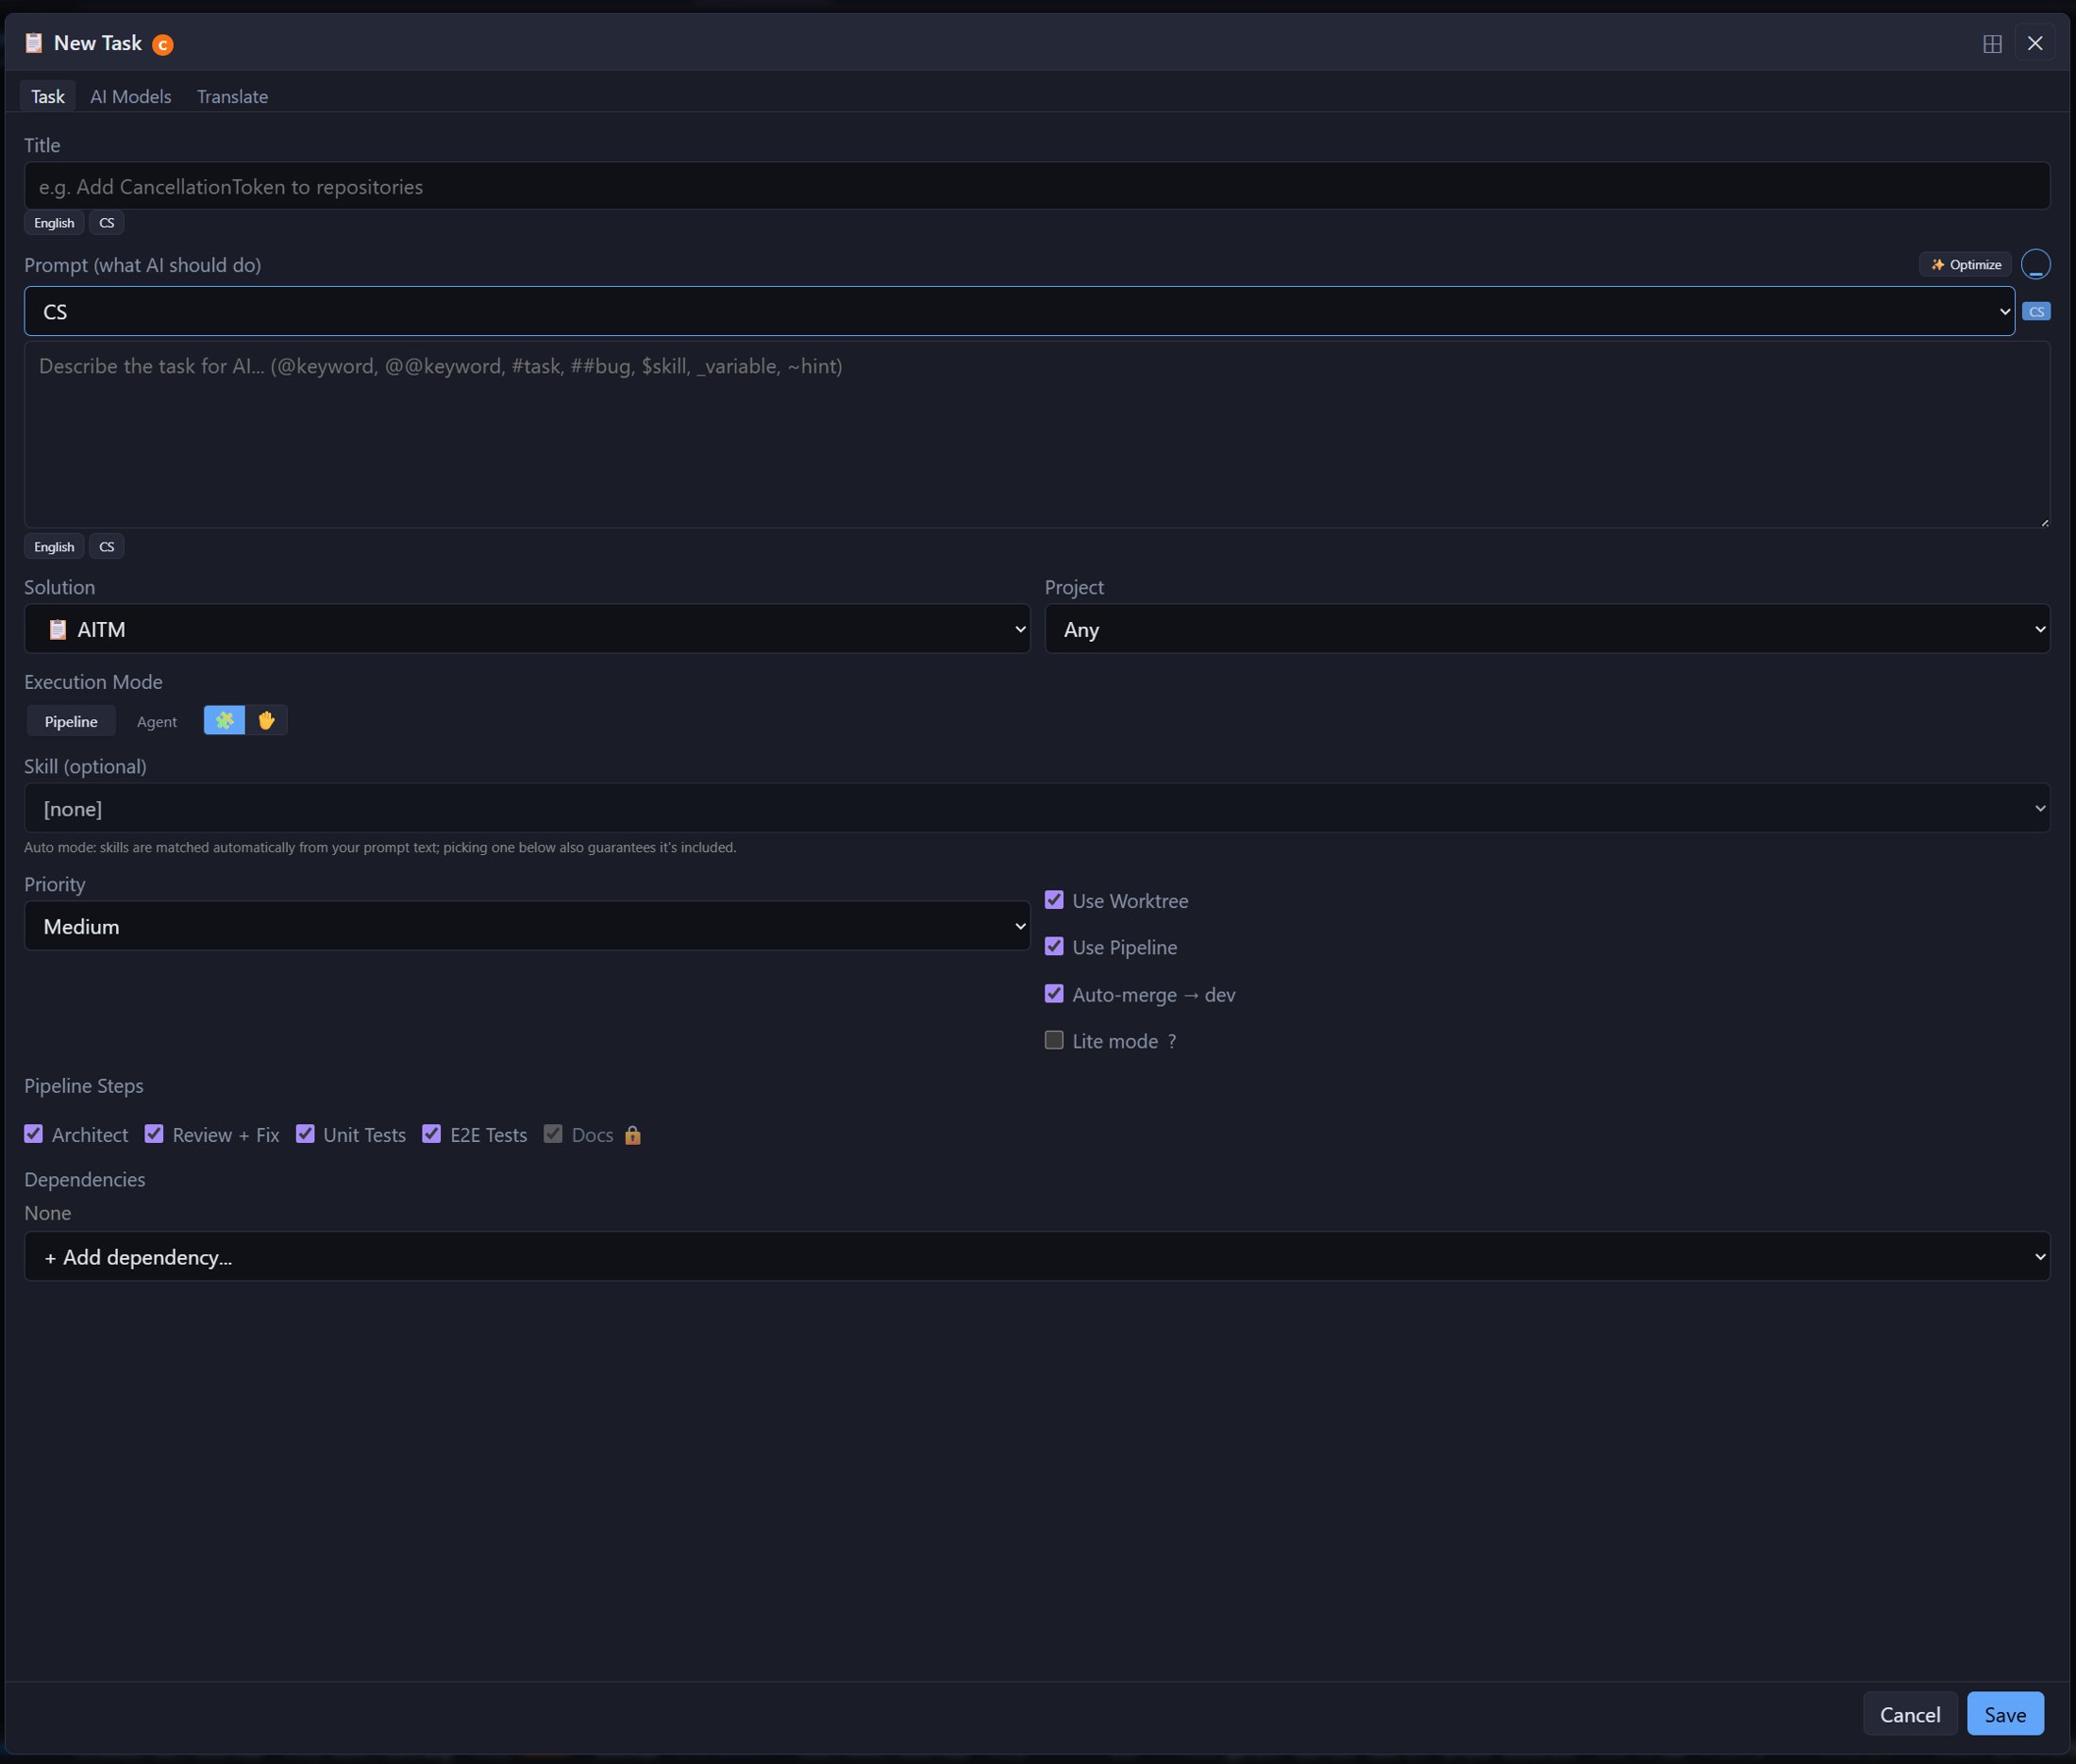
Submit a Task.
Ship Tested, Merged Code.
Describe what you need once. AITM designs the approach, writes the code, reviews it, fixes what's broken, tests it end-to-end, updates the docs, and merges it into your dev integration branch — without you touching a keyboard again until it's done.
 v1.0.0 ya disponible
AITaskManager en acción
Haga clic en cualquier pestaña para explorar. Haga clic en la imagen para ampliarla.
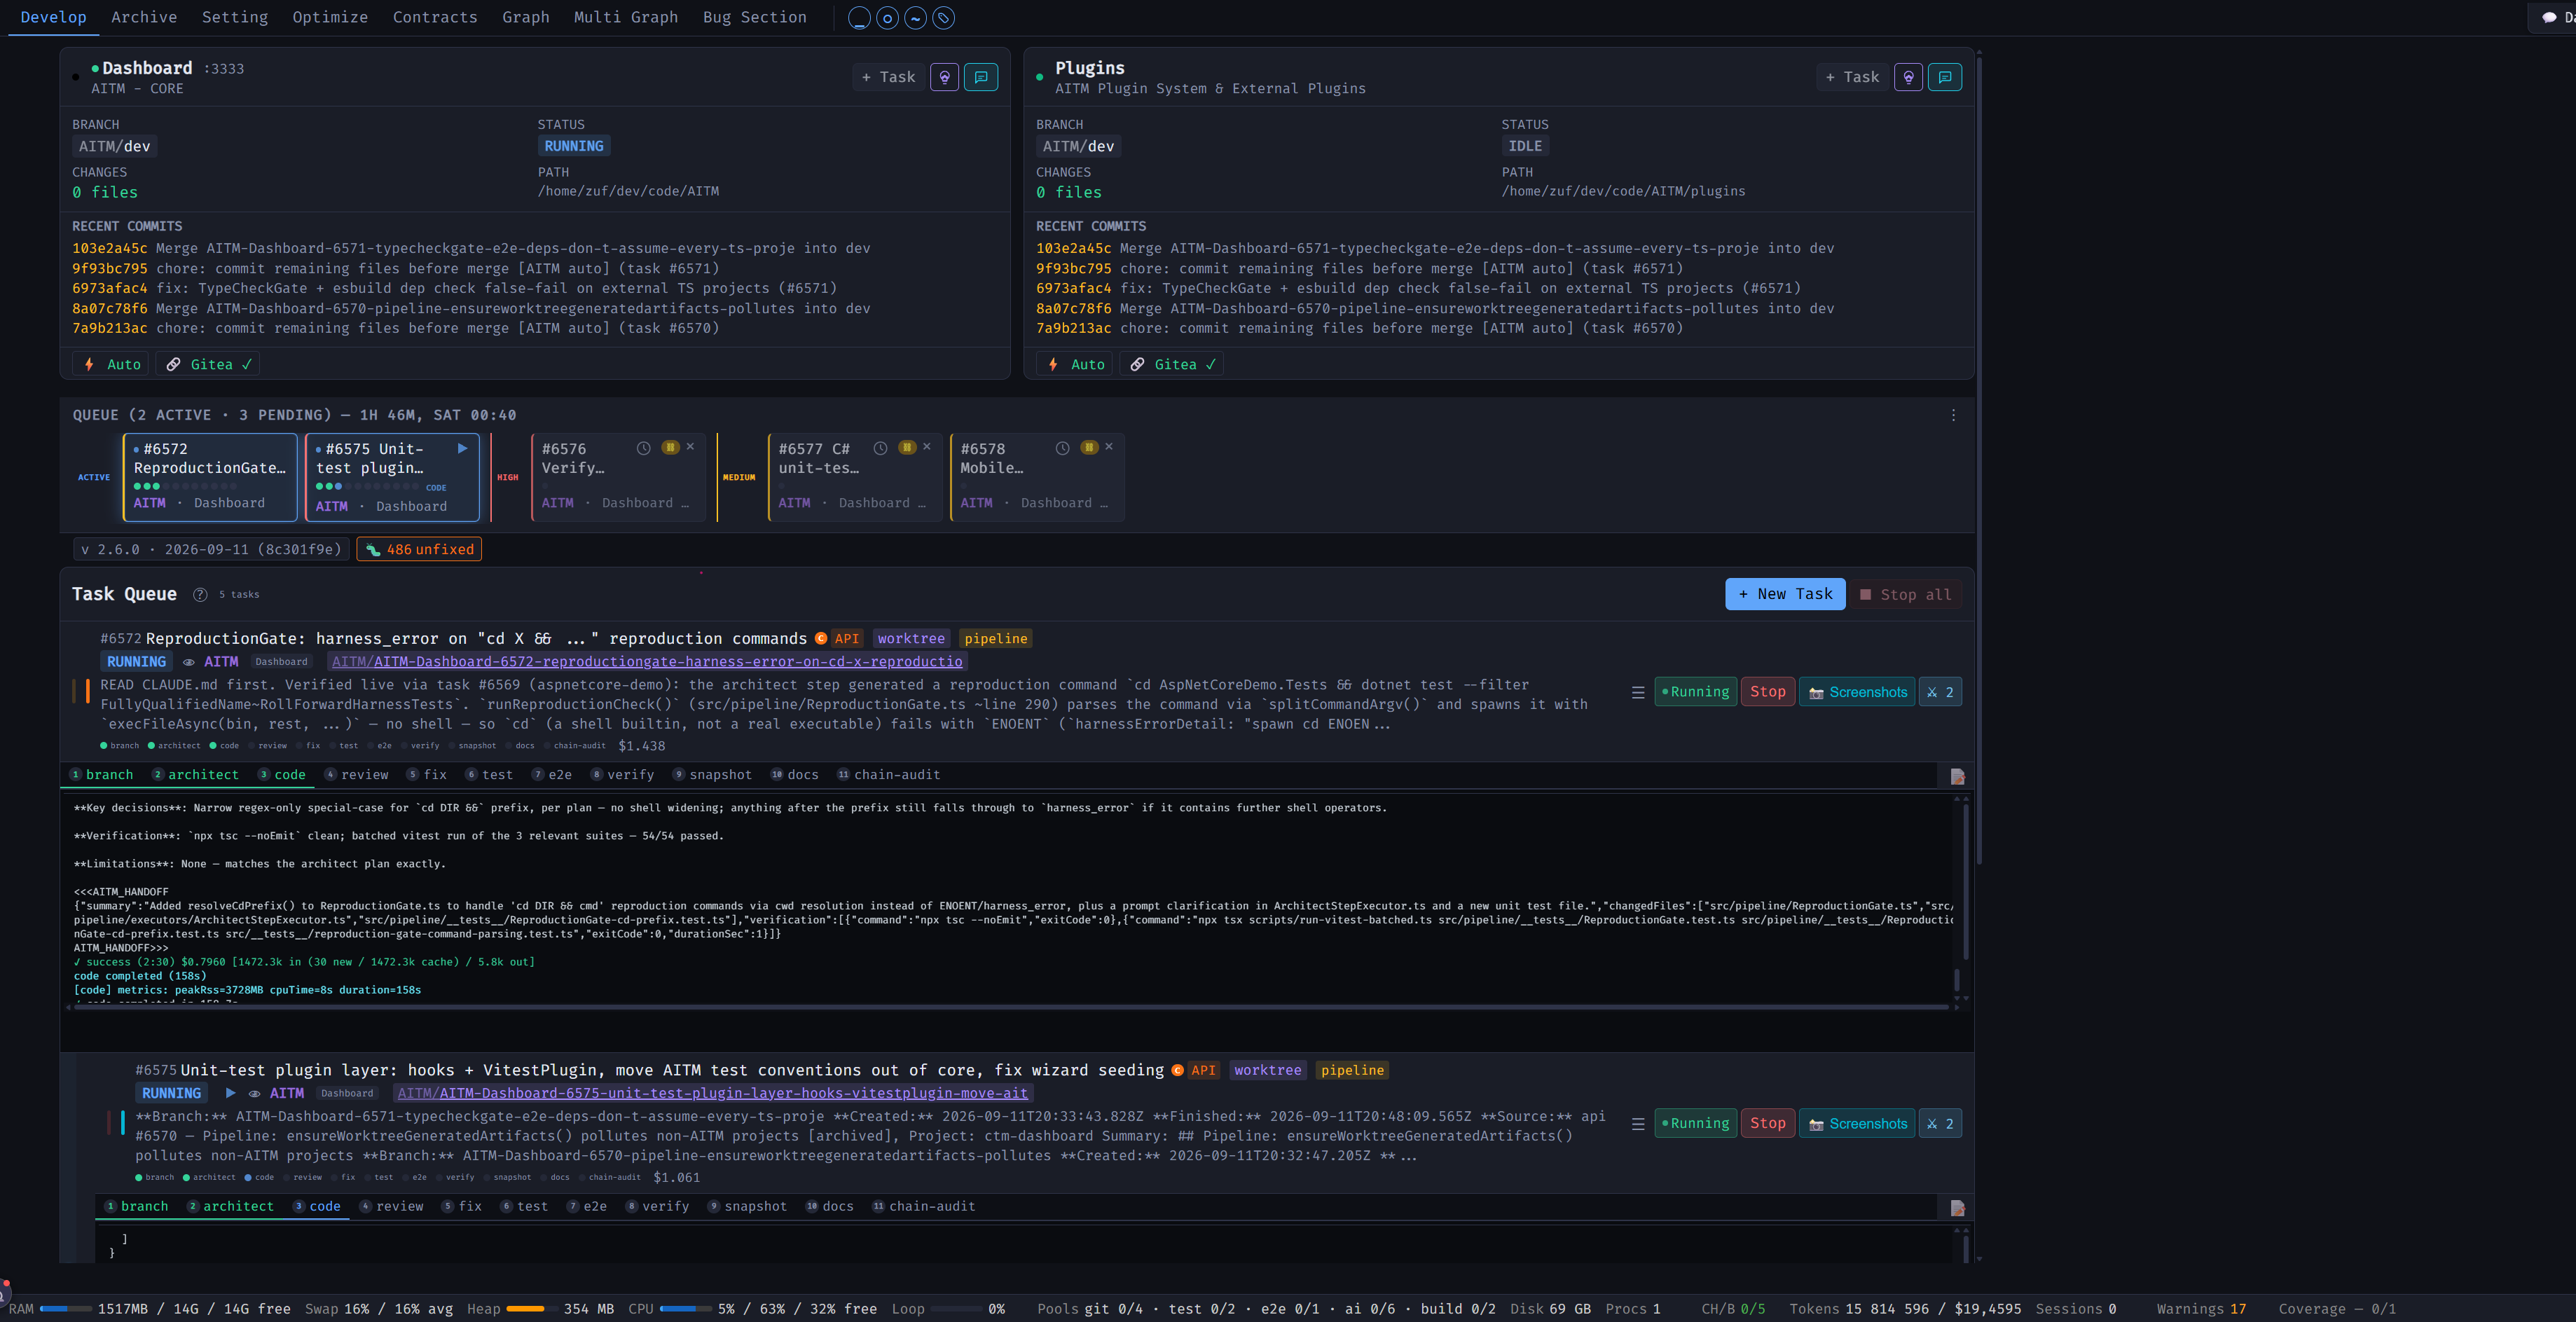
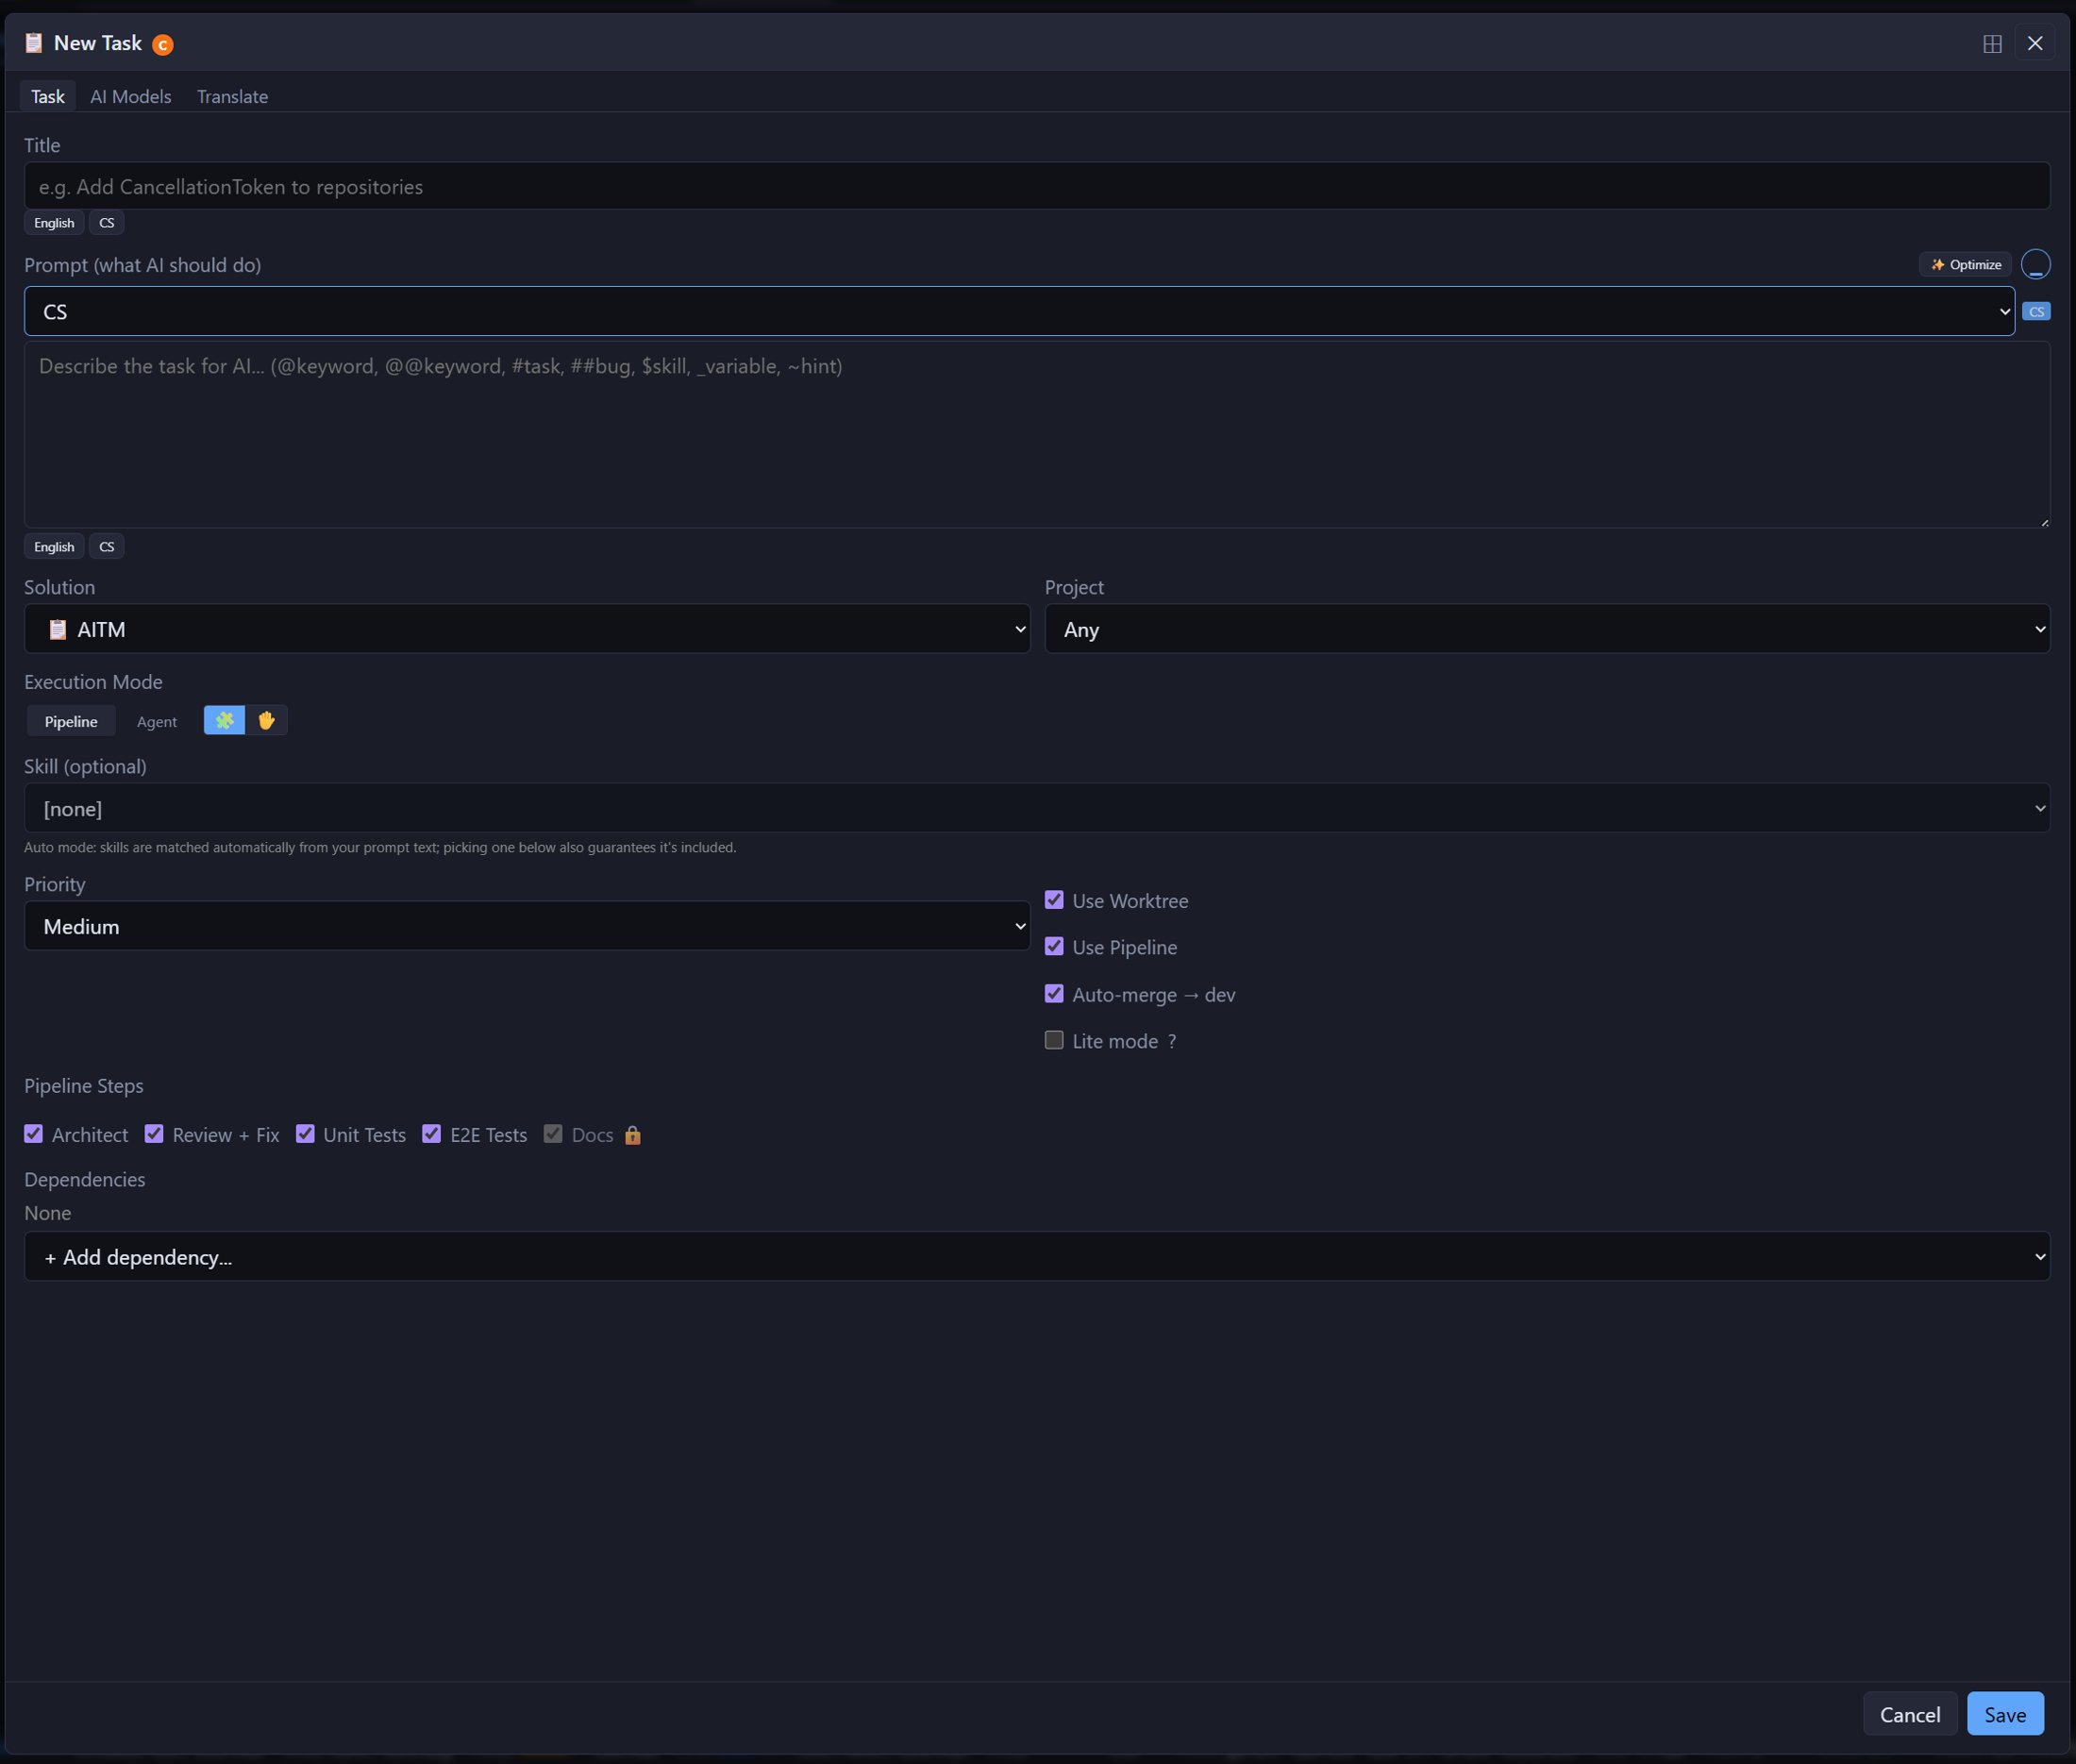
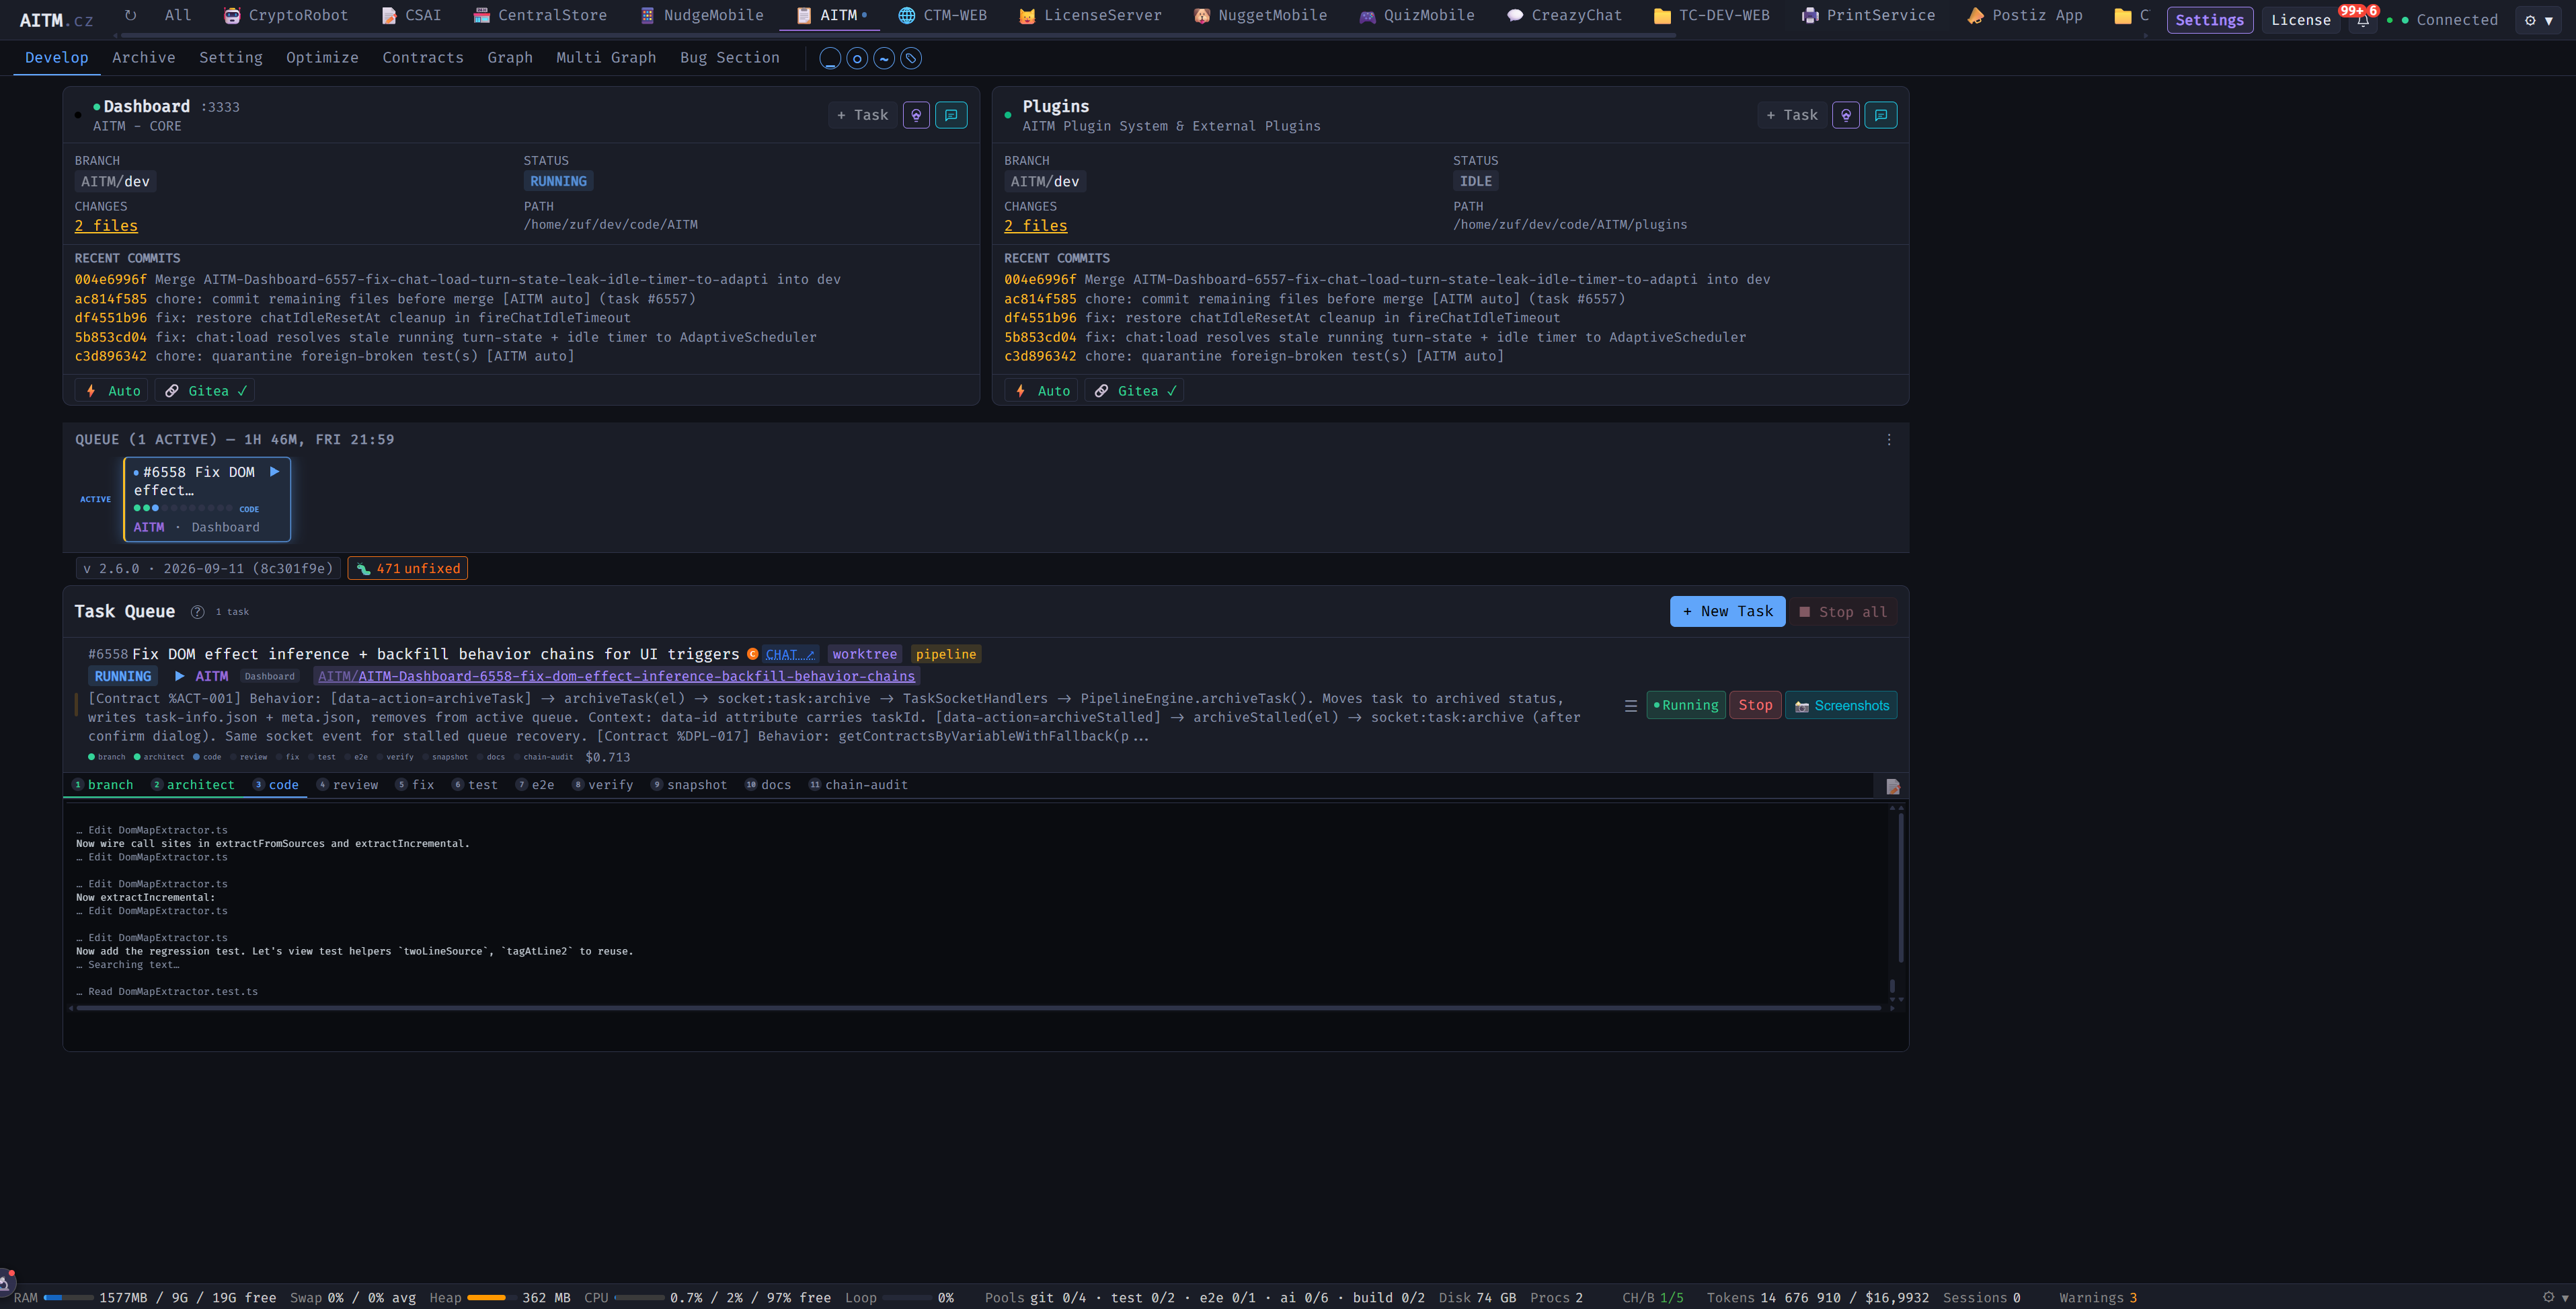
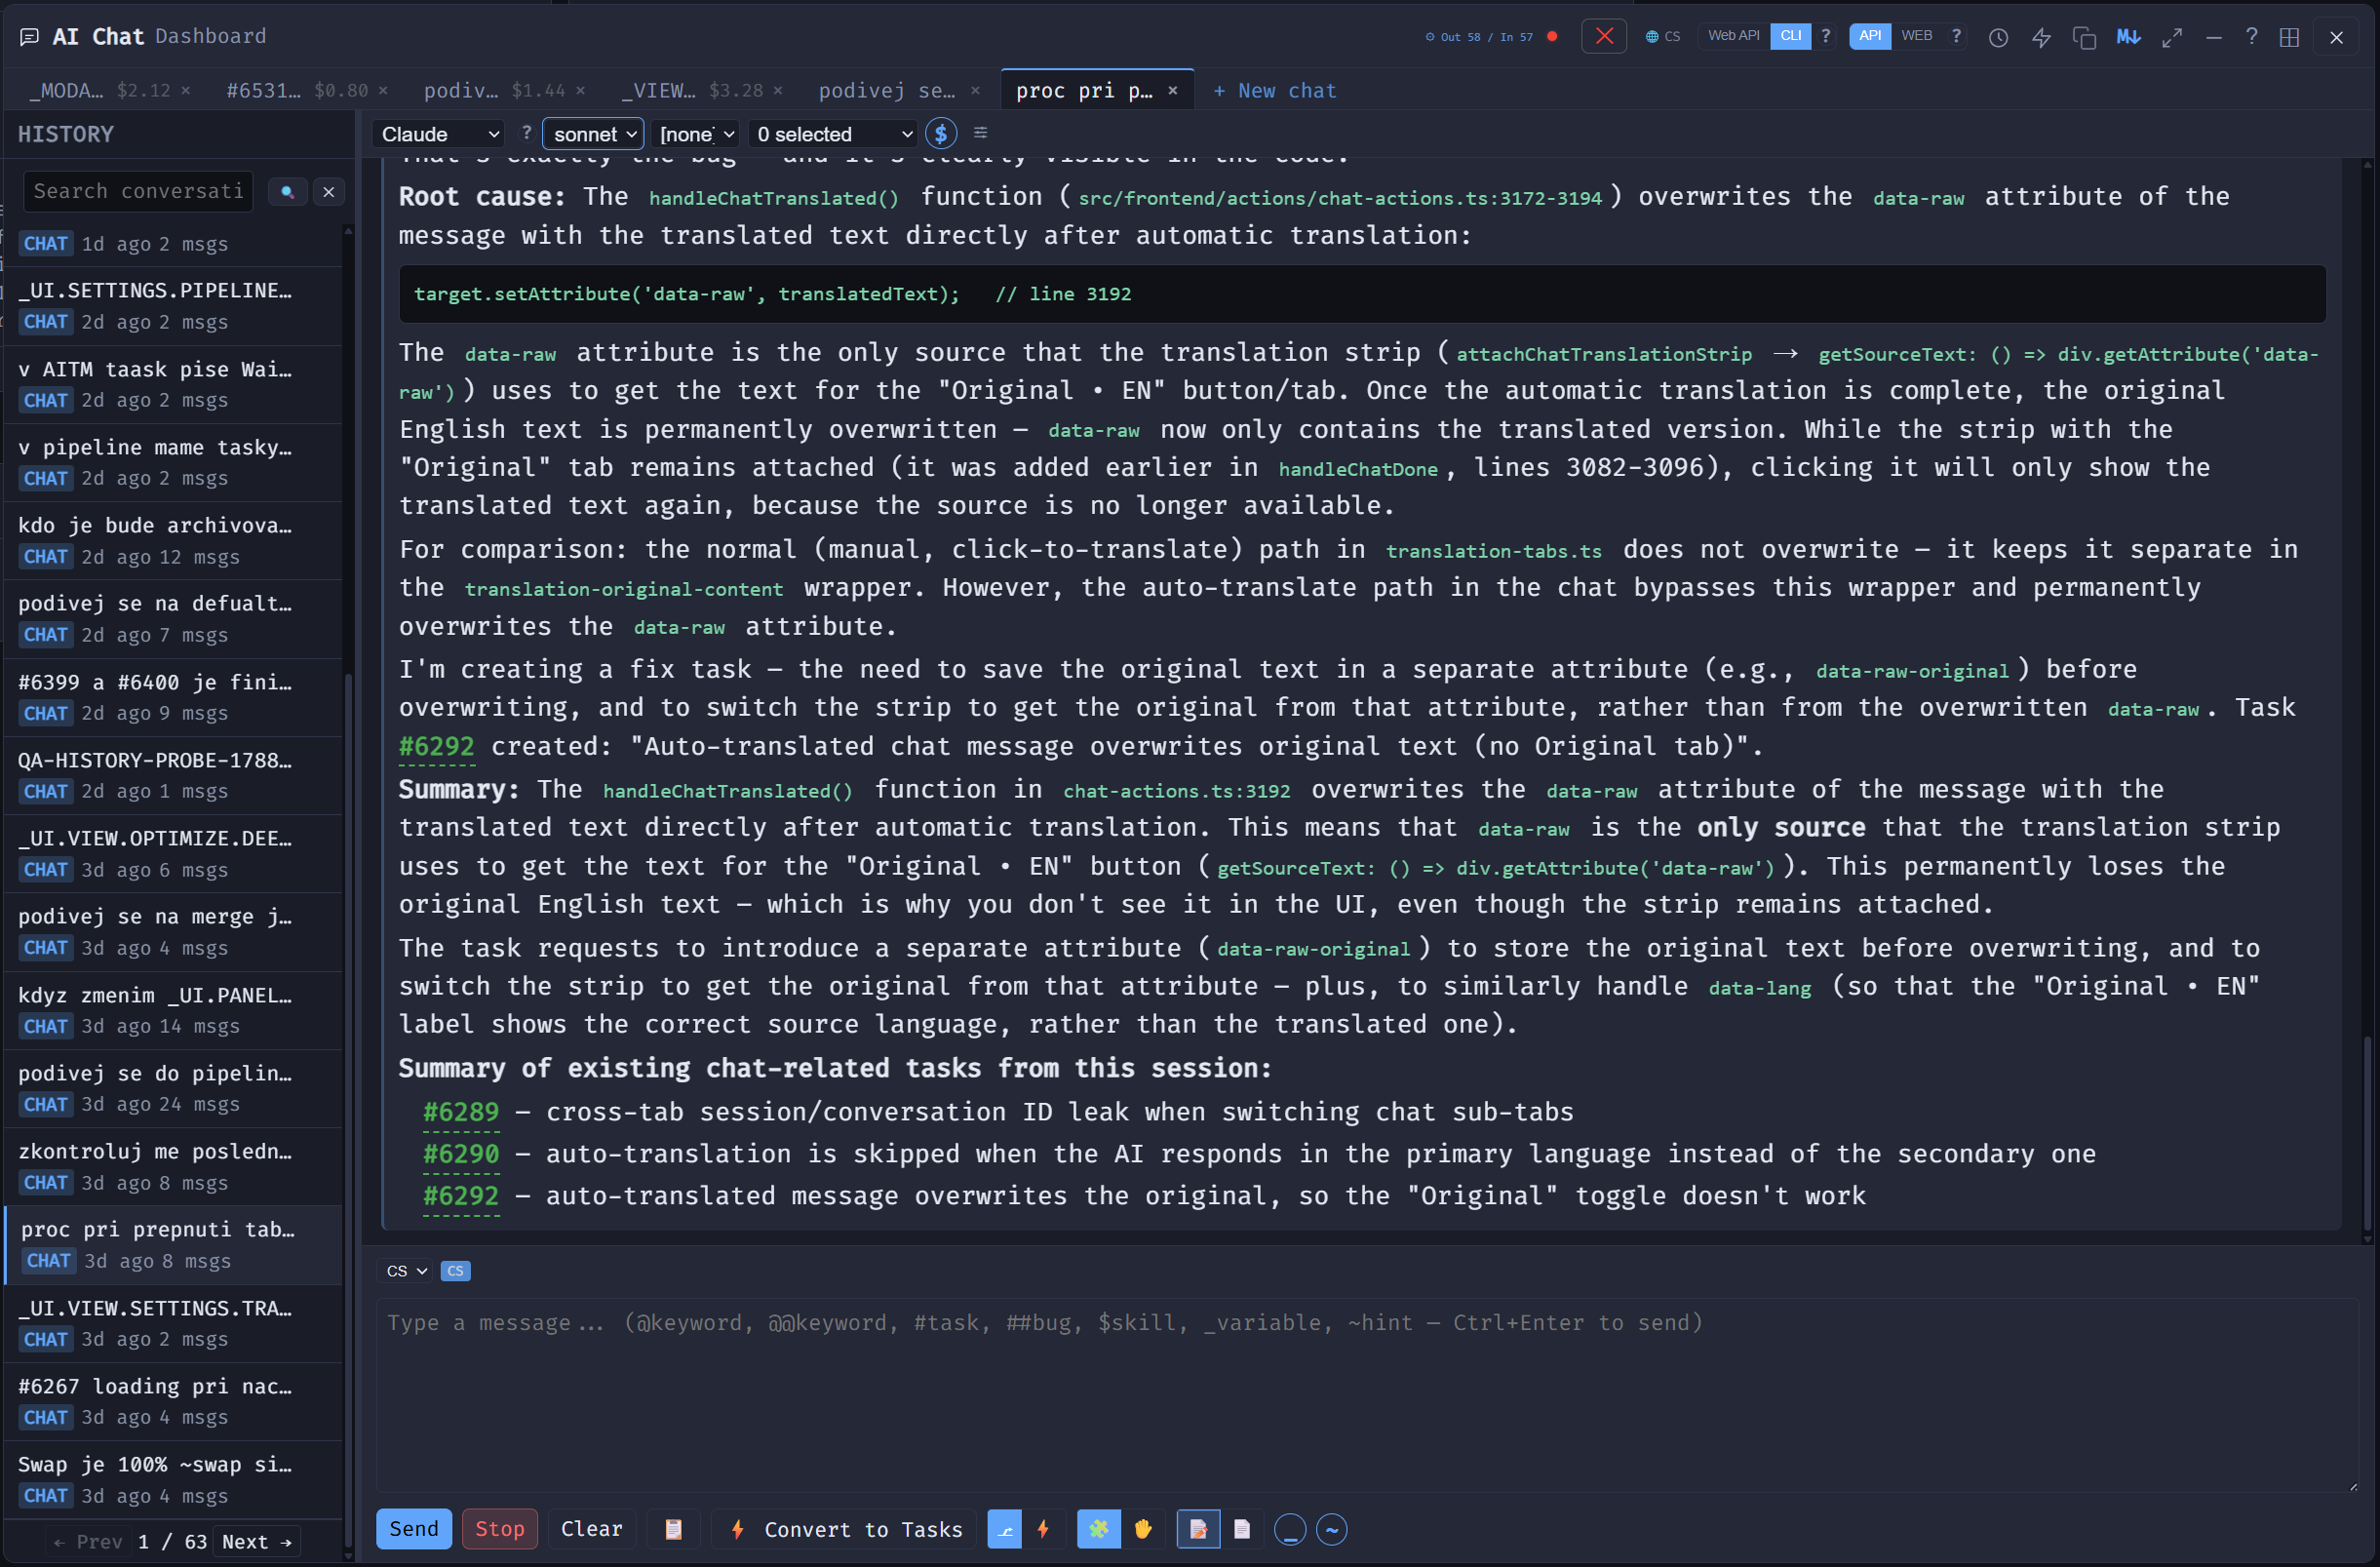
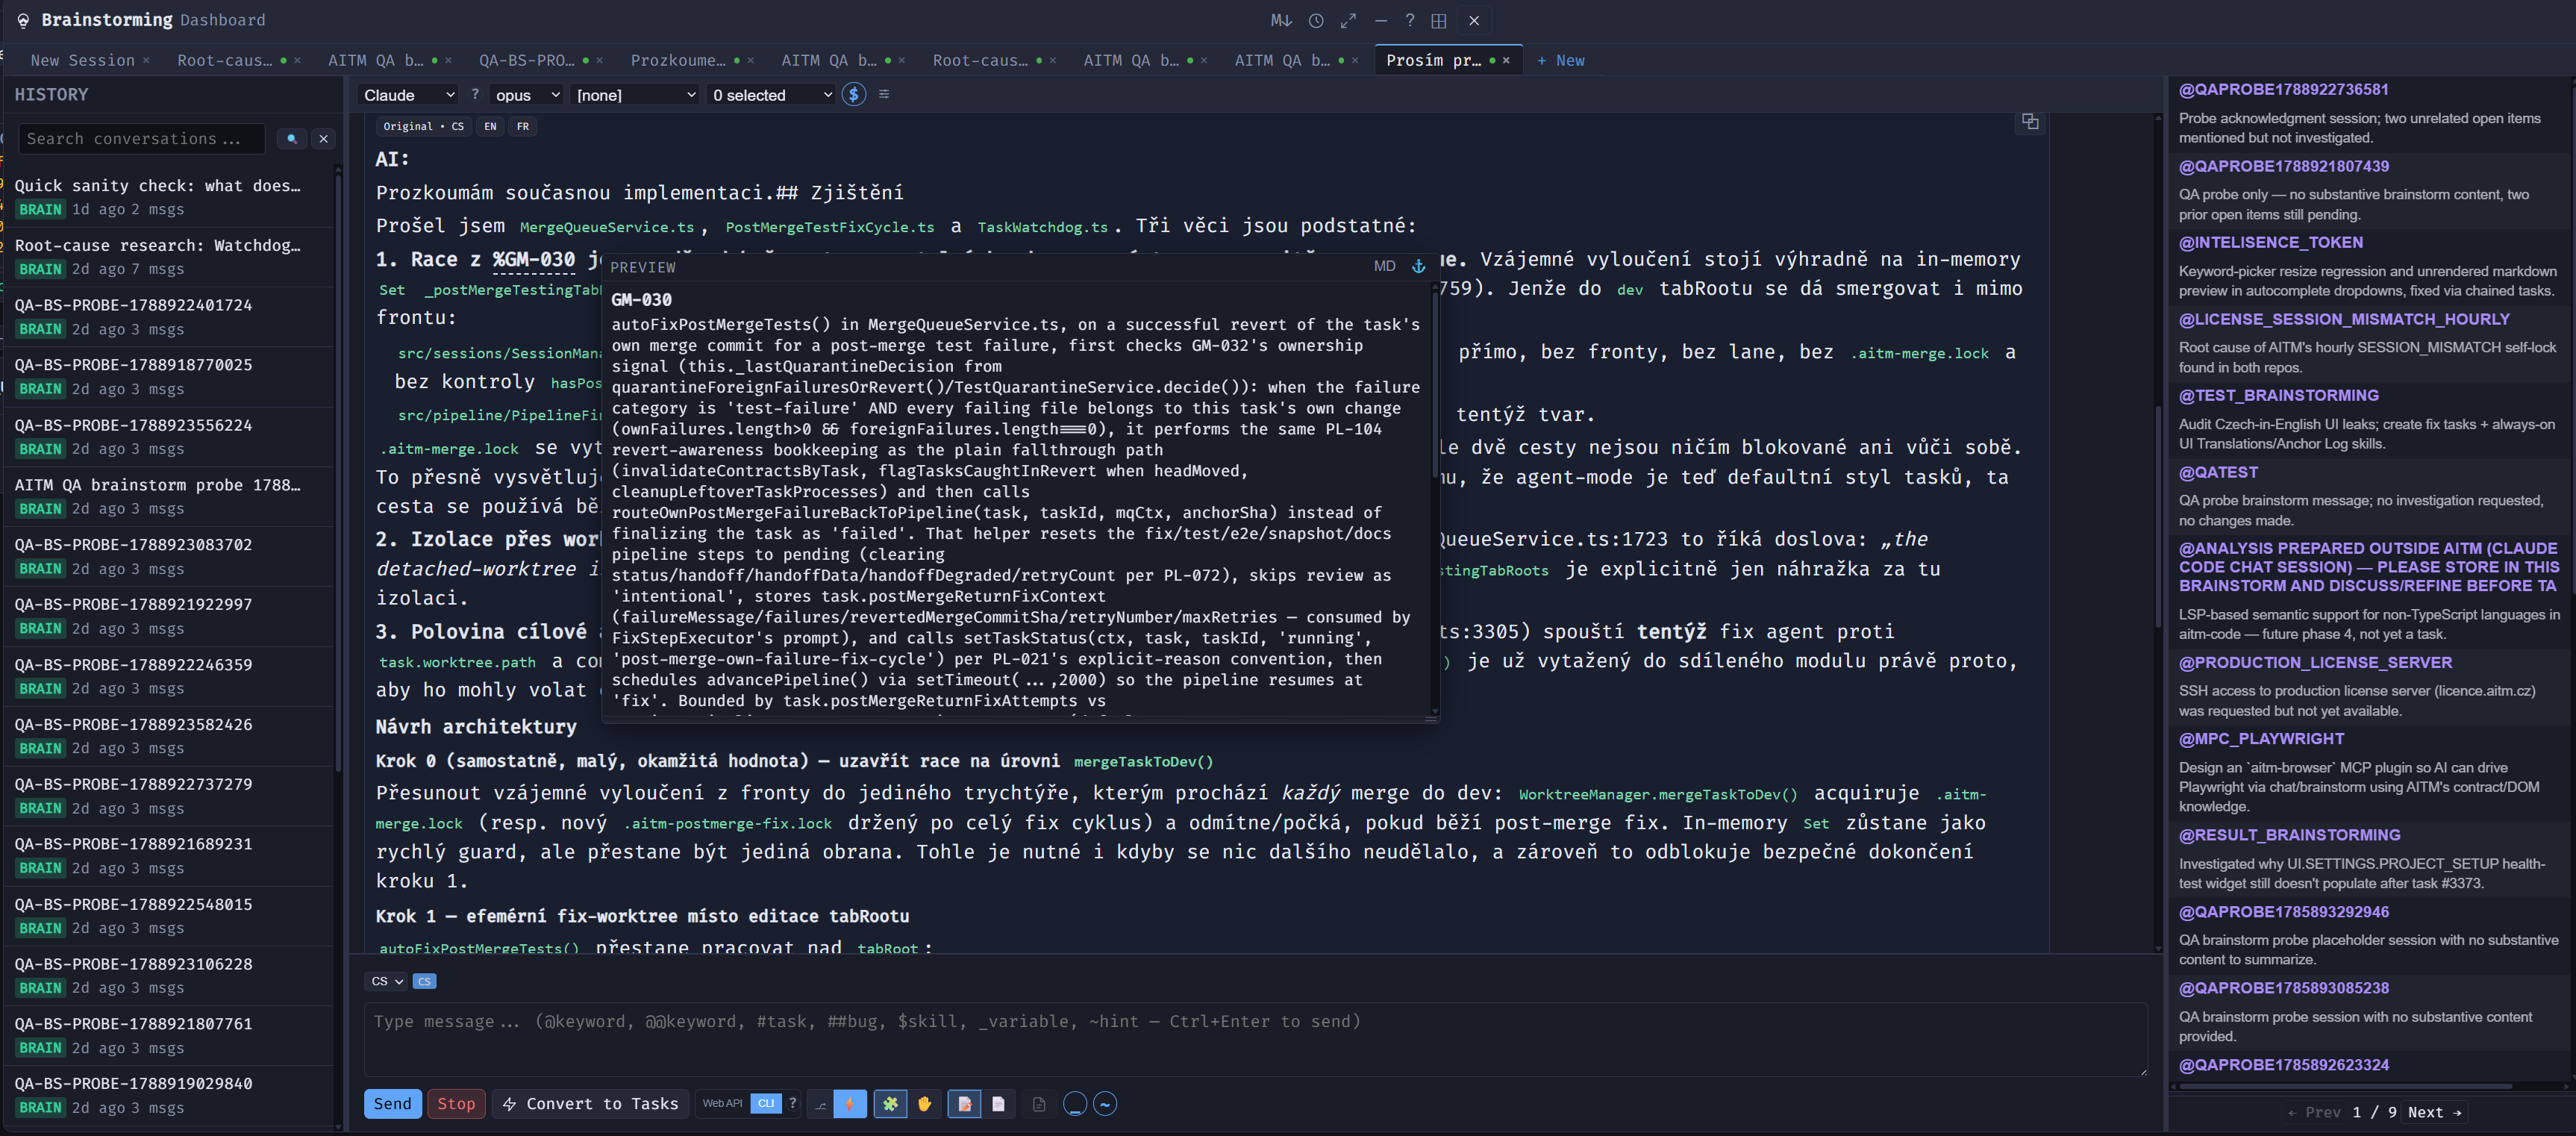
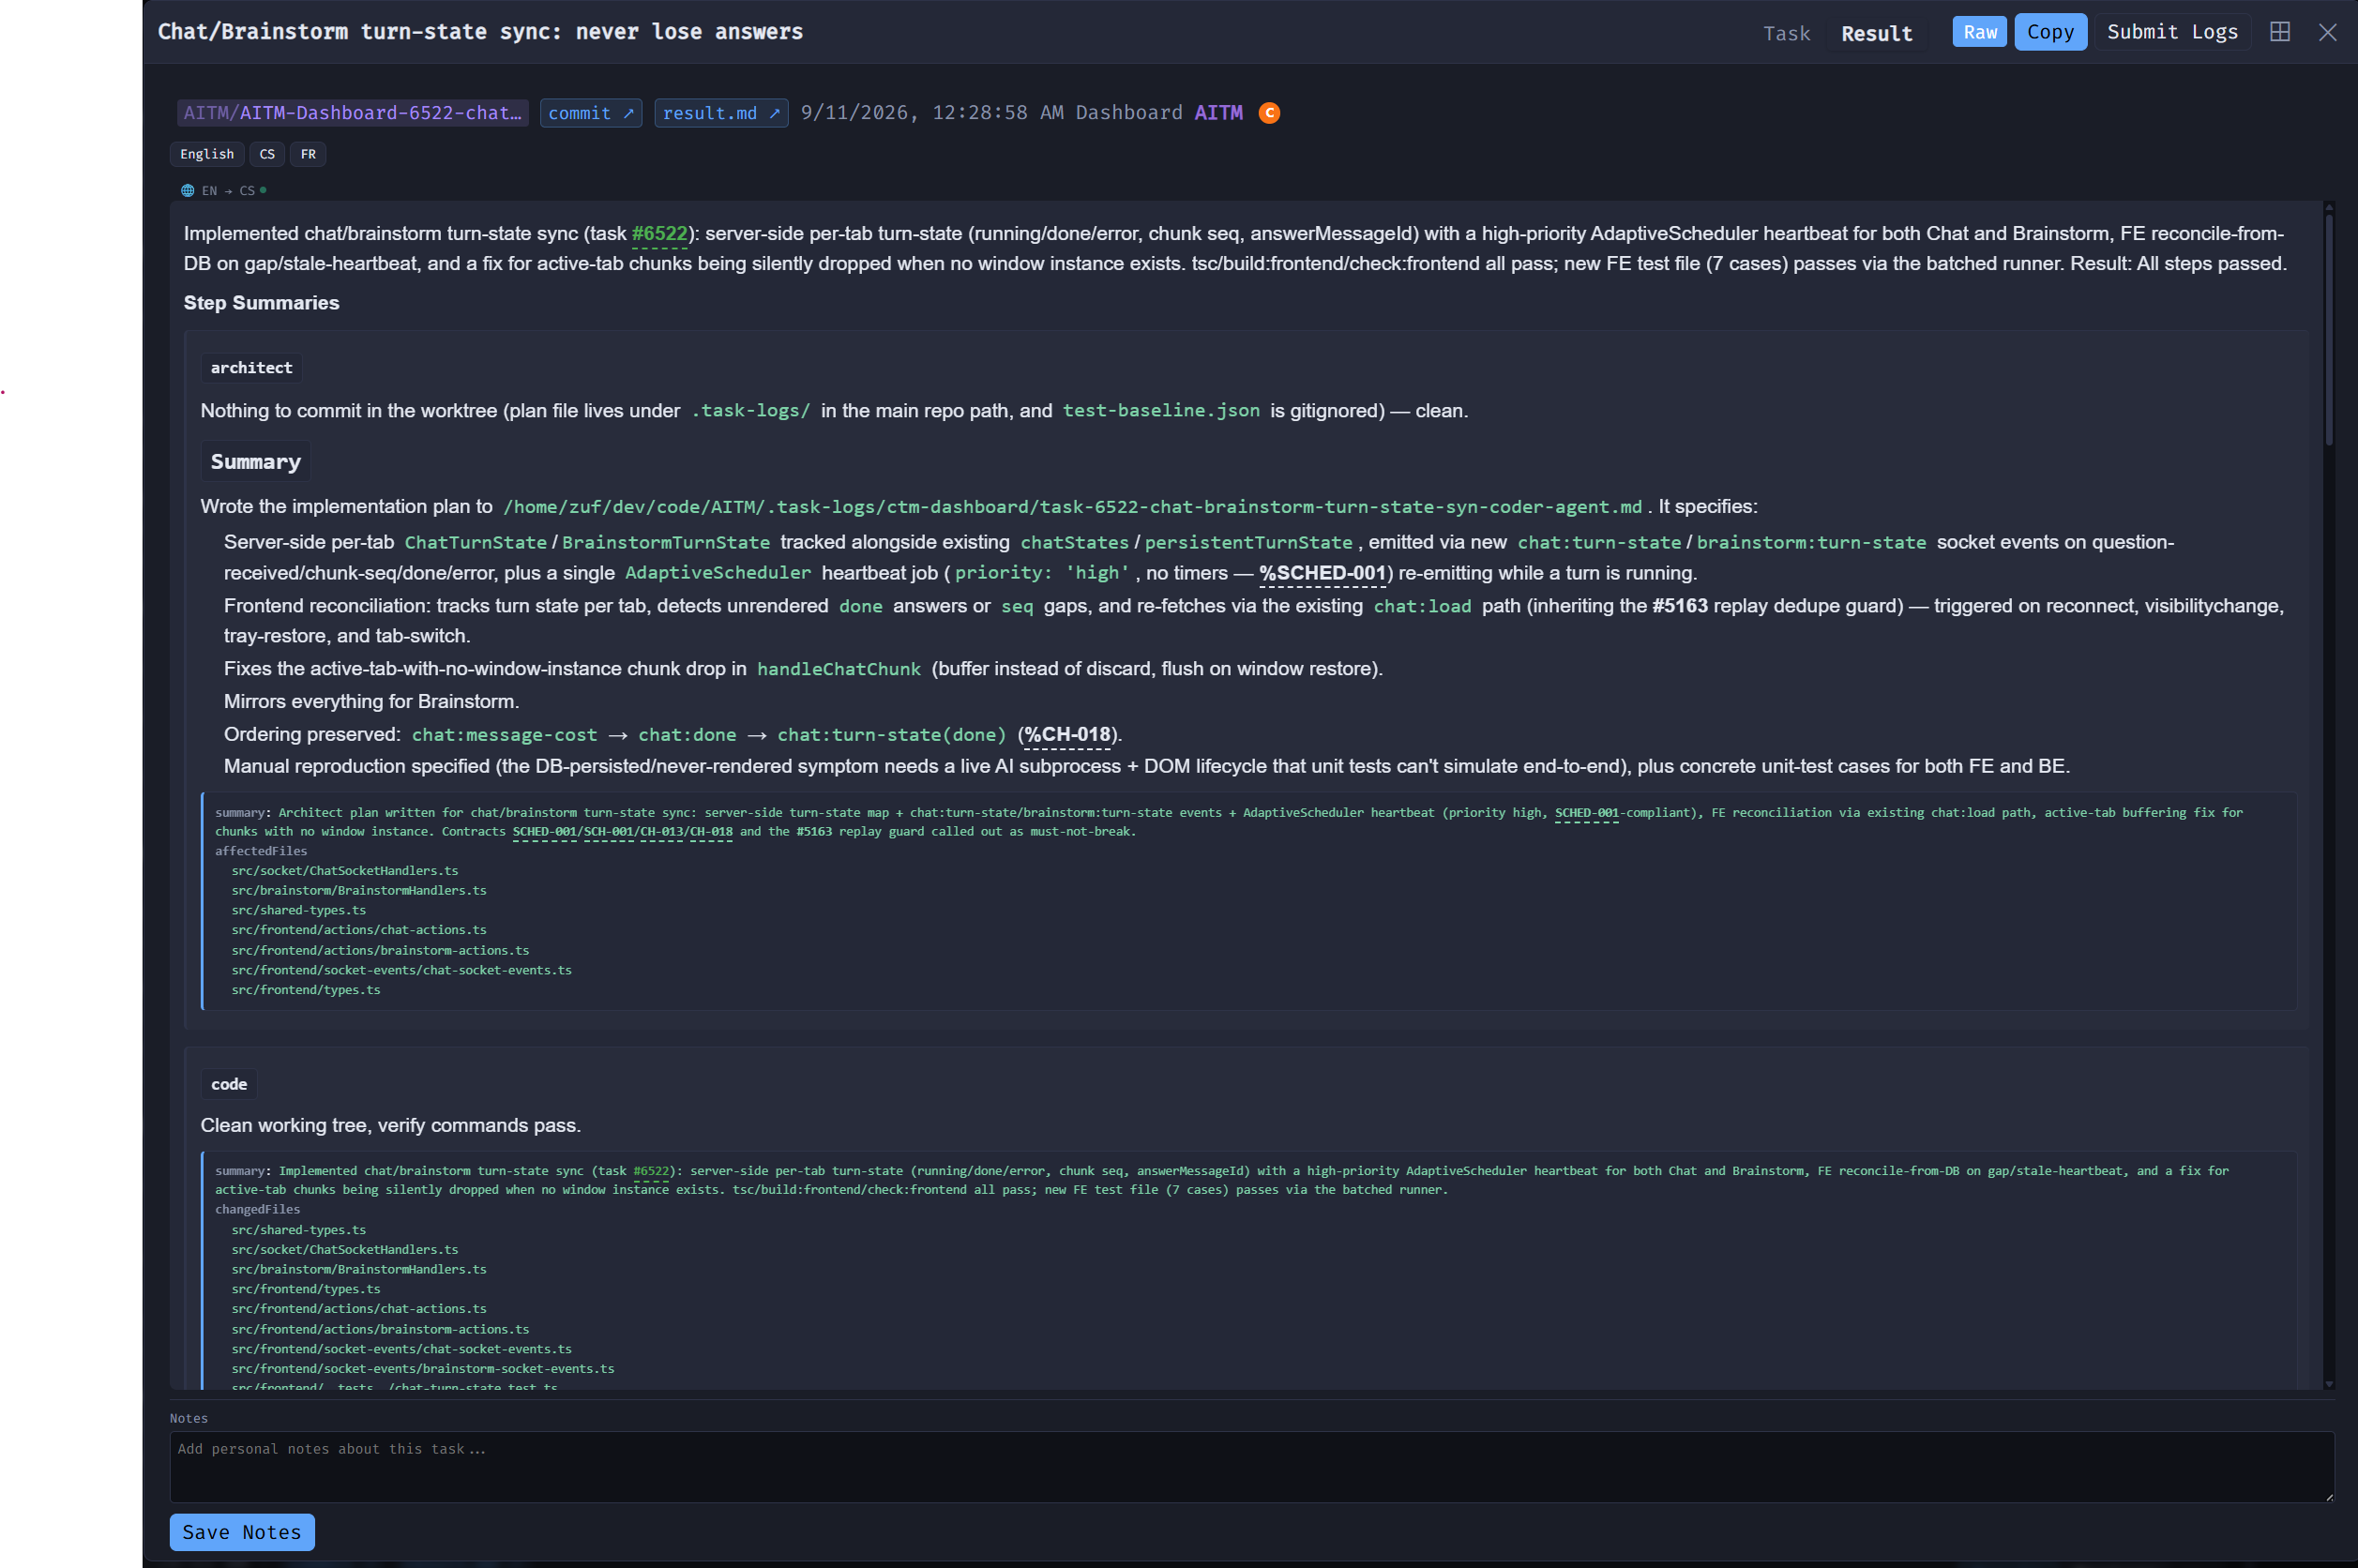
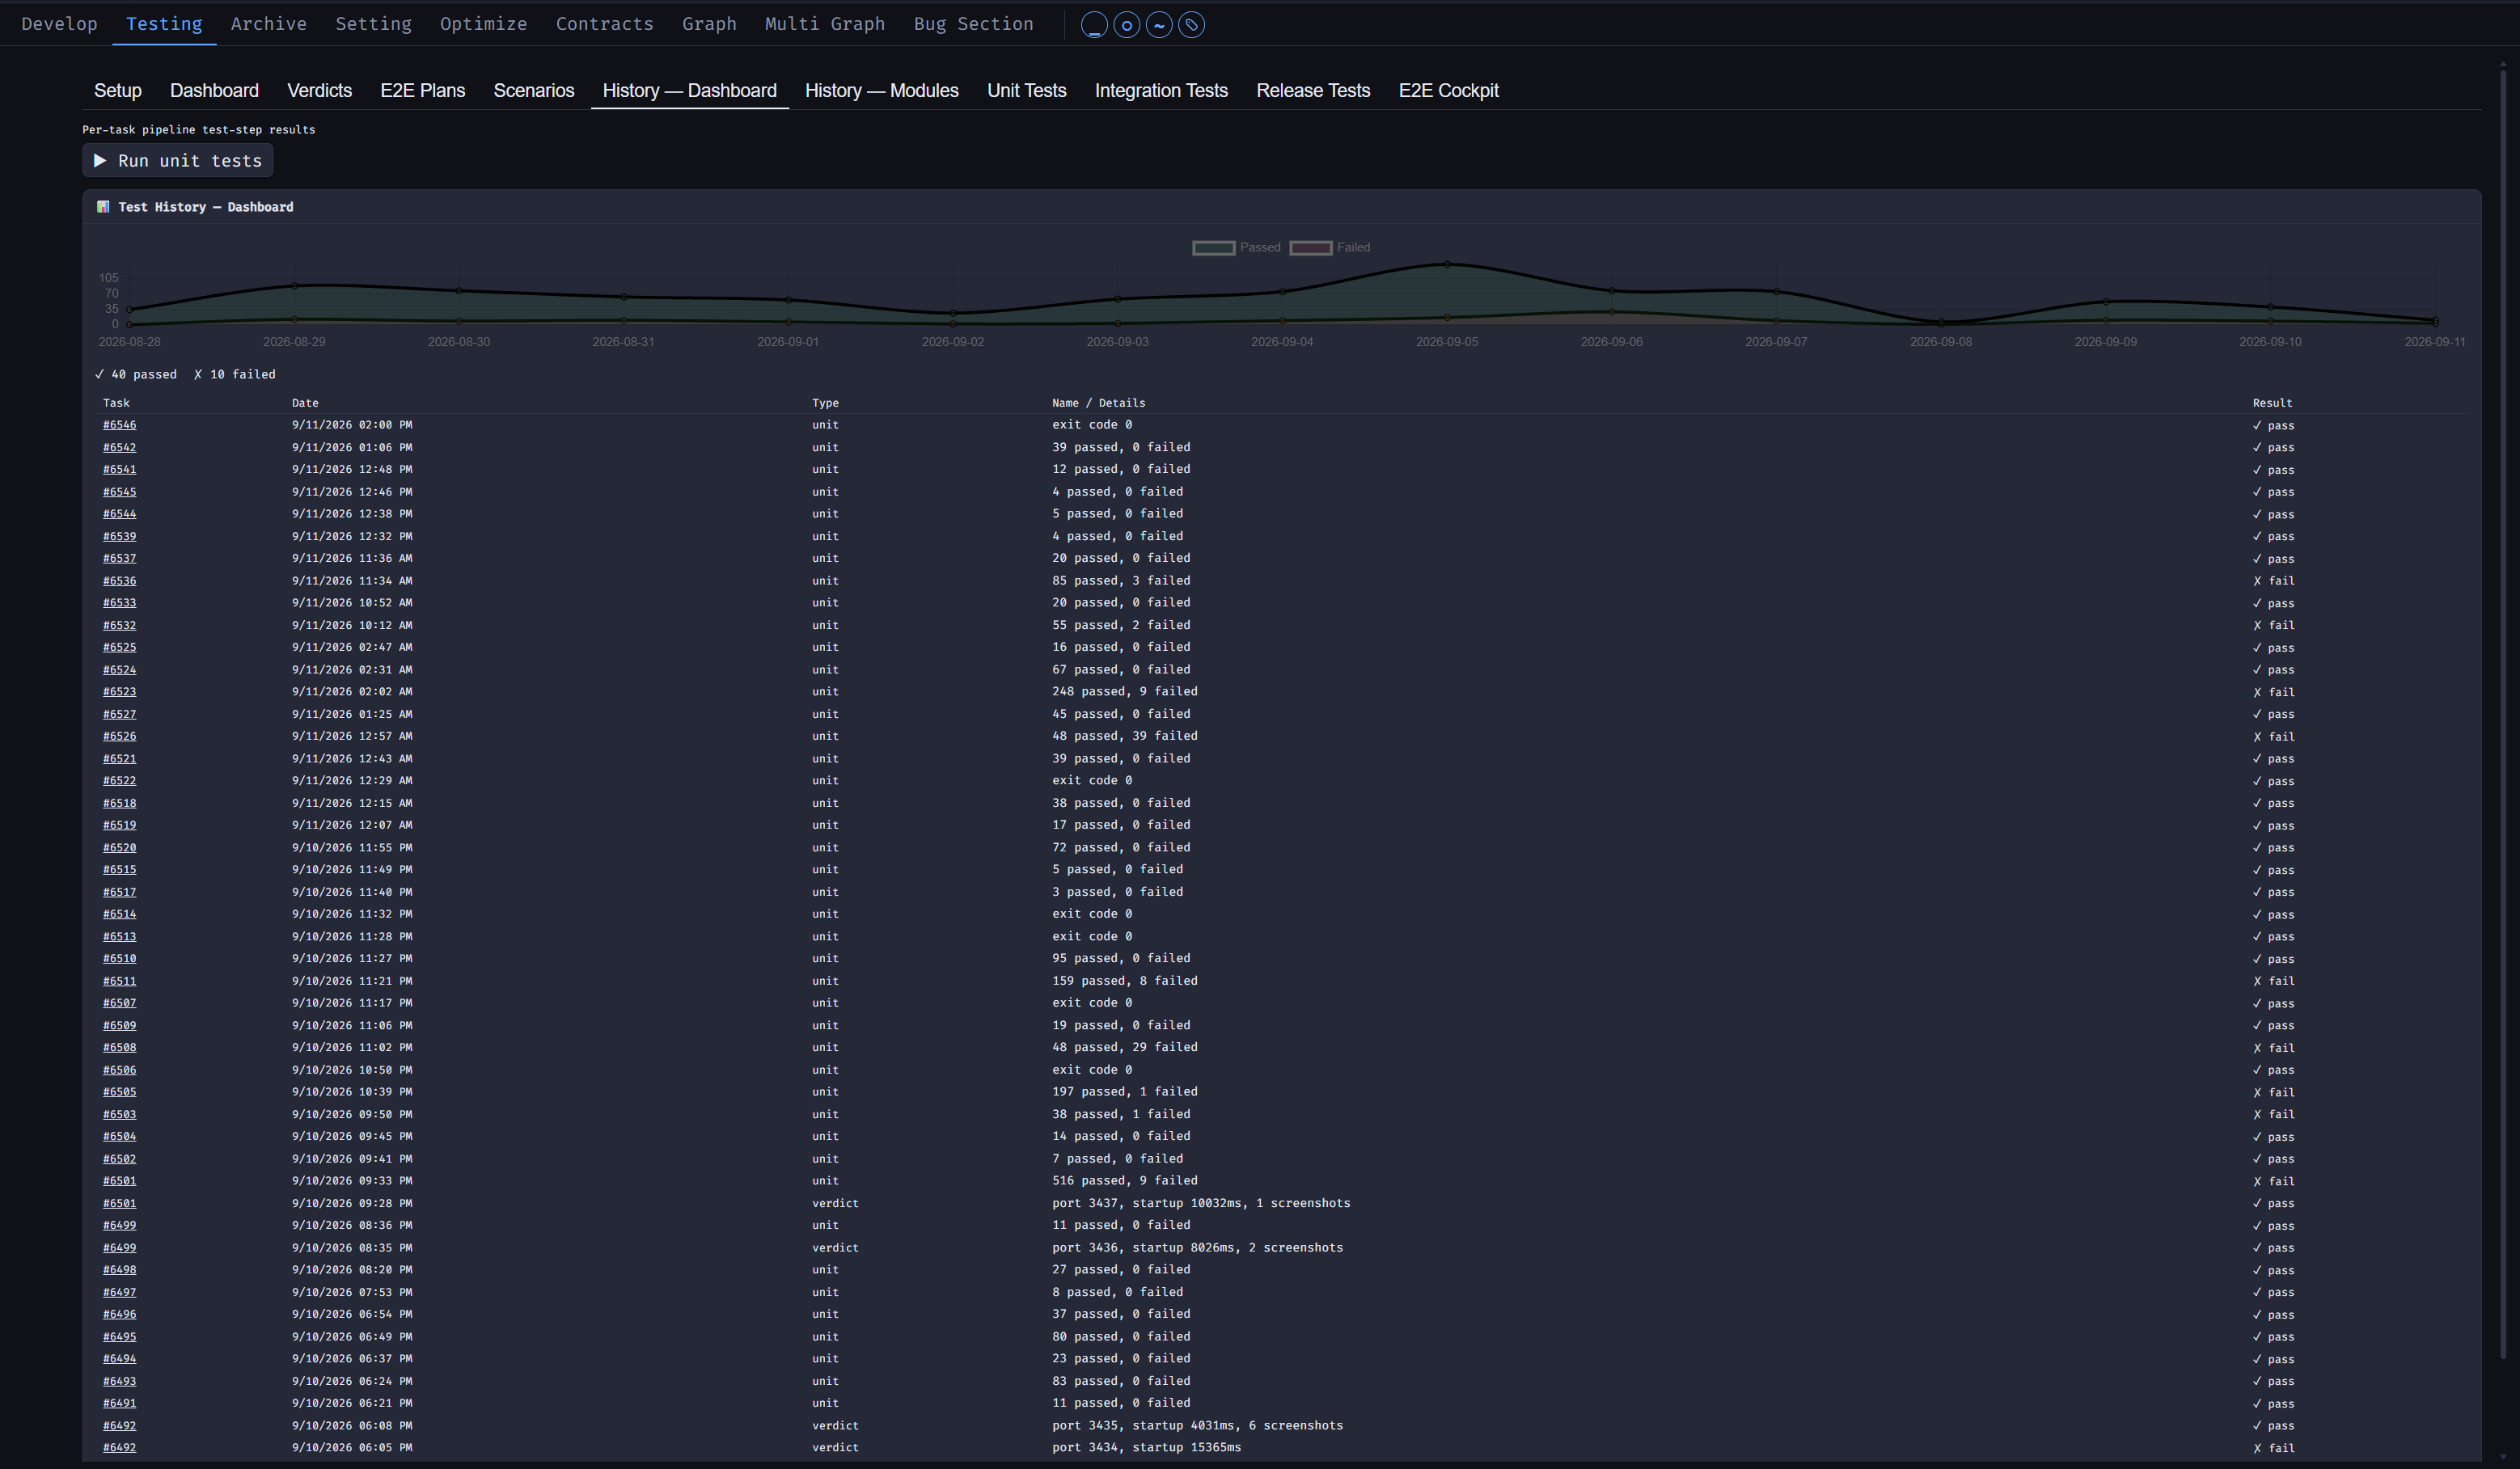
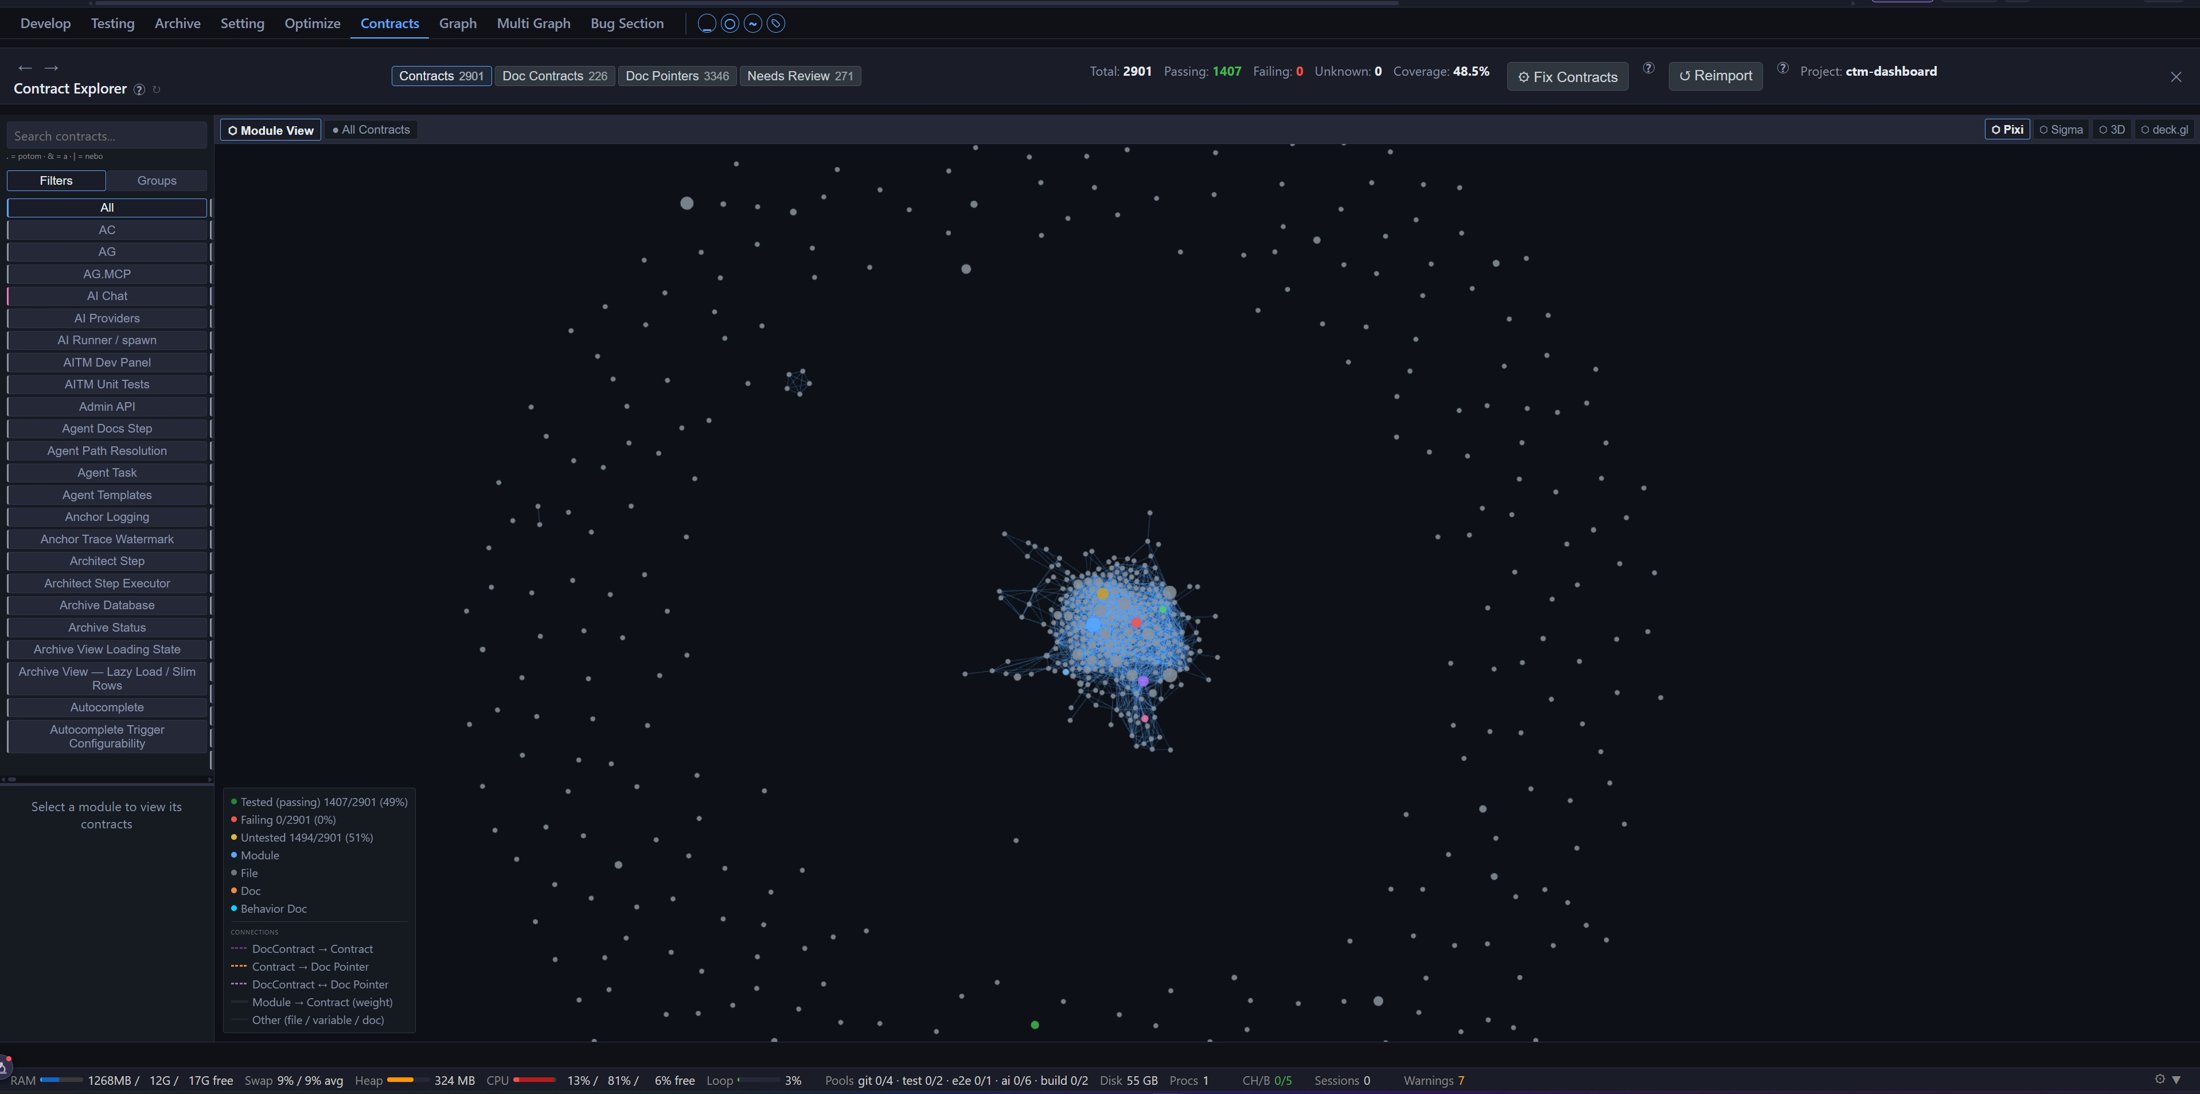
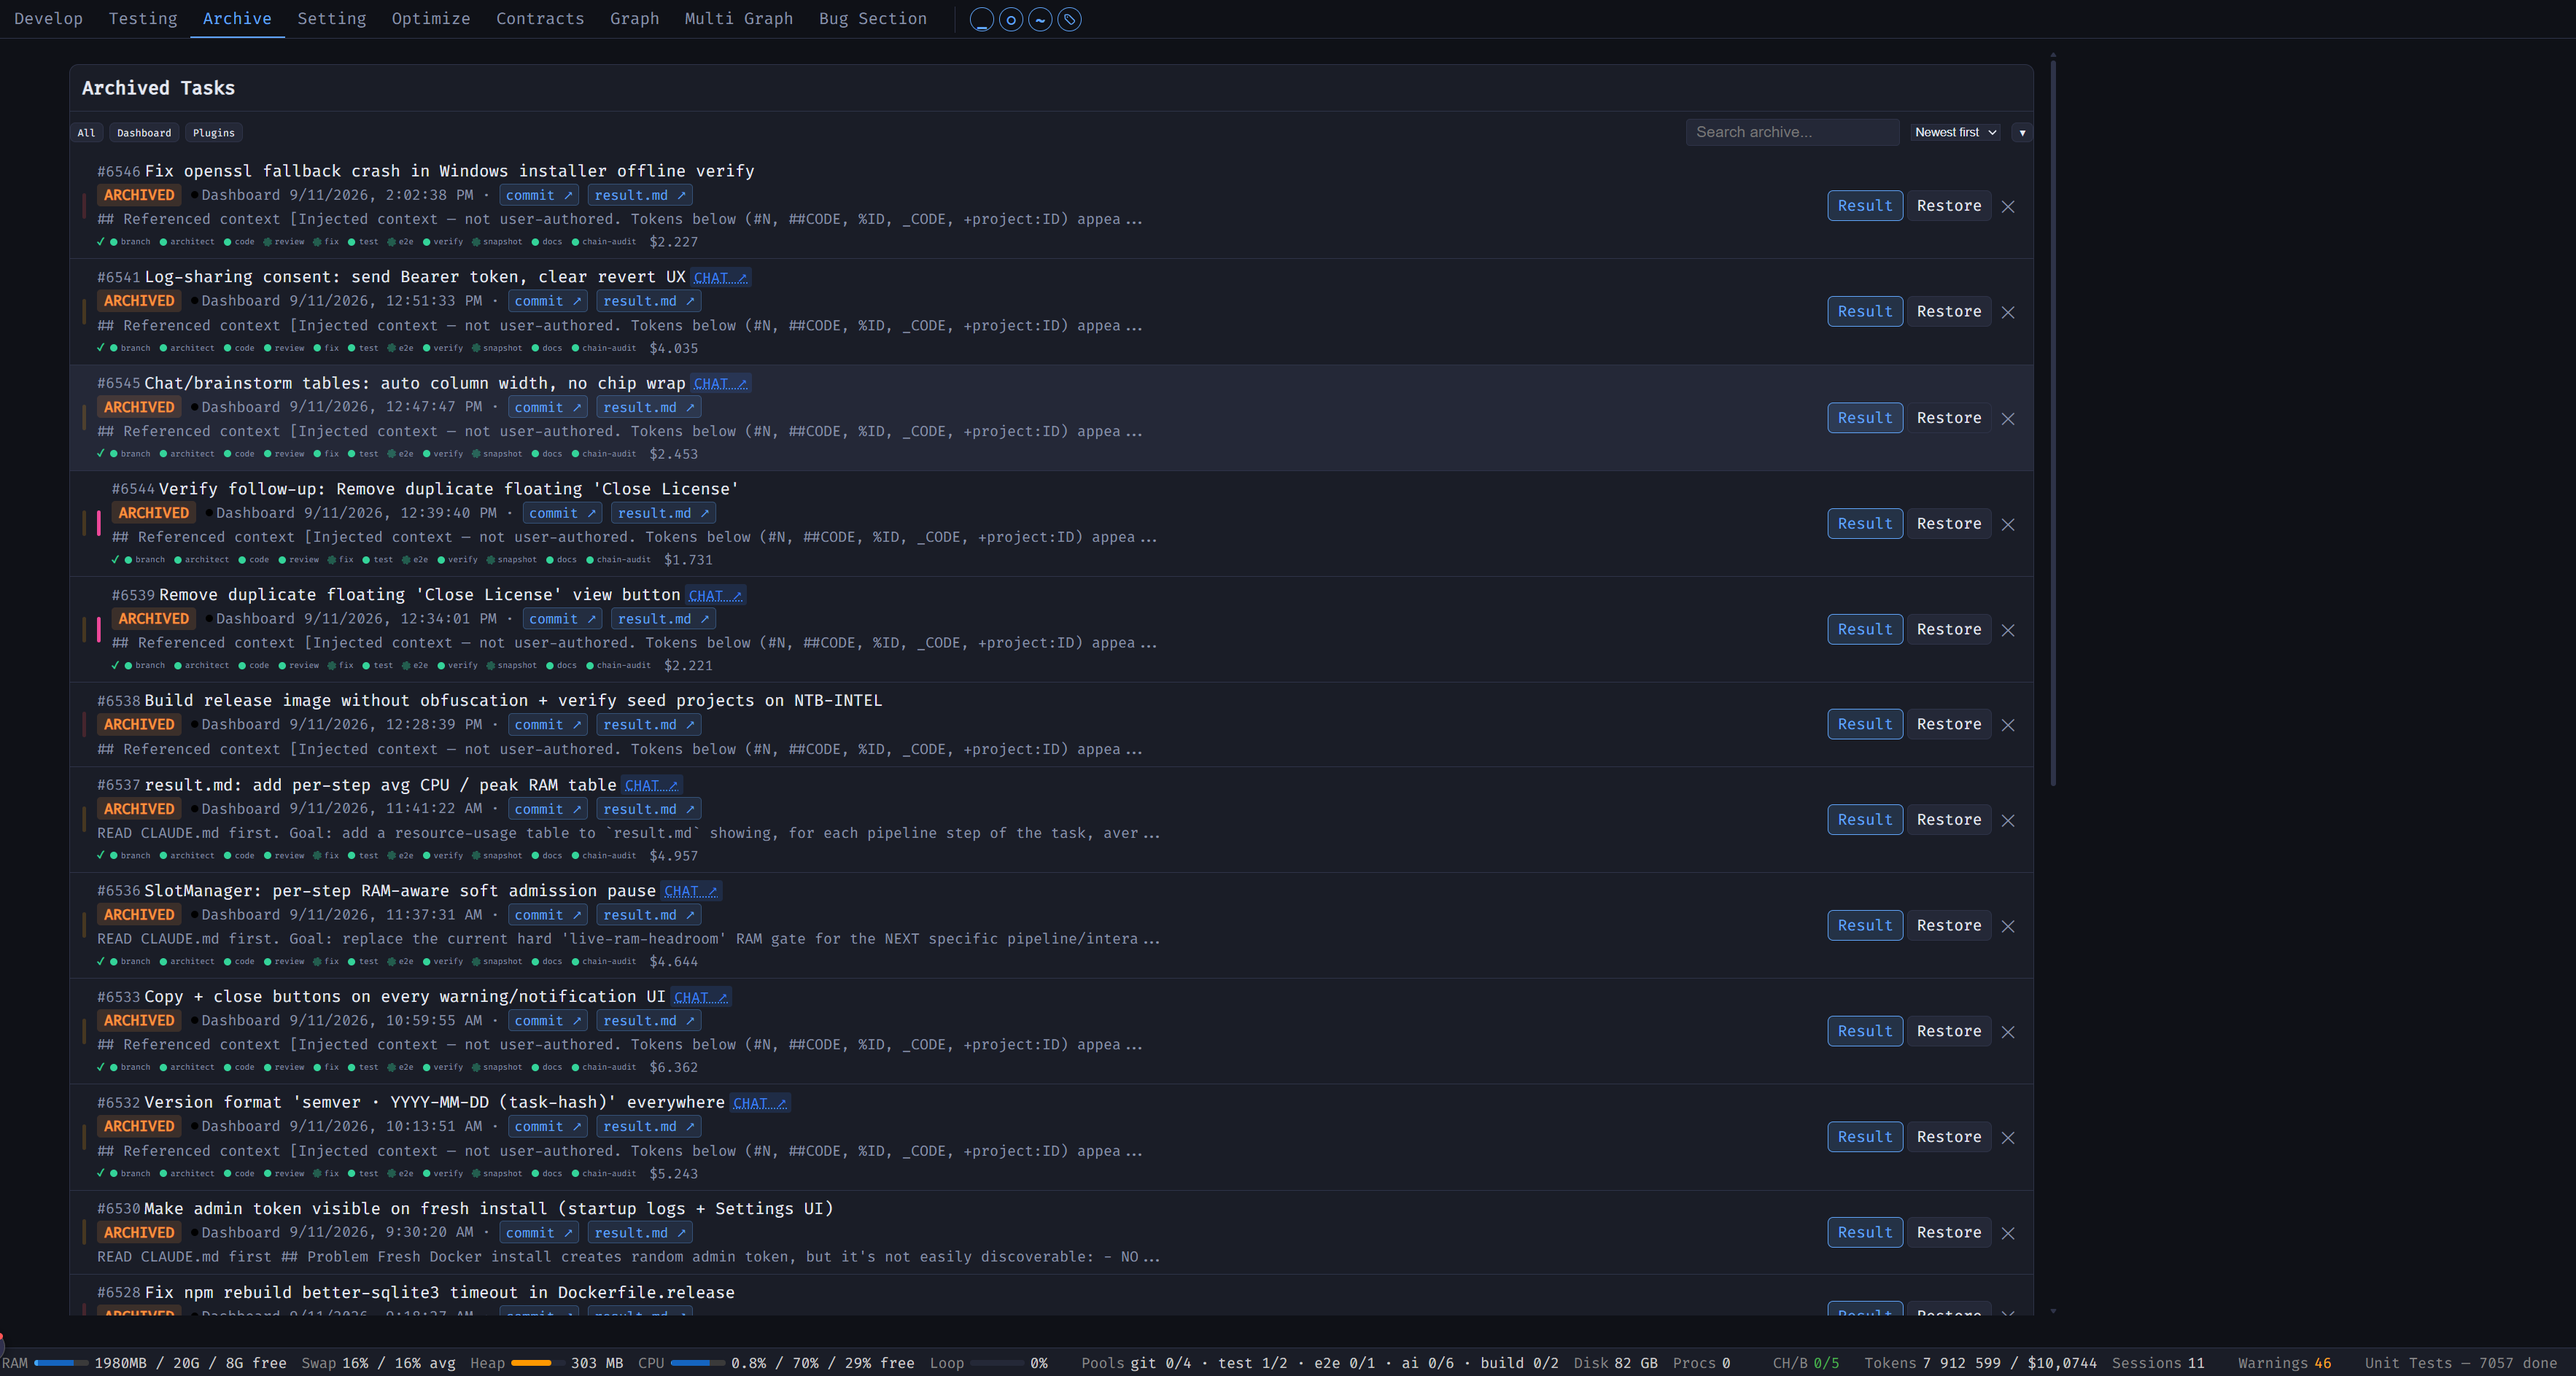
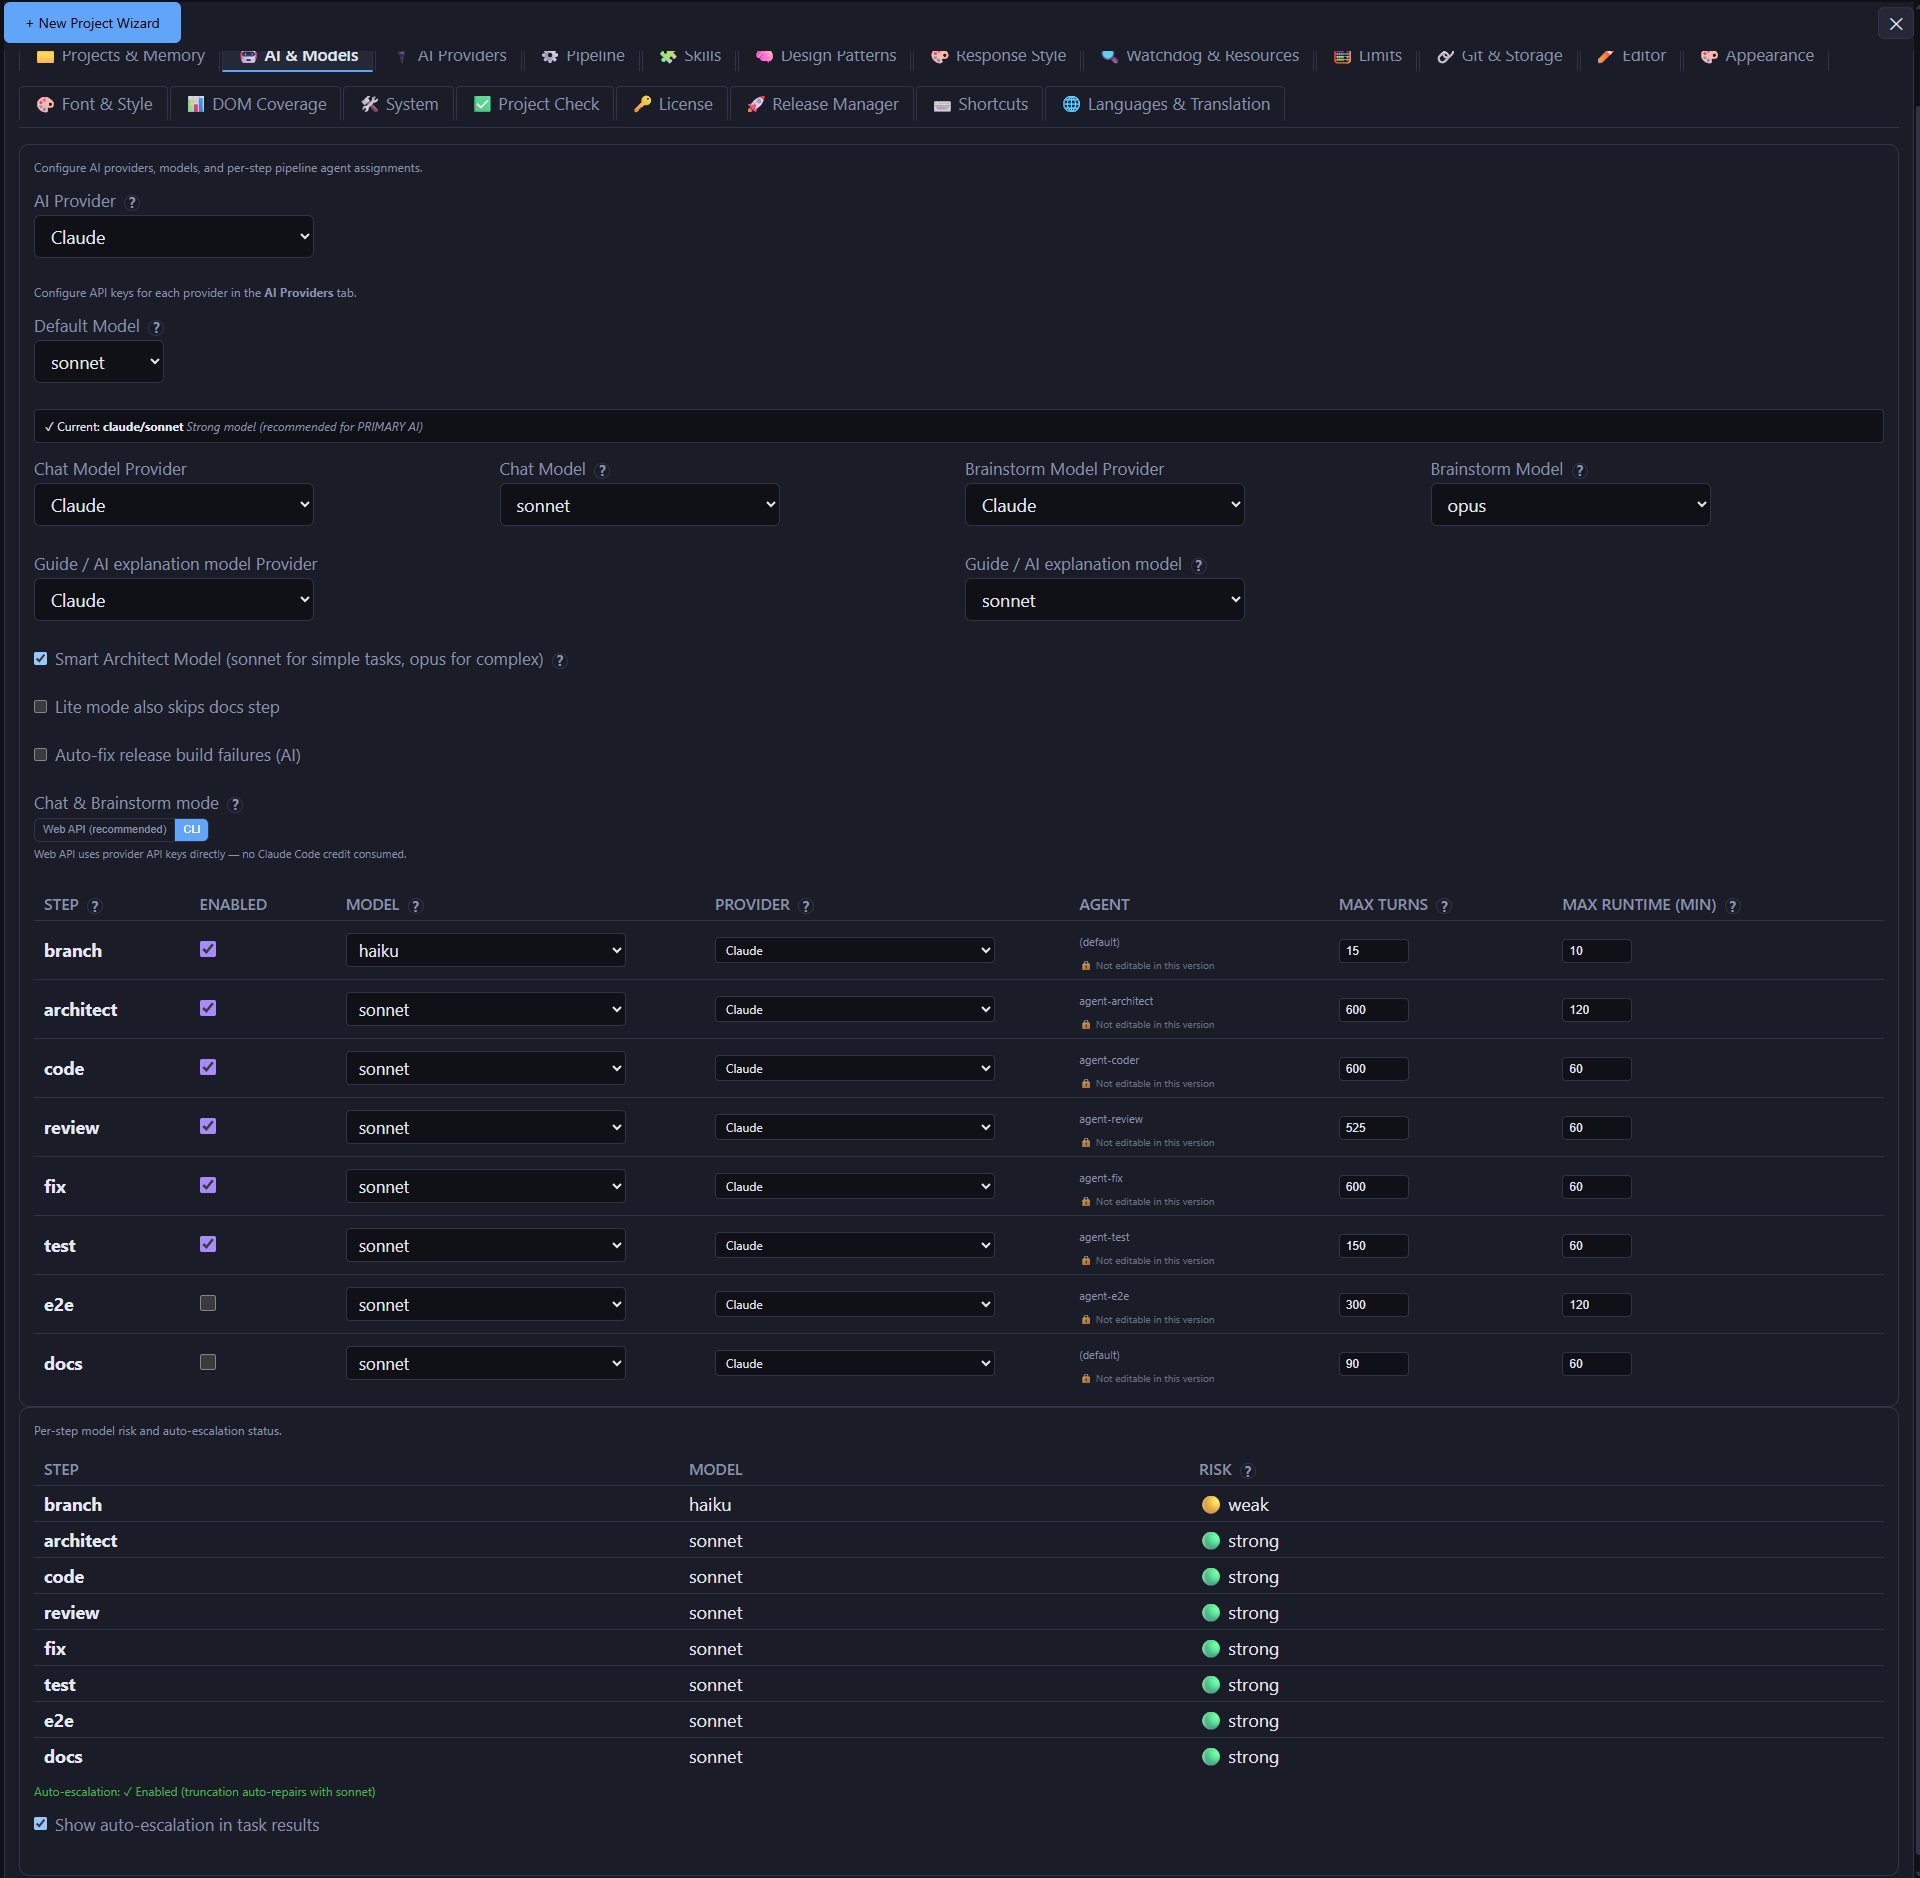
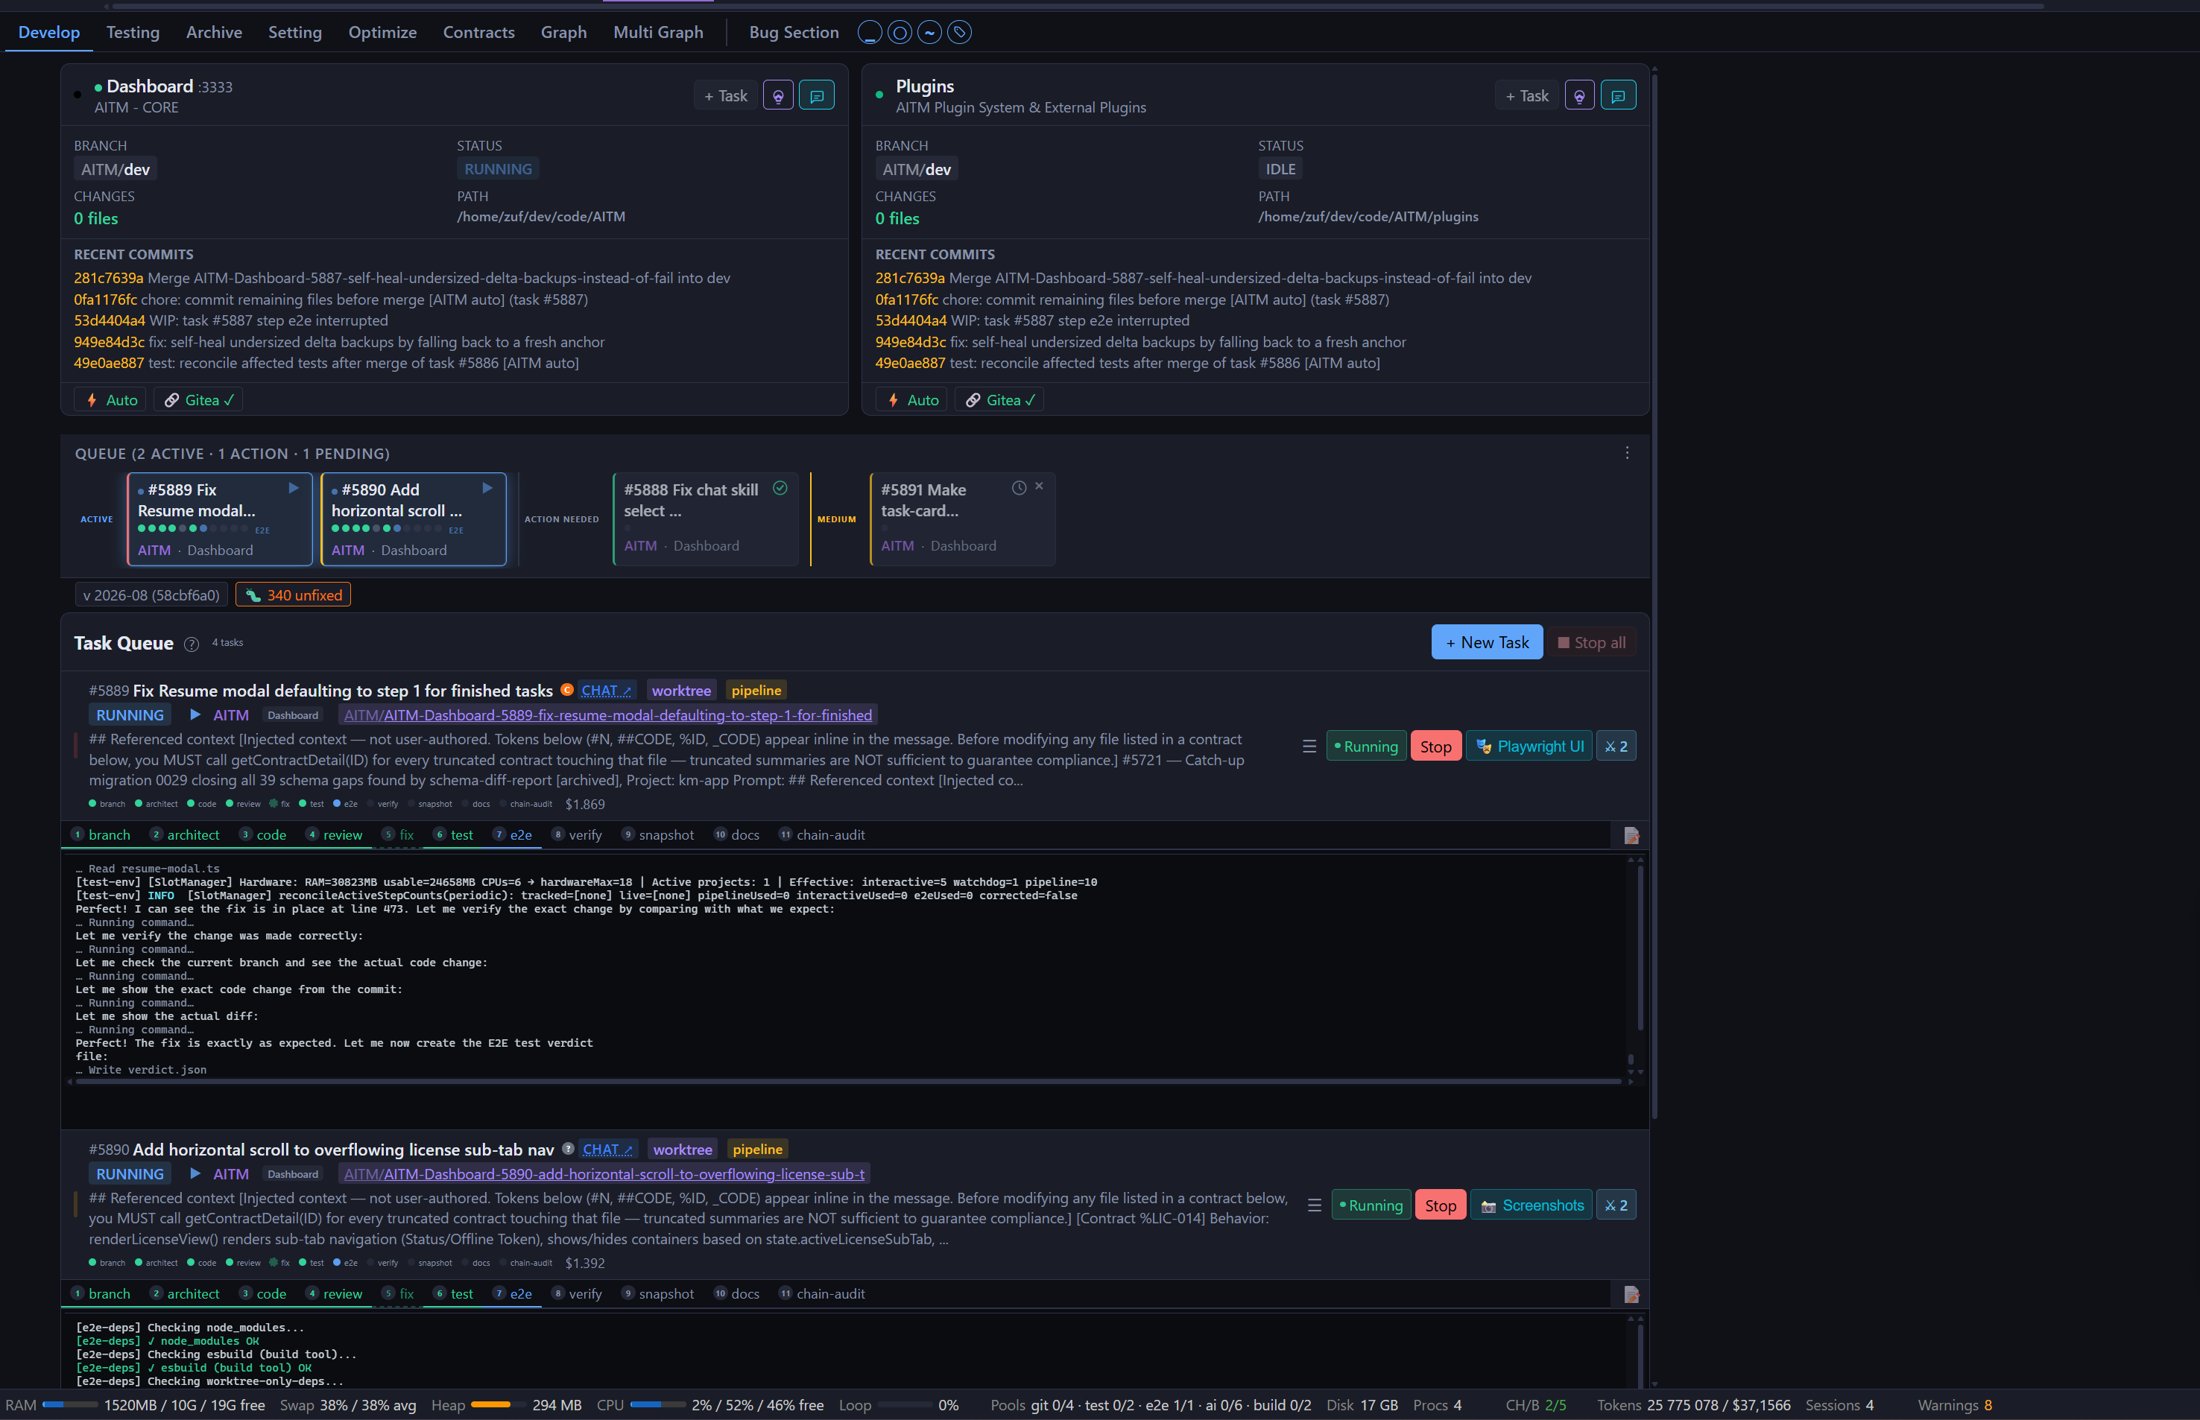
Dev Dashboard - Su centro de mando
Vea todos sus proyectos, pipelines activos, el estado de git y la cola de tareas de un vistazo. La consola en directo muestra a la IA trabajando en tiempo real. Arrastre y suelte las tareas para reordenar la prioridad.
Cómo funciona
Un pipeline de 12 pasos: desde una rama aislada, pasando por cumplimiento, revisión y pruebas, hasta la documentación y la auditoría de cadena. Después, la cola de merge lleva el resultado a dev.

Branch
Crea una rama y un worktree aislados para la tarea.

Architect
Planifica el cambio a partir del código del proyecto y los contratos.

Code
Implementa los cambios planificados.

Comprobación de cumplimiento
Comprueba las tareas complejas con respecto a sus requisitos; se omite en las tareas más simples.

Review
Revisa la implementación y emite un veredicto.

Fix
Resuelve los hallazgos de la revisión cuando es necesario.

Test
Ejecuta las pruebas automatizadas del proyecto.

E2E
Prueba los recorridos de usuario en la aplicación.

Verify
Comprueba el resultado con respecto a los criterios de aceptación.

Snapshot
Opcionalmente captura la interfaz para la comparación visual.

Docs
Actualiza la documentación y los contratos de comportamiento.

Auditoría de cadena
Vuelve a comprobar las tareas anteriores al final de una cadena de tareas.
Guía del usuario
Aprenda a usar cada función. Haga clic para expandir.
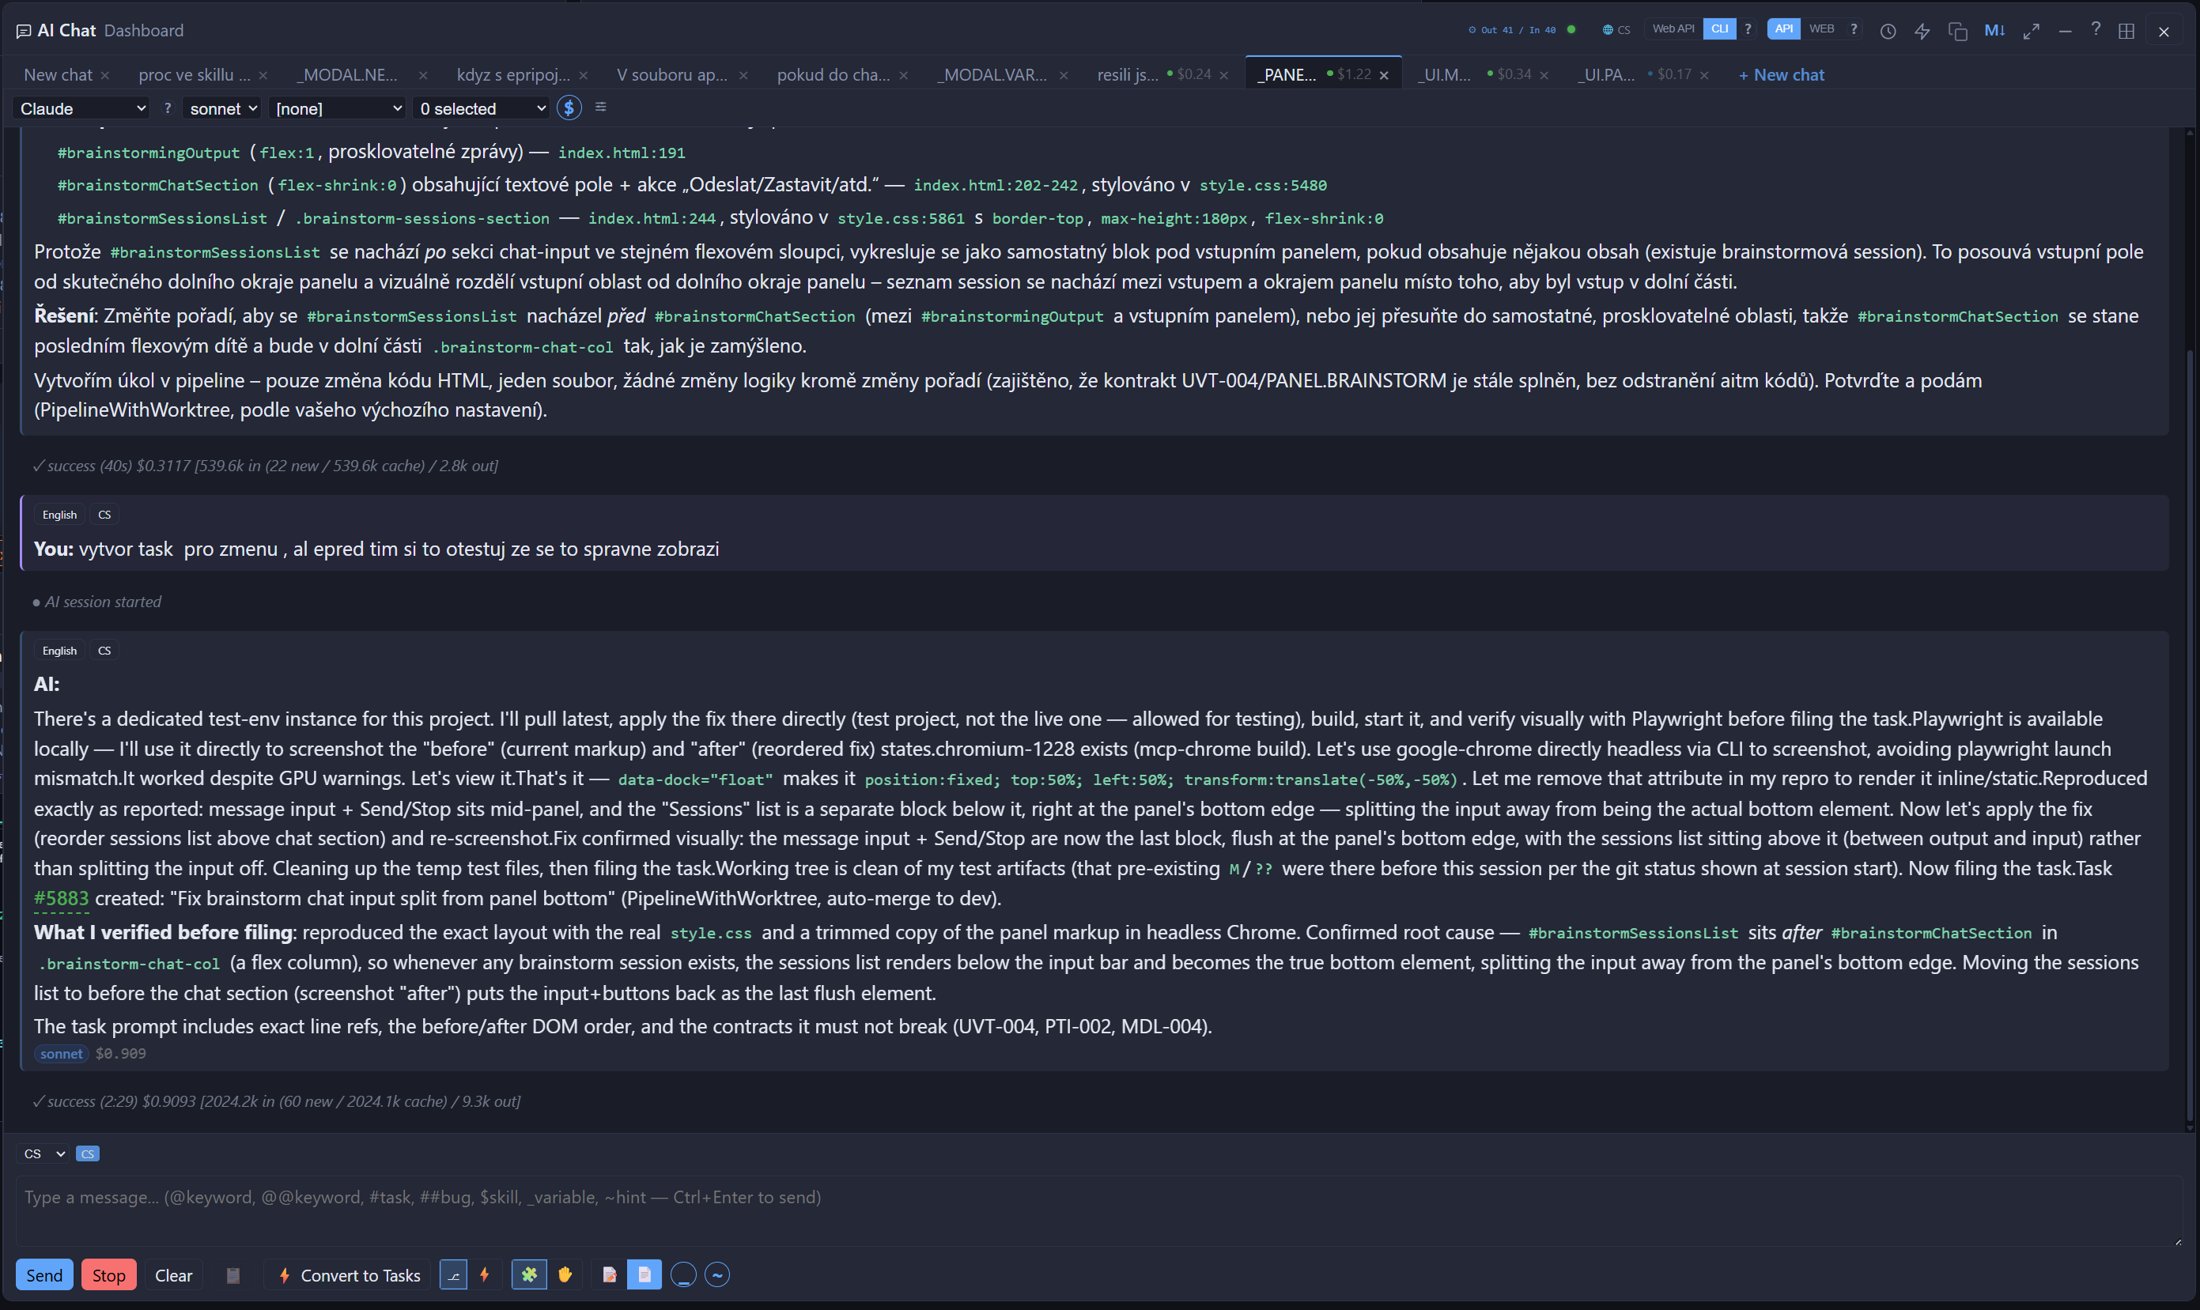
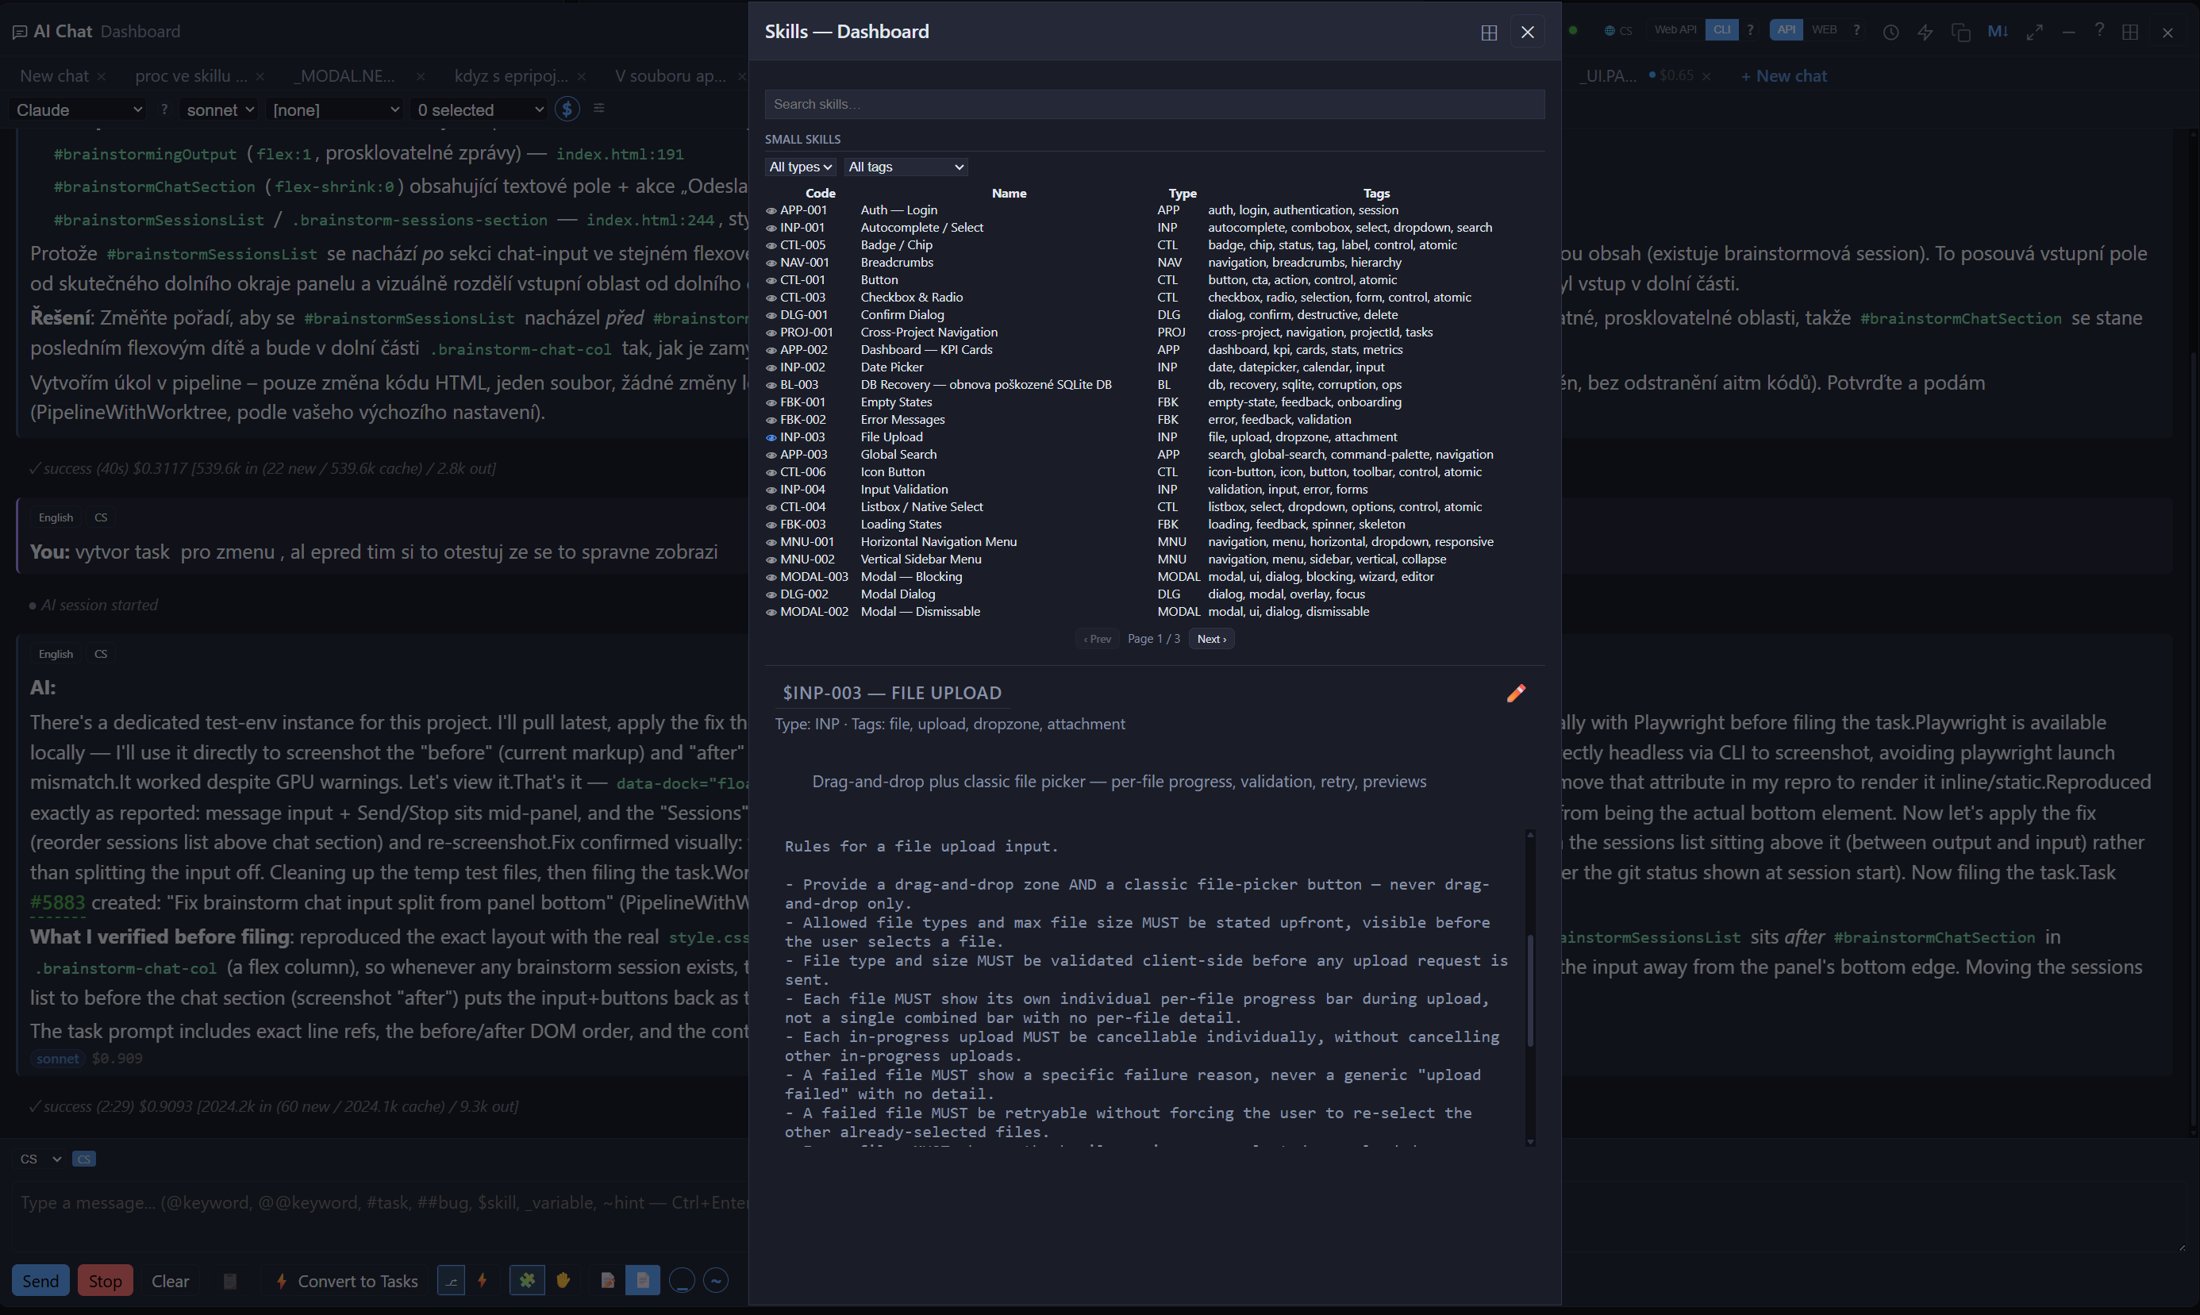
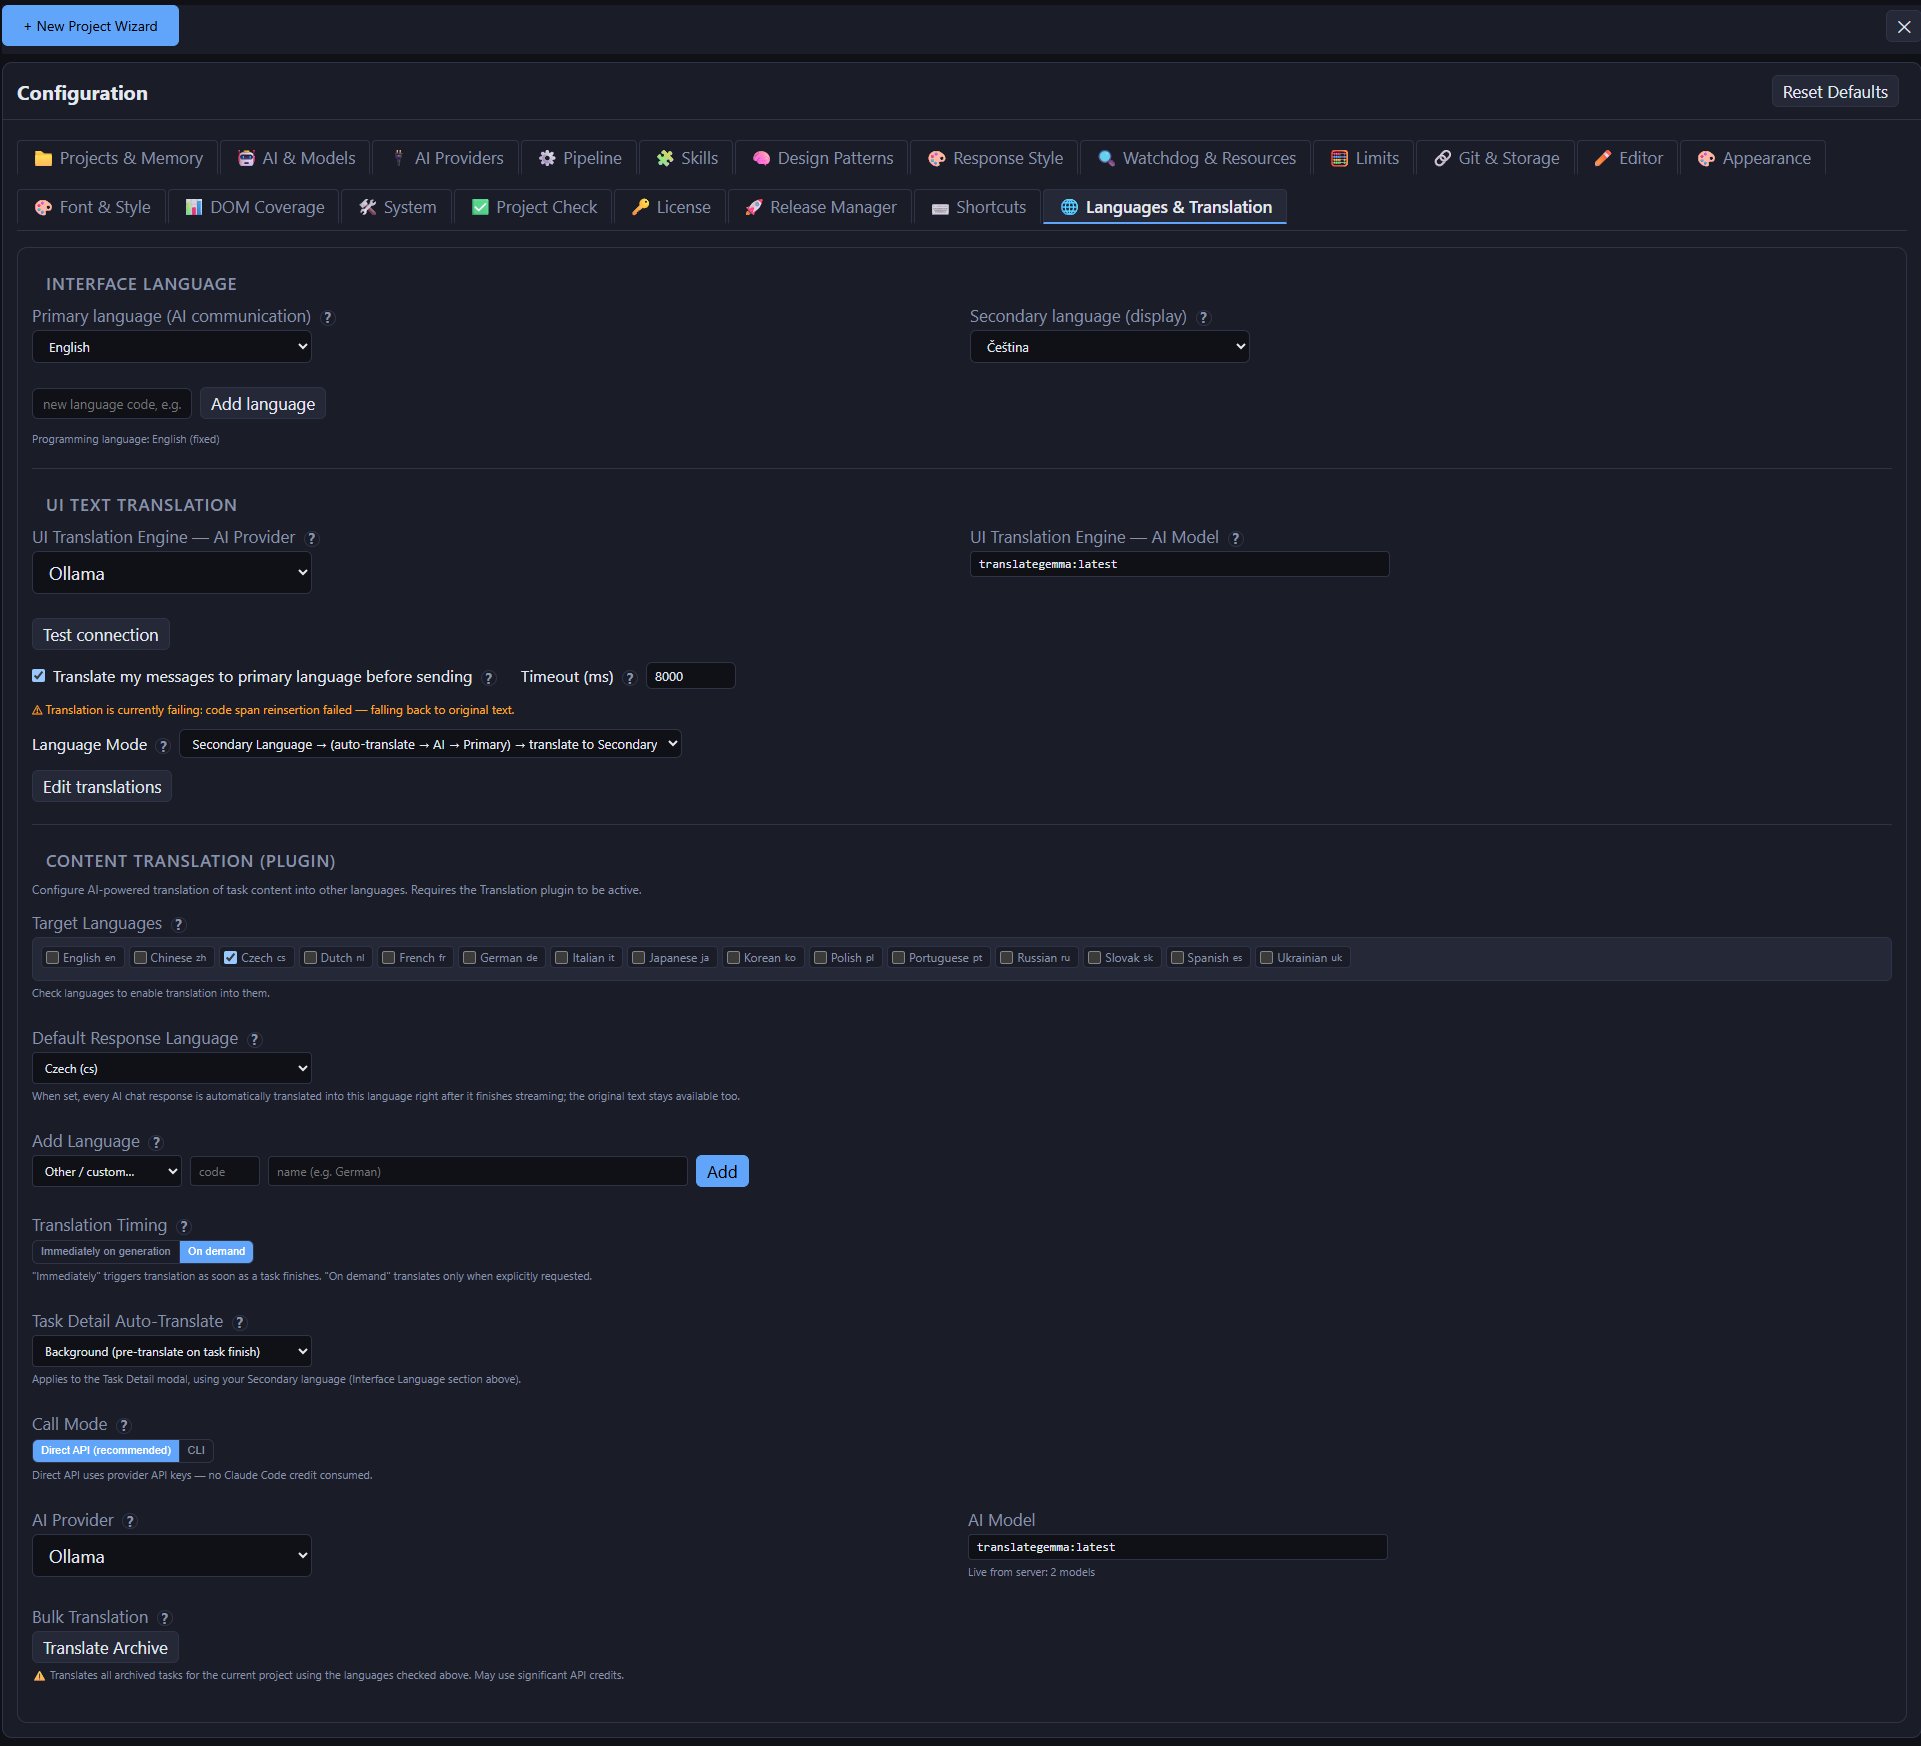
AITM genera su código
La IA se encarga de la programación rutinaria para que los equipos avancen más rápido. La IA escribe el código con los modelos que usted elija. Su equipo asigna el trabajo, lo revisa y decide.
Nuevas funcionalidades y módulos completos a partir de una descripción en lenguaje sencillo
Corrección de errores con reproducción obligatoria: la tarea demuestra primero el error y, tras la corrección, demuestra que ha desaparecido
Refactorización y modernización de código bases grandes y longevos sin ningún riesgo para la rama principal
Pruebas unitarias, escenarios de extremo a extremo y documentación que se generan y mantienen solos
Decenas de tareas en paralelo, cada una en su propia copia aislada del proyecto
Todo en el servidor, nada en los equipos de trabajo
AITM se ejecuta en su servidor y los usuarios trabajan desde el navegador. El código fuente, los worktrees y los datos nunca salen del servidor.
El servidor soporta la carga
Las compilaciones, las pruebas y los agentes de IA se ejecutan en el servidor. Los equipos de trabajo se mantienen ligeros y no se instala nada en ellos.
Entorno Docker aislado
AITM se ejecuta en contenedores separados de otros sistemas, con almacenamiento propio para proyectos, worktrees y datos.
Cifrado en reposo
Las bases de datos, los resultados de las tareas, los prompts, los artefactos y las copias de seguridad se cifran con AES-256. Un disco robado o una copia de seguridad filtrada resultan ilegibles.
Su código permanece en su red
AITM es autoalojado. Usted elige el proveedor de IA para cada paso, incluido un modelo local de Ollama, de modo que un proyecto sensible nunca tiene que salir de su infraestructura.
Cada cambio aislado
Cada tarea obtiene su propia rama y worktree de git. Solo llega a la rama principal tras la revisión, las pruebas y una comprobación de compilación.
Registro de auditoría completo
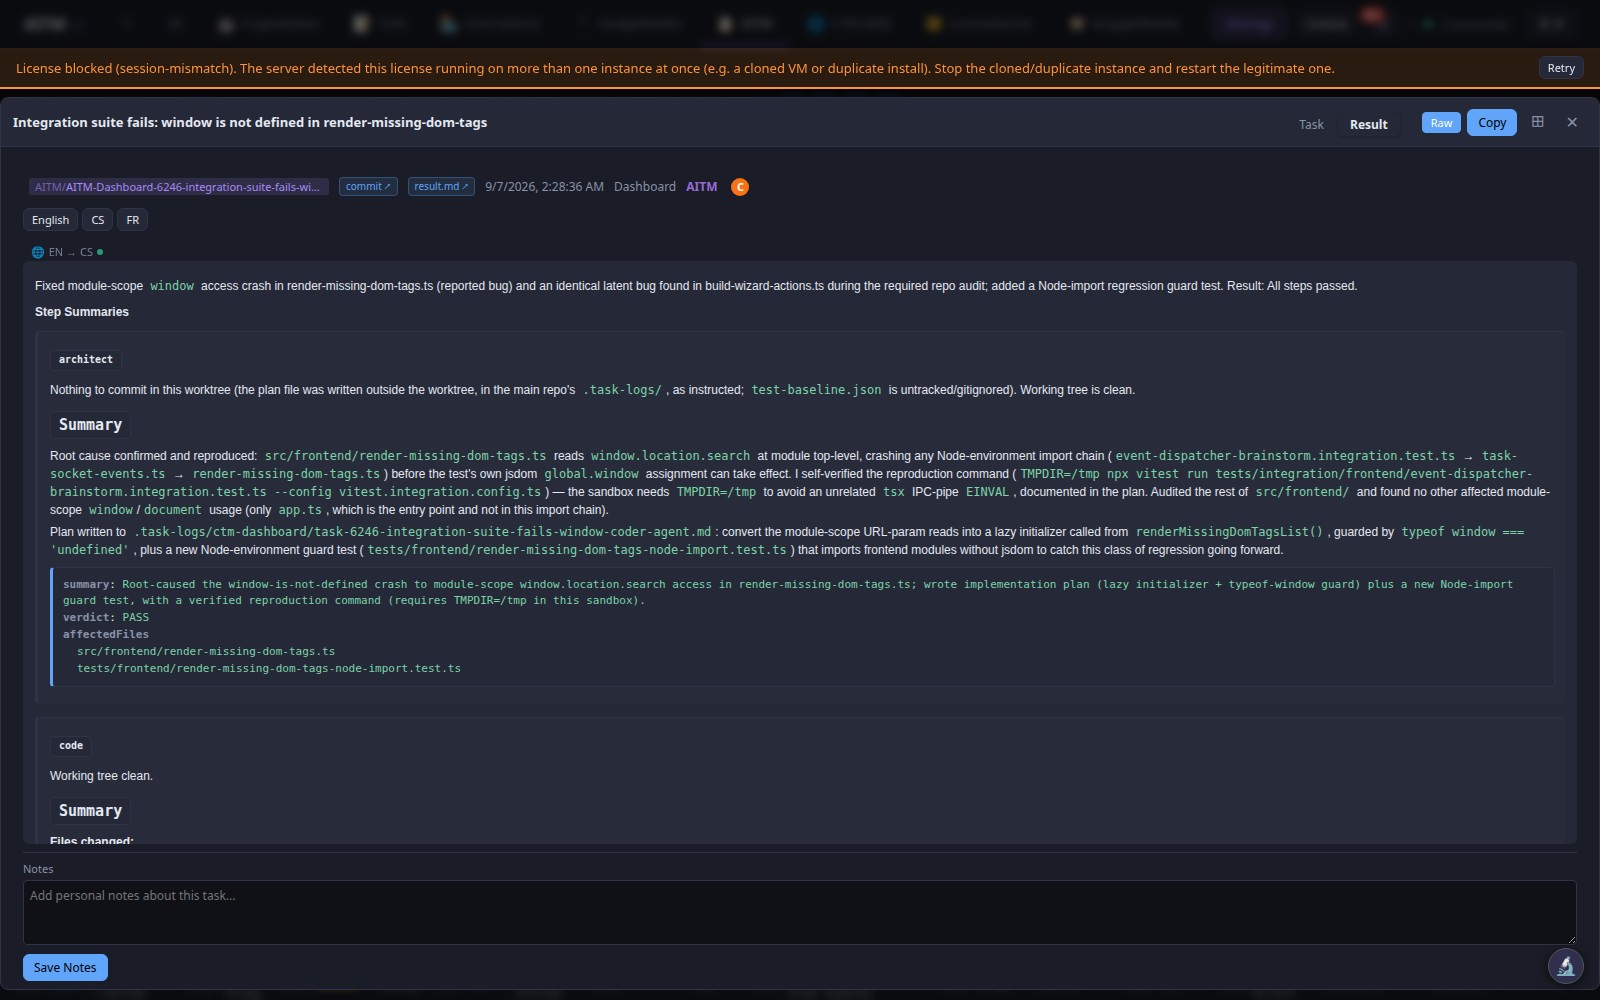
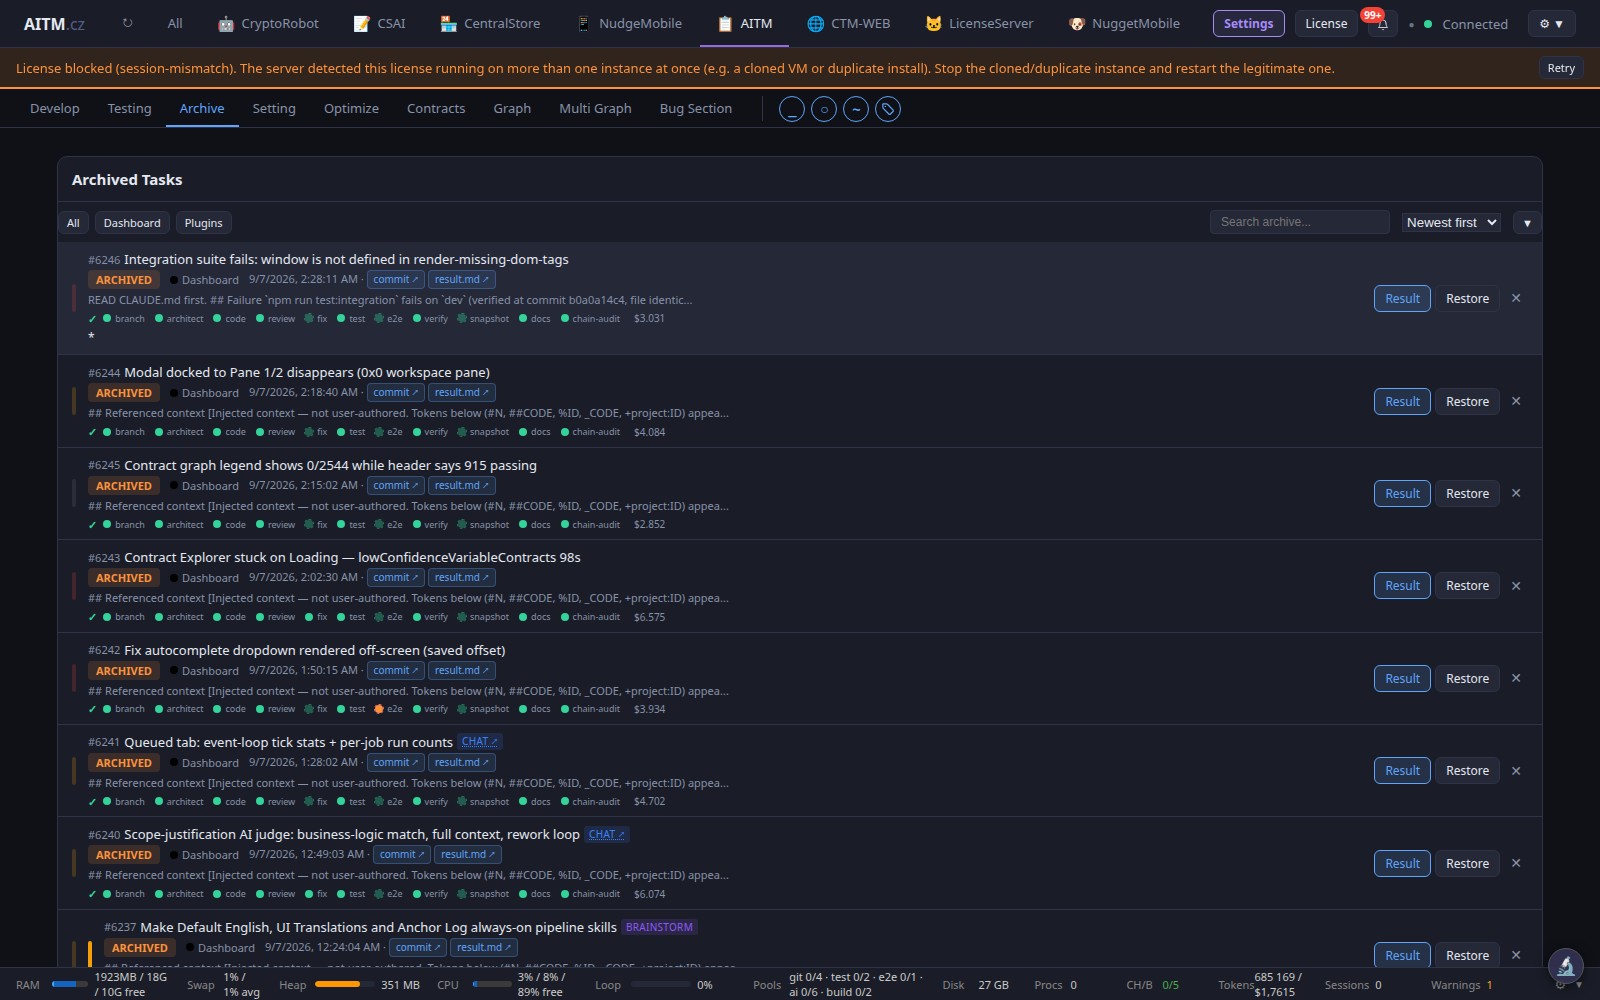
Cada paso tiene un registro, un veredicto y un motivo. Siempre puede rastrear quién pidió qué, qué cambió la IA y por qué se aprobó.
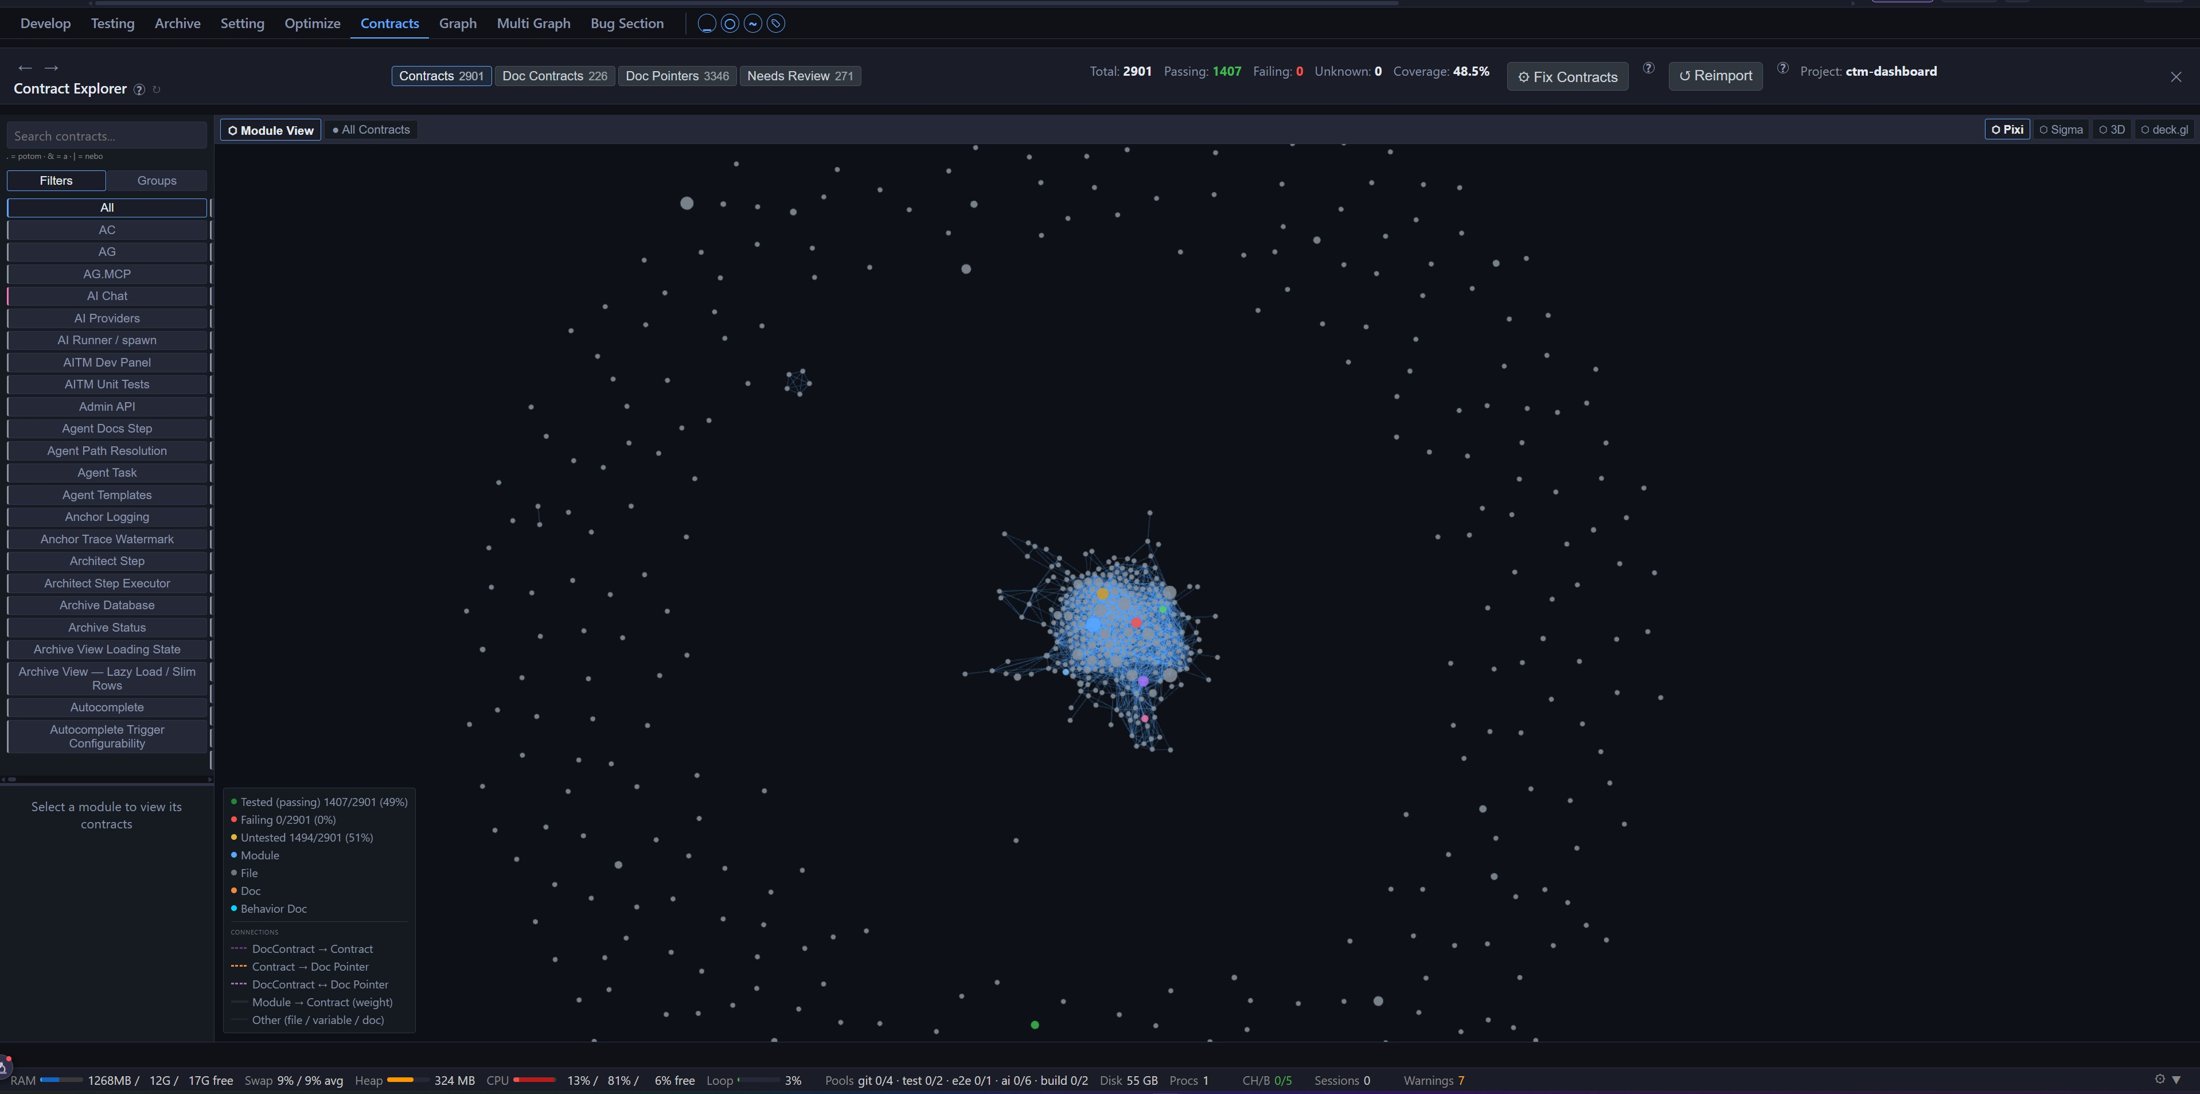
IA que conoce su proyecto
AITM no deja que la IA lea el repositorio a ciegas. Los contratos, el mapa de la interfaz y el grafo de conocimiento se inyectan en cada tarea, por lo que edita el lugar correcto. El agente architect, el coder, el reviewer y el agente fix trabajan en una sola pasada; usted lee el resultado, no un chat. La cola de merge resuelve los conflictos por usted.
Entregas en las que puede confiar
Cada cambio se revisa, se prueba, se documenta y es trazable. El desarrollo sigue funcionando las 24 horas y el pipeline se repara solo en lugar de esperar a una persona. Usted controla el coste eligiendo el modelo de cada paso. La seguridad forma parte del diseño, no es un añadido.
Usted decide QUÉ. AITM se encarga del CÓMO.
¿Por qué AITaskManager?
Todo lo que tendría que hacer a mano con una herramienta de programación con IA básica, automatizado.
No vuelva a tocar una terminal
Branch, architect, code, compliance-check, review, fix, test, e2e, verify, snapshot, docs, chain-audit: un solo pipeline ejecuta cada paso por usted y luego integra el resultado en dev. Omita cualquier paso o reanude tras un fallo.
La mejor IA para cada tarea
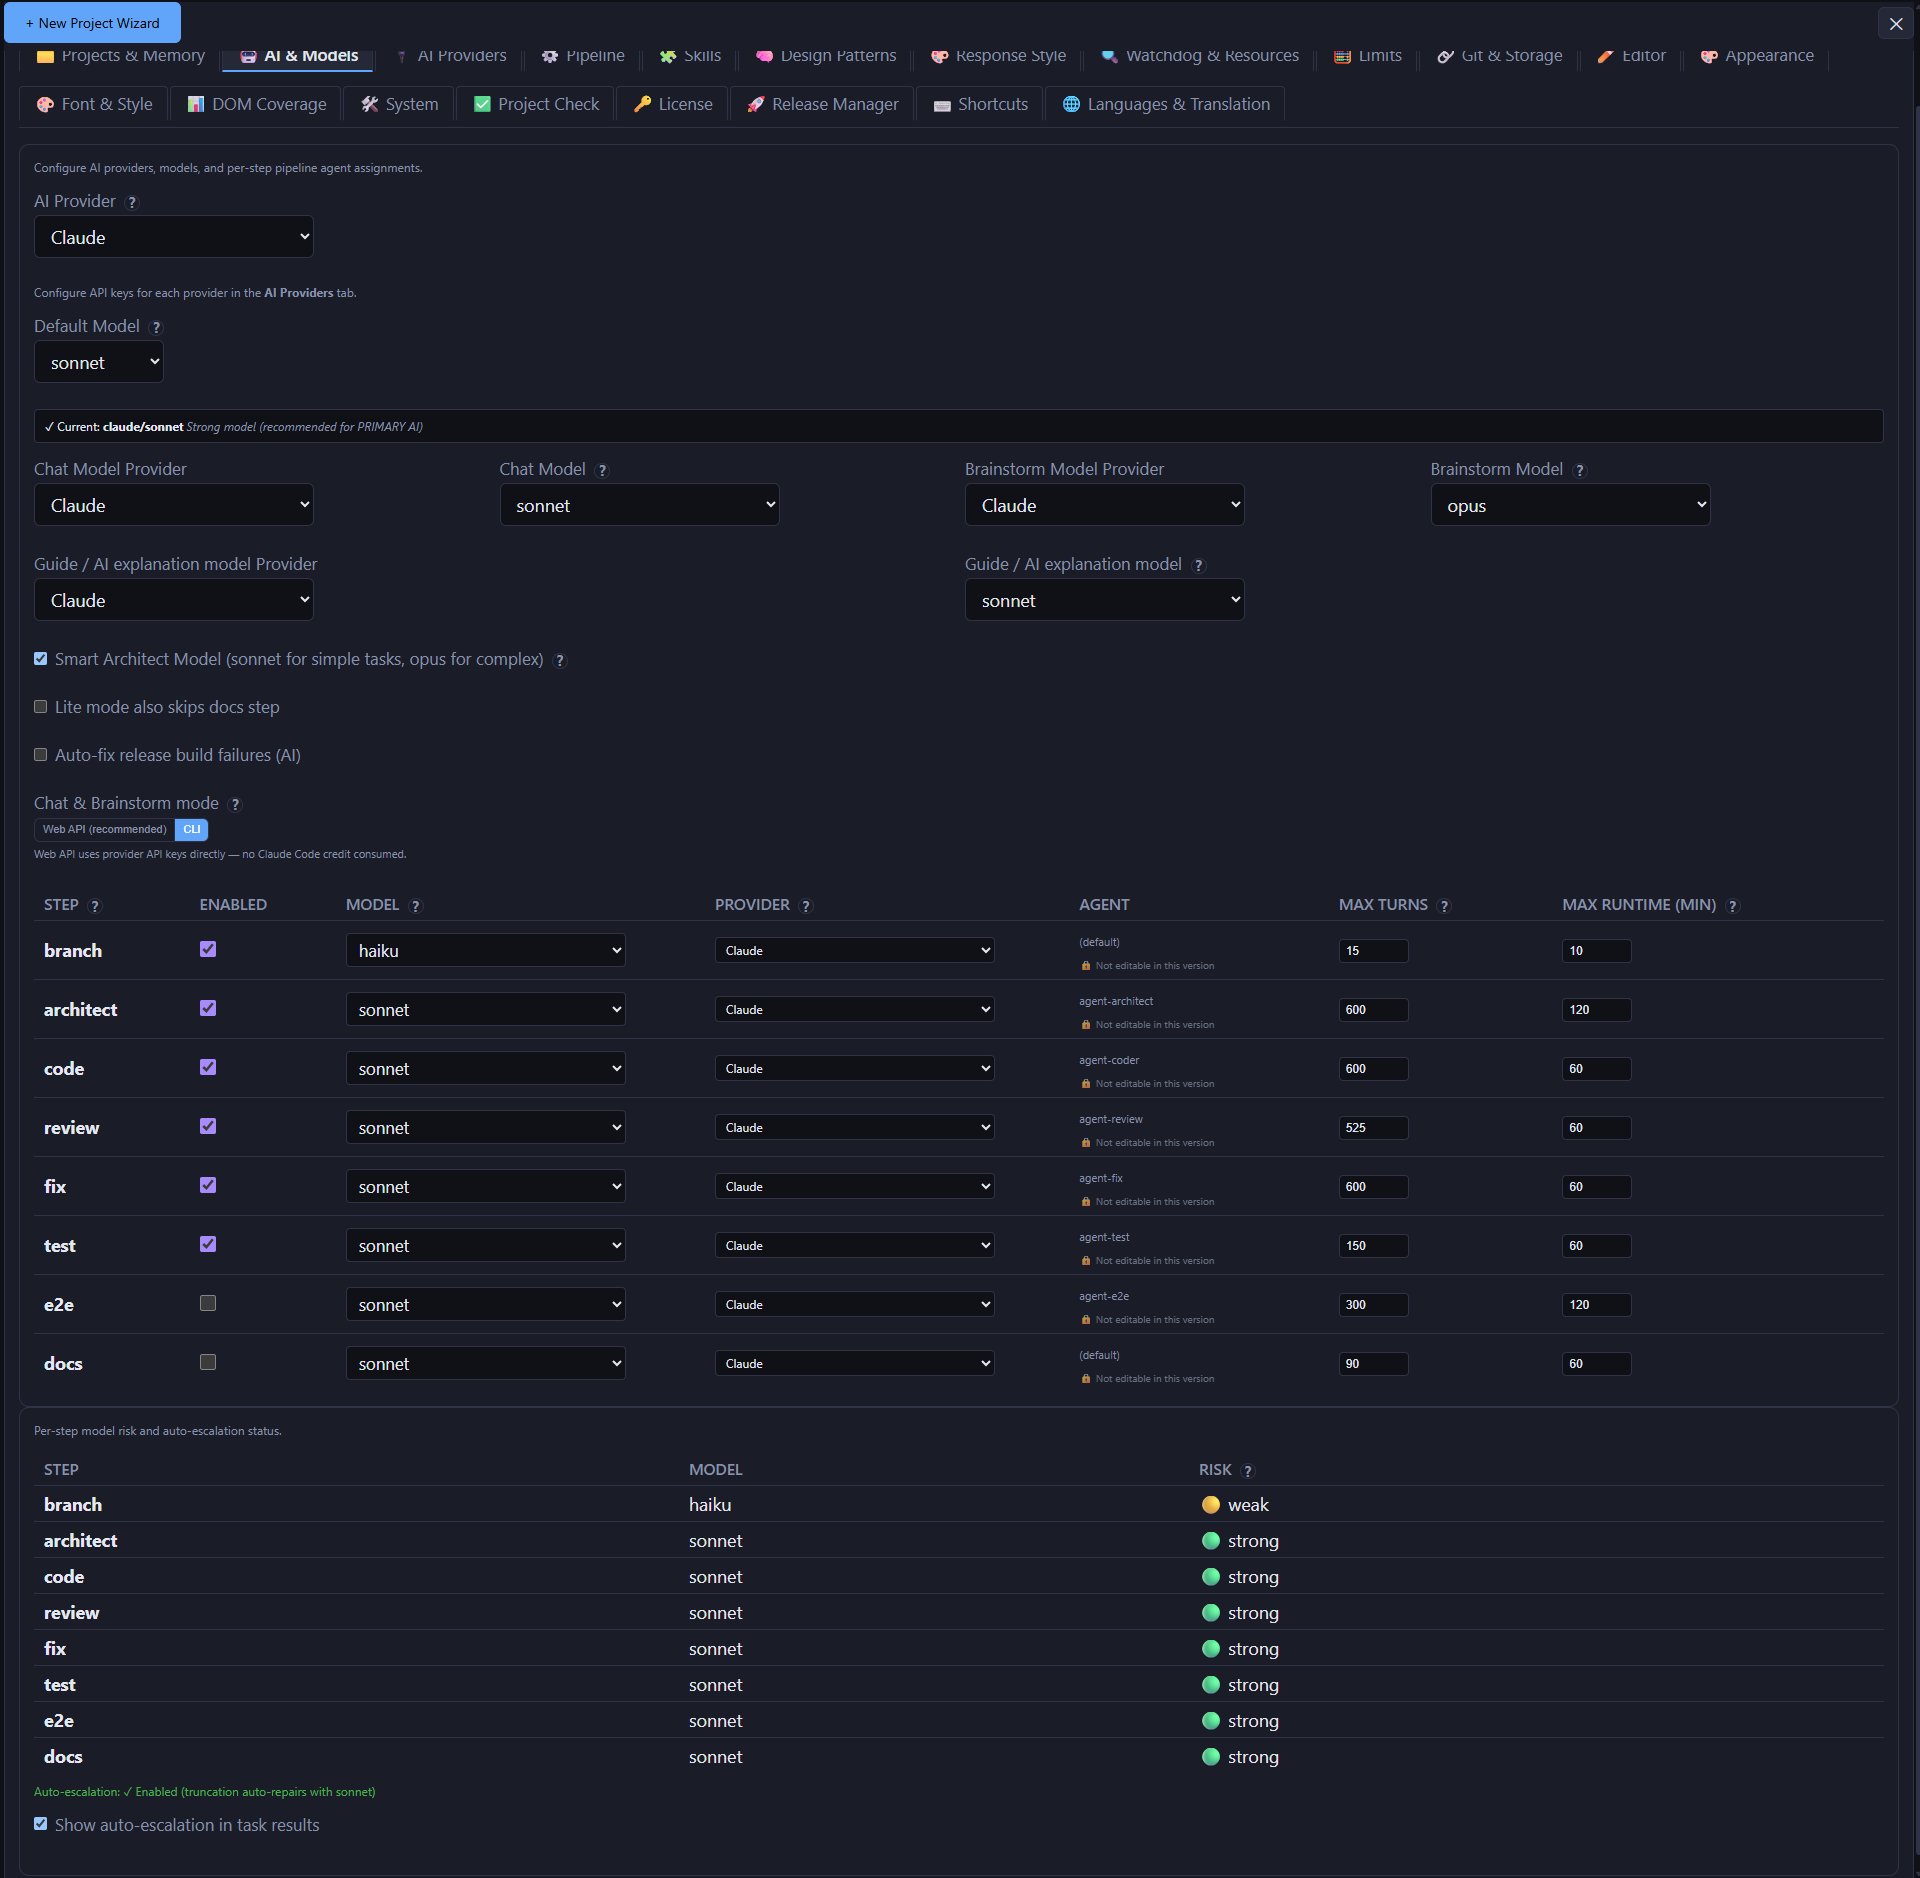
Claude para el código, Gemini u OpenAI para la revisión, DeepSeek o modelos alojados en NVIDIA para las pruebas, un modelo local de Ollama para los pasos mecánicos: elija el proveedor y el modelo de forma independiente para cada paso del pipeline y reduzca costes sin perder calidad.
Basta de APIs alucinadas
Cada funcionalidad es un contrato de comportamiento comprobable. La IA lo lee antes de programar, así que deja de adivinar rutas de archivos e inventar métodos que no existen.
Su rama principal siempre está a salvo
Cada tarea se ejecuta en su propio worktree y rama. Nada toca dev hasta que esté probado y revisado.
Publique sin probar manualmente
Las pruebas unitarias y Playwright E2E se ejecutan automáticamente en cada tarea, y un paso opcional de snapshot puede capturar pantallas para detectar más fácilmente fallos en la interfaz.
Vea exactamente cómo es su código base
Un grafo de dependencias interactivo muestra comunidades de archivos, god nodes y relaciones de importación: se acabó adivinar qué toca un archivo.
Convierta una conversación en una tarea con un clic
Chatee con todo el contexto del proyecto, haga brainstorming del enfoque y envíelo directamente a la cola.
Se recupera para que usted no tenga que hacerlo
Un watchdog en segundo plano detecta tareas atascadas y procesos zombi y reinicia automáticamente los pasos fallidos.
Su IA aprende los patrones de su código base
Los hints reutilizables inyectan convenciones específicas del proyecto en cada prompt: escriba ~hint para obtener contexto al instante.
Gestione cada proyecto desde una sola pantalla
Cambie de contexto al instante, ponga tareas en cola entre proyectos y siga el progreso en todas partes a la vez.
Observe a la IA trabajar en tiempo real
Transparencia total sobre cada comando, cambio de archivo y decisión a medida que ocurre.
Ponga en cola esta noche y despierte con funciones ya fusionadas
Ponga en cola 20 tareas antes de dormir con prioridades y dependencias: AITM las ejecuta una tras otra mientras usted duerme.
AITM aprende su proyecto
Cuanto más trabaja AITM en su base de código, menos tiene que volver a descubrir cada vez.
Los contratos de comportamiento recogen lo que hace su código: se comprueban antes de cada edición y se sincronizan tras cada fusión.
Un grafo de conocimiento enlaza variables, contratos, elementos DOM, pruebas y documentación en una sola consulta.
Importe un repositorio y AITM mapea su stack, código e interfaz antes de que se ejecute la primera tarea.
Las plantillas de agente compartidas y los traspasos estructurados mantienen a cada sesión de IA, y a cada proveedor, en la misma página.
Qué modelos de IA impulsan AITM
AITM es una capa de extensión, no un modelo: orquesta la IA que usted elija.
Usted aporta el modelo
AITM requiere un modelo de IA de pago de terceros (Claude, OpenAI o DeepSeek) o un modelo local autoalojado. Los modelos locales aún no alcanzan la calidad de código que necesita el pipeline de AITM, por lo que son más adecuados para tareas ligeras. Claude Sonnet en nivel bajo es la opción más usada y de mejor rendimiento para codificación, revisión y corrección. Fable se usa ocasionalmente para planificar tareas y hacer brainstorming. De OpenAI y DeepSeek solo se usa el mejor modelo disponible en cada momento.
Por qué menos alucinaciones
Un sistema agéntico simple vuelve a inferir desde cero cómo se comporta su base de código en cada tarea. En cambio, AITM mantiene un mapa persistente y actualizado continuamente de su proyecto (contratos de comportamiento, variables, el mapa del DOM y un grafo de conocimiento) con el que cada paso del pipeline contrasta en lugar de adivinar. Esta precisión mejora cuanto más tiempo se usa AITM en un proyecto y es menor en un proyecto recién importado, donde los contratos aún se están construyendo.
Por qué menor coste
La ventaja de coste de AITM proviene de enrutar distintos pasos del pipeline a distintos modelos según la complejidad de cada paso, incluidos modelos más baratos cuando un paso más simple no necesita uno de primer nivel. Esto reduce el coste en dólares de completar una tarea: es una reducción del coste del modelo mediante enrutamiento, no una reducción del uso de tokens.
Por qué AITM es más fiable que un agente de IA simple
En comparación con pedirle cosas a la IA manualmente en una ventana de chat.
Stop Babysitting Your AI. Start Shipping.
Every night you skip is a night of merged features you didn't ship. Queue your backlog now — AITM starts orchestrating the moment it launches.
v1.0.0 ya disponible Pick a duration and a time that works for you — we'll send a confirmation link to your email.
Check your email
We've sent a confirmation link to your email address. Click it to confirm your call.
Cómo trabaja AITM con la IA
Cómo se gestionan el tamaño del prompt y el contexto a lo largo del pipeline.
Tamaño del prompt por paso del pipeline
Cada paso del pipeline (Architect, Code, Review, Fix, Test, Docs) parte de un prompt enfocado y específico del paso, en lugar de un único prompt gigante para todo. Los pasos posteriores que necesitan más contexto (como Code) acumulan un contexto de trabajo mayor a medida que exploran la tarea; los pasos anteriores o más acotados (como Docs) se mantienen relativamente pequeños. En todos los casos, el contexto de trabajo se mantiene bien dentro de la ventana de tokens del modelo configurado.
Reutilizar en lugar de reenviar
La parte estable de cada prompt (rol, reglas, herramientas) es idéntica en todos los pasos, por lo que se sirve desde la caché de prompts del proveedor de IA: normalmente solo se necesita una pequeña cantidad de entrada nueva por paso, mientras que la mayor parte del contexto se reutiliza en lugar de reenviarse.
Conocimiento del proyecto, no lectura de archivos
La IA consulta primero el conocimiento del proyecto (variables, contratos de lógica de negocio, el mapa de la UI y luego el código) antes de leer archivos, de modo que cada paso parte de hechos verificados del proyecto.
Ajustado para cada modelo de IA
| Proveedor | Ventana de contexto |
|---|---|
| Claude | 200K |
| Gemini | 1M |
| OpenAI | 128K |
| NVIDIA | 128K |
| DeepSeek | 64K |
| Ollama local (predeterminado) | 8K |
Los modelos con ventanas de contexto más pequeñas o razonamiento más débil reciben una versión más compacta del prompt que conserva las mismas reglas de trabajo, de modo que incluso un modelo local sigue el mismo proceso.
Un solo sistema: GUI, pipeline, datos y contratos
AITM no sustituye a Claude Code, Cursor ni a su herramienta de programación con IA favorita: las orquesta. Apúntelo a los mismos modelos que ya usa; añade el pipeline, la red de seguridad y la memoria del proyecto a su alrededor.
Una capa visual que realmente puede ver
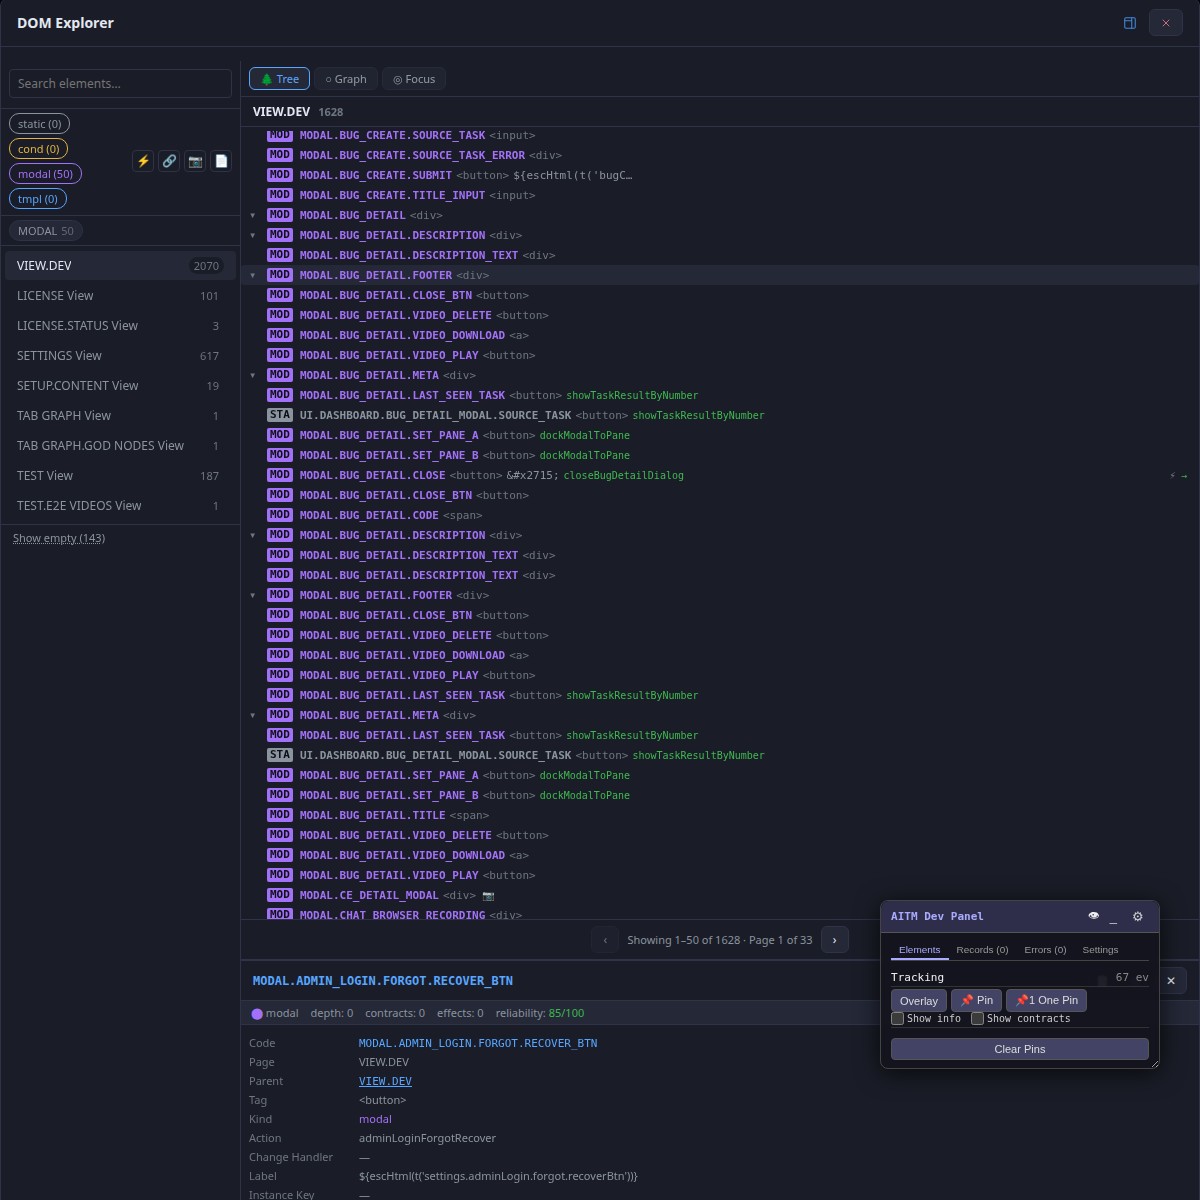
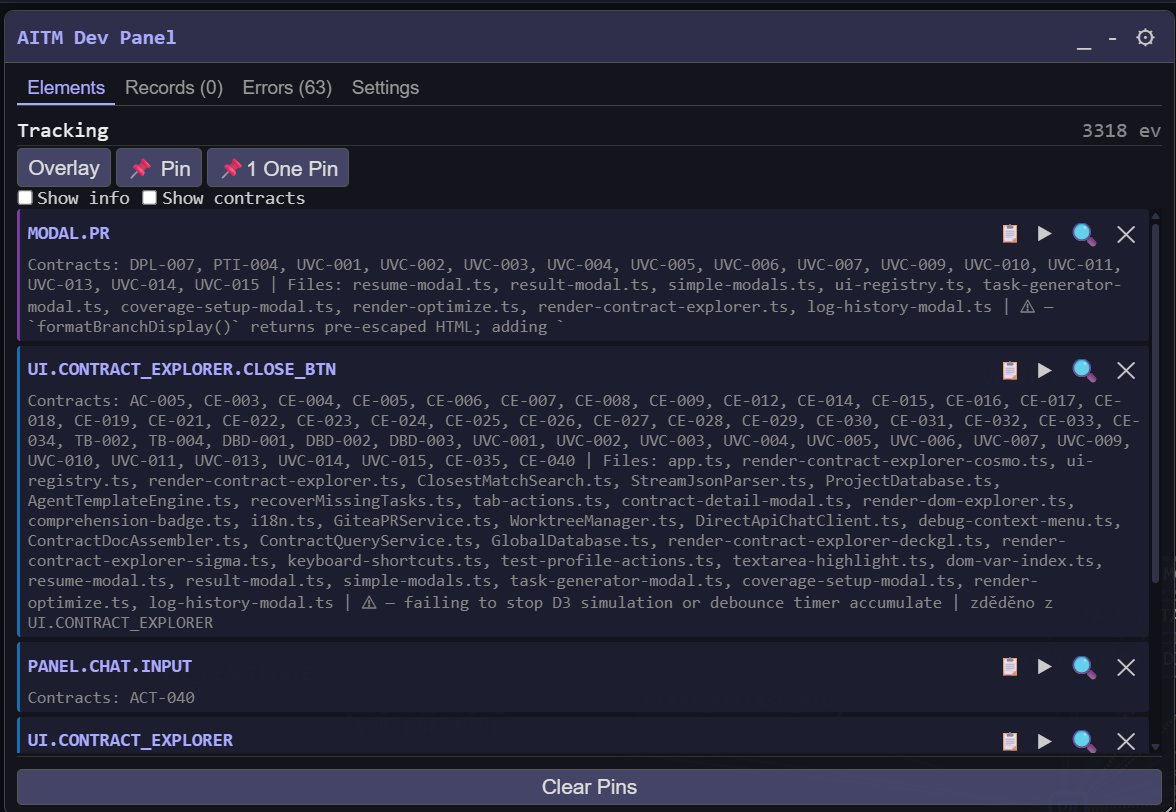
Un panel en vivo muestra cada proyecto, pipeline en ejecución y tarea en cola en tiempo real. El DOM Explorer asocia cada elemento de la interfaz con su data-aitm código, y el historial de capturas conserva un registro visual de cómo cambió cada pantalla con el tiempo.
Un pipeline, no una ventana de chat
Un solo prompt ejecuta el pipeline completo de 12 pasos: branch → architect → code → compliance-check → review → fix → test → e2e → verify → snapshot → docs → chain-audit, y luego la cola de merge integra el cambio en dev. Cada tarea obtiene su propio git worktree aislado, por lo que su rama principal nunca se toca durante la ejecución, y un watchdog detecta los pasos bloqueados y los reintenta automáticamente.
Todo se almacena, nada se adivina
Cada proyecto tiene su propia base de datos con contratos de comportamiento e historial de tareas. Una base de datos global contiene los ajustes, los hints y el registro de variables compartido entre proyectos. Cada tarea conserva su propia carpeta de logs y su resultado archivado, así que puede volver a cualquier ejecución más tarde.
Separación estricta de datos entre proyectos
Los datos de un proyecto nunca se mezclan con los de otro: cada proyecto tiene su propio archivo de base de datos. El trabajo en curso permanece en su propio worktree hasta que se revisa, se prueba y se fusiona, así que nada a medio terminar llega a la rama principal.
Datos, lógica de negocio y GUI están vinculados
Cada elemento de la interfaz lleva un data-aitm código vinculado a un contrato de comportamiento que describe su comportamiento esperado y apunta al archivo fuente y a la variable exactos en el código. Los agentes de IA leen esa especificación verificada en lugar de adivinar la intención a partir del código fuente.