Cada sesión de IA en AITM — ya sea la del Agent que programa, la del que revisa o un Chat que se mantiene ahora mismo — se nutre de la misma base de conocimiento compartida y siempre actualizada, en lugar de partir de una página en blanco.
Knowledge & Document Sharing
Contracts — la ficha de datos del proyecto
Un Contract es un hecho guardado sobre cómo se comporta una pieza concreta del proyecto — una nota breve y estructurada que describe qué hace una parte del código, qué archivos intervienen y con qué hay que tener cuidado. Los Contracts se crean y actualizan automáticamente después de que los Tasks se fusionan, según lo que realmente cambió. Antes de escribir código, un Agent lee los Contracts relevantes para su encargo, ve las "zonas de peligro" señaladas donde un cambio pequeño ha tenido históricamente consecuencias desproporcionadas, y puede encontrar precedentes de Tasks anteriores que tocaron la misma área.
El knowledge graph
Los Contracts no existen de forma aislada. AITM mantiene un knowledge graph para cada proyecto que conecta variables (códigos con notación de puntos como UI.PANEL.CHAT o BL.PIPELINE), Contracts, elementos DOM, capturas de pantalla y documentación — todo con referencias cruzadas. Al buscar una variable se encuentran los Contracts, archivos y capturas conectados a ella; al buscar un Contract se encuentran las variables y archivos que rige.
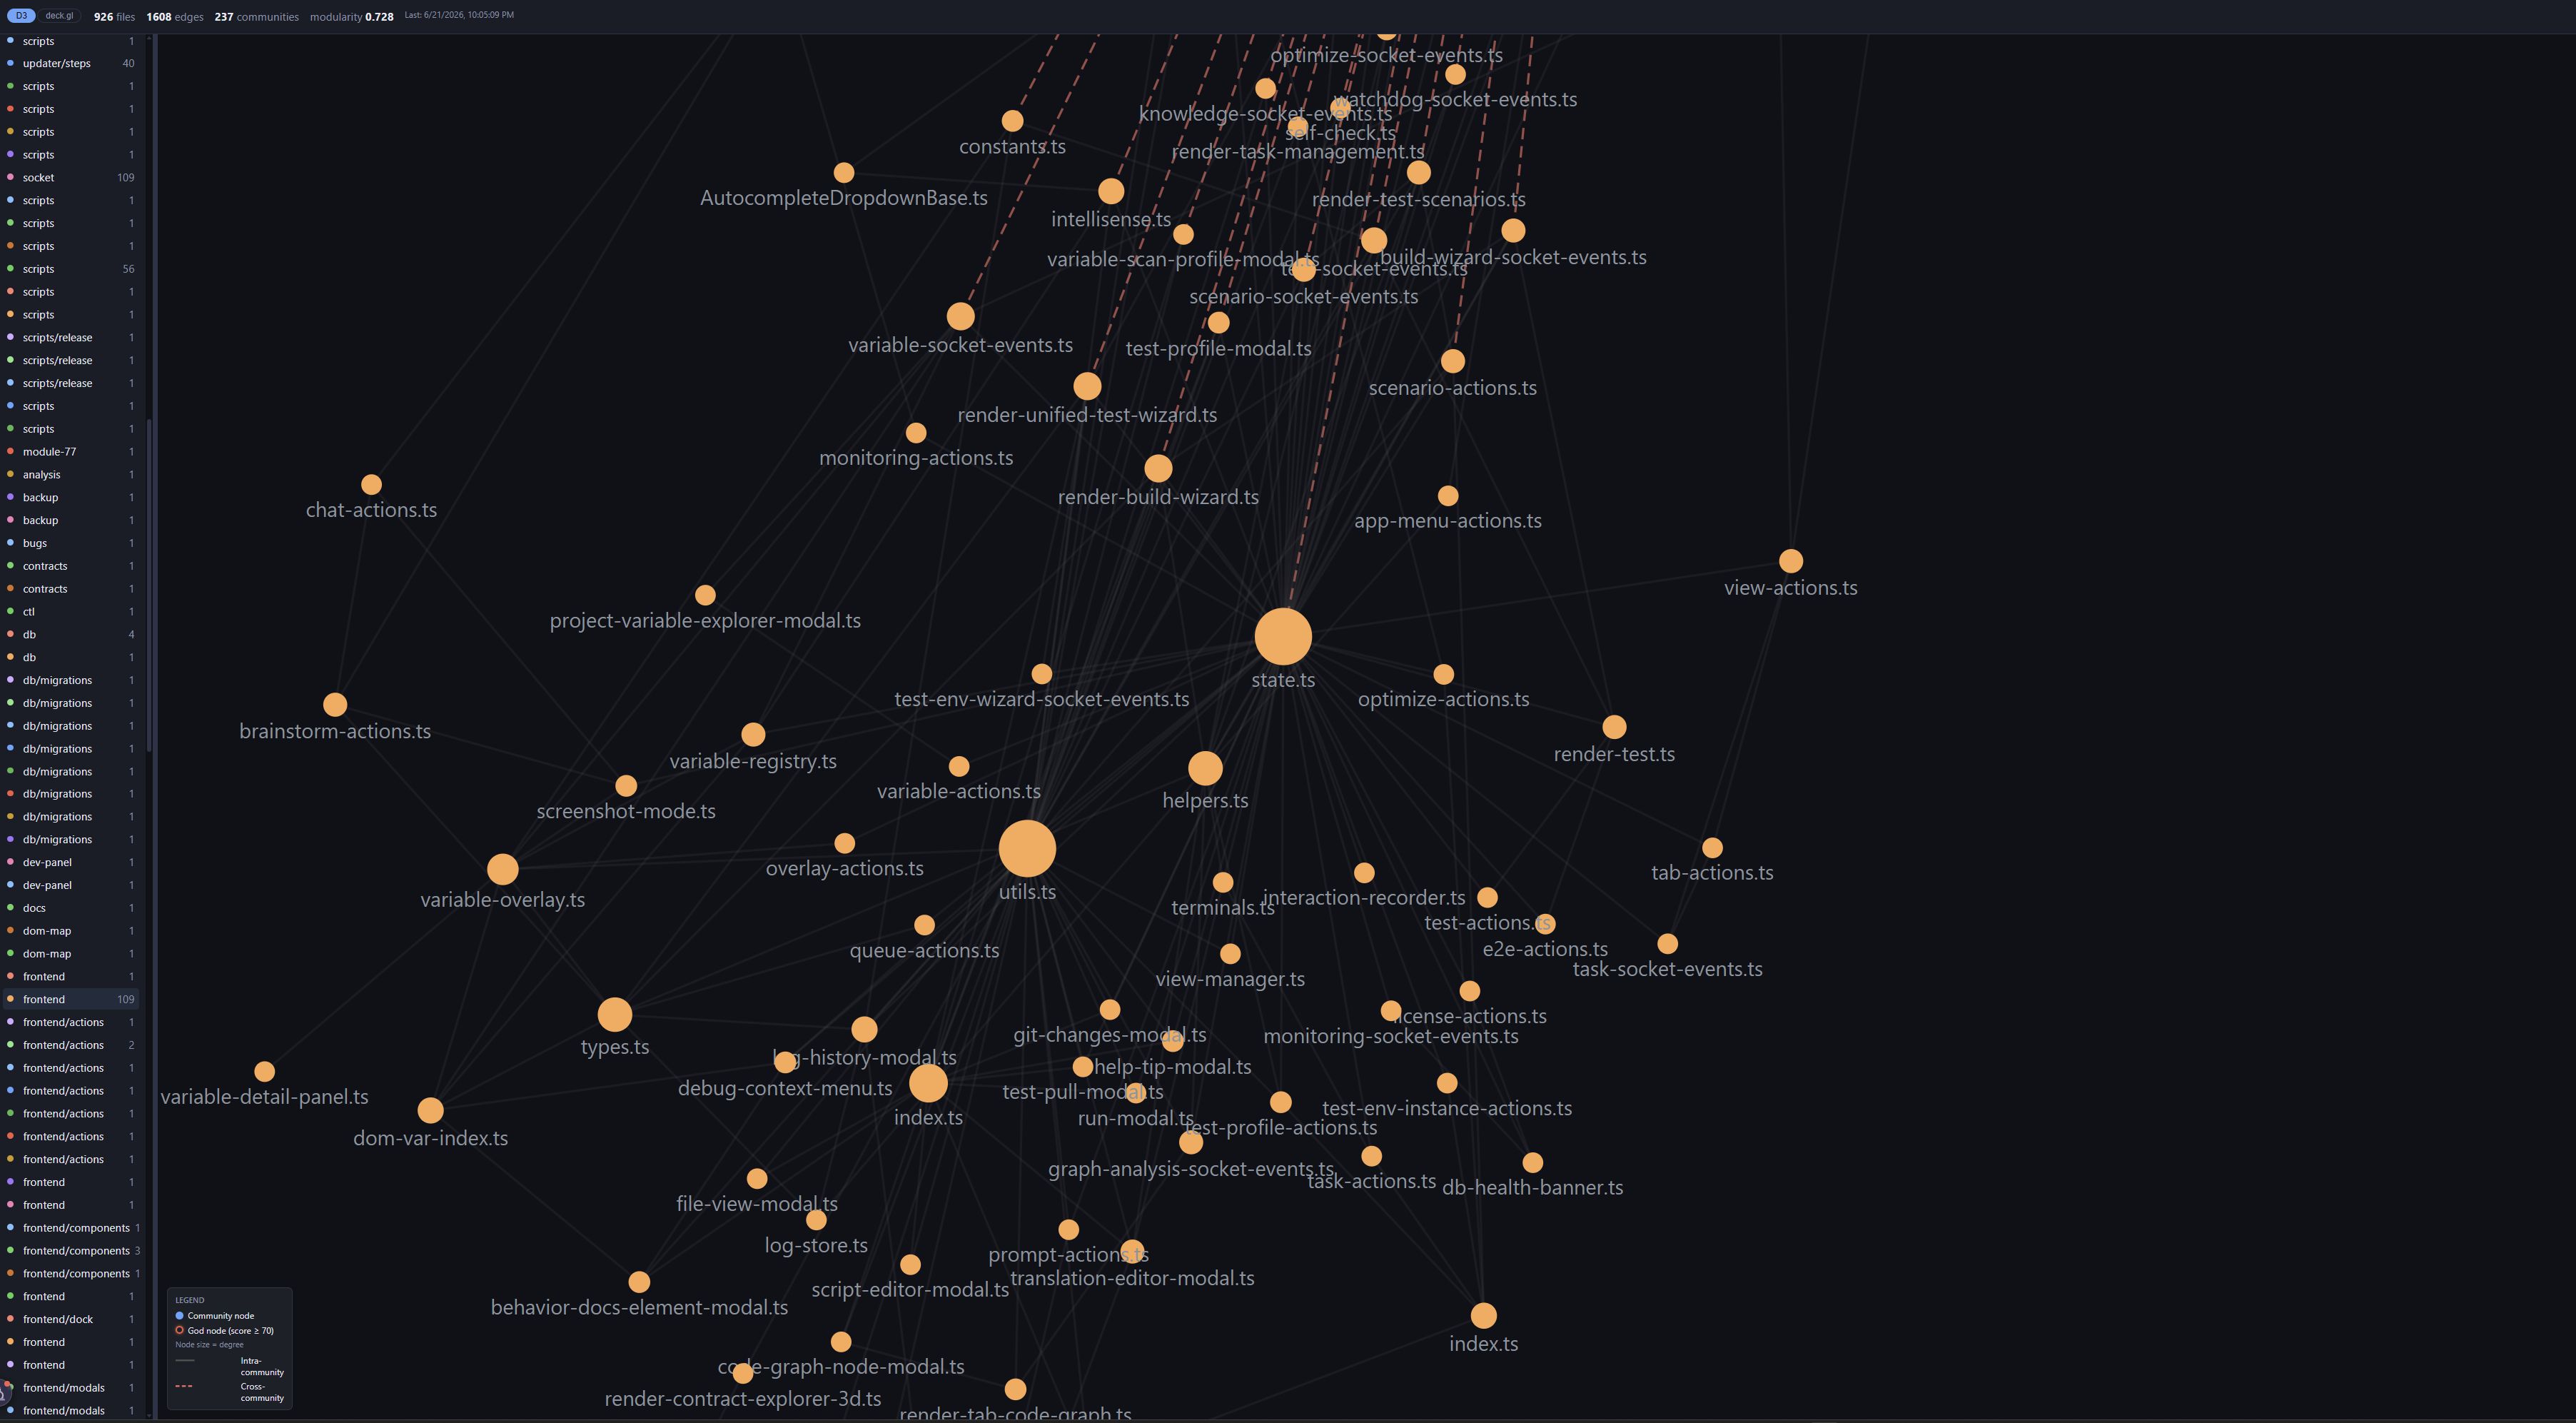
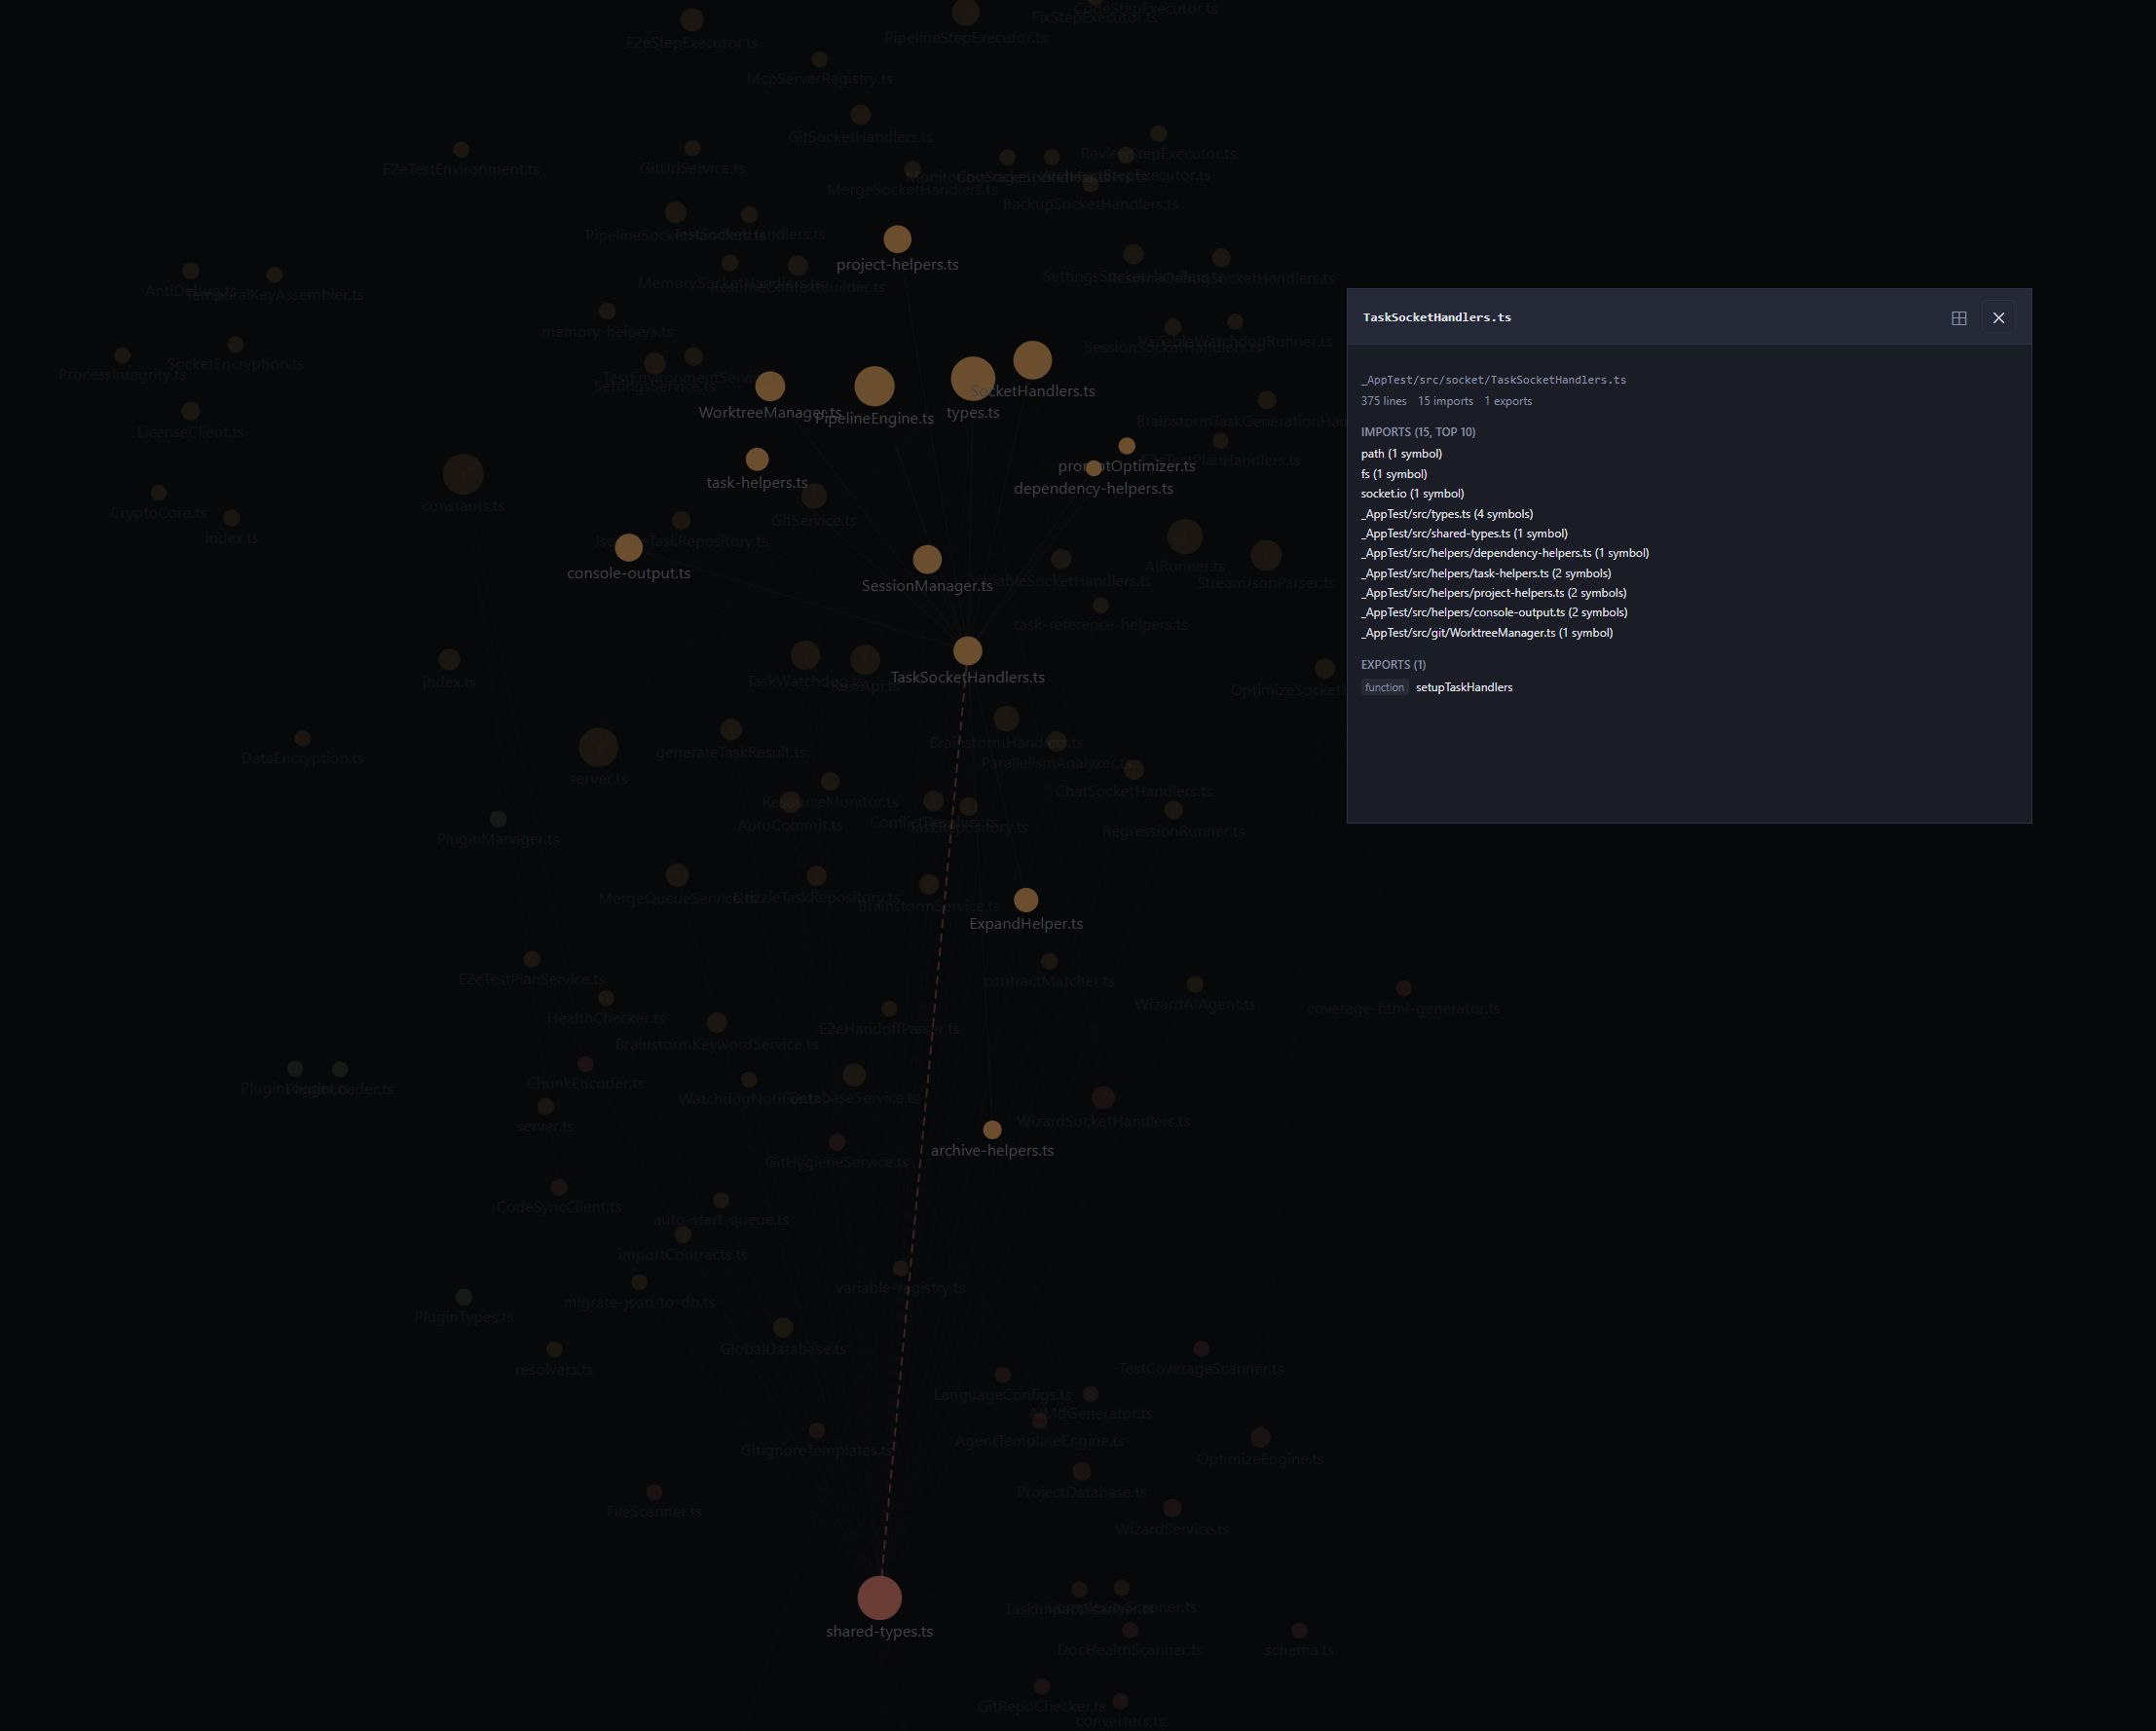
Este grafo puede explorarse directamente a través del Variable Explorer, que permite buscar variables, profundizar en su detalle y ver cualquier vista previa de captura de pantalla vinculada a un elemento de la interfaz.
Hints — normas de la casa reutilizables
Los Hints son reglas breves e independientes que una persona (o un Task anterior) ha enseñado a AITM y que se aplican automáticamente a partir de entonces — p. ej., convenciones de nomenclatura o formas de respuesta. Antes de que un Agent inicie un paso, AITM encuentra automáticamente los Hints relevantes para lo que está a punto de hacer y los incluye en su contexto, de modo que nunca hay que repetir la misma convención en cada Task creado.
Plantillas de Agent compartidas
El prompt de IA de cada paso del Pipeline se ensambla por capas: un preámbulo del proveedor, plantillas compartidas comunes a todos los pasos, las instrucciones propias del Agent del paso, una sustitución opcional por proyecto y, por último, las personalizaciones propias. Esa estratificación garantiza que cada paso del Pipeline, y cada proveedor de IA, reciba exactamente las mismas convenciones y reglas del proyecto — sin desviaciones entre lo que sabe el Architect y lo que sigue el Agent que programa.
Handoff entre pasos
Cada paso del Pipeline termina emitiendo un bloque de handoff estructurado y legible por máquina. Ese bloque se convierte en el contexto inicial del paso siguiente, tendiendo un puente entre dos sesiones de IA que de otro modo serían independientes — y como el formato de handoff es independiente del proveedor, funciona igual tanto si el siguiente paso se ejecuta en Claude, Gemini, DeepSeek u Ollama.
Grupos de sesión compartidos
Architect, Code, Review y Fix pueden ejecutarse dentro de una única conversación continua de IA en lugar de cuatro desconectadas. Eso significa que quien implementa aún recuerda las decisiones de diseño del paso de arquitectura, y quien revisa aún recuerda exactamente cómo razonó quien implementó el cambio.
Documentación autogenerada
Tras cada fusión, AITM regenera documentos de conocimiento por módulo, un compendio de conocimiento de todo el proyecto y un índice de búsqueda. La documentación, los doc-contracts y los doc-pointers se indexan en una base de datos SQLite por proyecto y se vinculan directamente con variables y Behavioral Contracts, de modo que las referencias entre Tasks mantienen trazable la evolución de una funcionalidad mucho después de archivado el Task original.
Brainstorm, Chat y Agents externos
Las conclusiones de una sesión de Brainstorm con @KEYWORD son reutilizables en cualquier prompt de Task futuro. El propio Chat se alimenta de un compendio de conocimiento en caché, de modo que puede responder preguntas del proyecto sin volver a leer todo el repositorio cada vez. Y como toda la base de conocimiento está tras un único endpoint GraphQL, los servidores MCP también pueden exponerla a Agents de IA externos.
Consejos
- Conviene usar
@KEYWORDen una sesión de Brainstorm para capturar una conclusión una sola vez y reutilizarla en todos los Tasks futuros que toquen la misma área. - Al evaluar un cambio entre varios proveedores, el formato de handoff compartido hace que cambiar de proveedor a mitad del Pipeline no pierda contexto.
- La documentación autogenerada hace que rara vez haga falta escribir a mano un README de un módulo que AITM ya mantiene.