Come è possibile che l'AI corregga con calma una funzione completamente diversa da quella che intendevi e sia sicurissima di aver fatto esattamente ciò che chiedevi? La risposta si chiama allucinazione!
Nei modelli linguistici significa che il modello genera una risposta che suona sicura e logica, ma che non corrisponde alla realtà o alla richiesta effettiva. Nel codice questo assume una forma specifica: l'AI tende a scegliere l'opzione più vicina per somiglianza di parole, anche quando quell'opzione non corrisponde al requisito reale.
Esempio: chiedi la correzione della funzione calculateDiscount(). Ma nel codice esistono anche calculateDiscountRate() e applyDiscount(). Il modello, soprattutto senza un contesto preciso, può "supporre" che tu intendessi la funzione dal nome simile e correggere il punto sbagliato. Il risultato sembra concluso, i test (se non ce ne sono) non dicono nulla, e il bug emerge tre passaggi dopo.
Che cosa riduce l'allucinazione:
Un riferimento esatto a file e riga, non solo il nome di una funzione ricordato a memoria.
Il contesto di business - a cosa serve la funzione, non solo cosa fa tecnicamente.
Un divieto esplicito di toccare punti con nomi simili ma diversi.
Passi più piccoli e verificabili - l'allucinazione in un passo piccolo viene scoperta subito; in un passo gigante si perde.
È esattamente qui che il classico approccio "scrivi un prompt e spera" raggiunge il suo limite. Serve un sistema che sappia dove si trovano le cose prima ancora che tu interpelli l'agente AI, ed è proprio ciò che risolvono i contratti, di cui parleremo a partire dalla prossima settimana.
Perché non si tratta solo di nomi di funzione simili
Lo stesso problema non si limita alla scelta della funzione sbagliata, riguarda anche la ricerca di informazioni nel codice stesso. Quando lo stesso tema (ad esempio "fattura") compare contemporaneamente in diverse classi, metodi, eventi ed elementi DOM, l'AI cerca nel codice solo finché non trova la prima corrispondenza che "ha senso" e lì si ferma. Se la logica reale da correggere si trova altrove (ad esempio in una classe TemplateInvoice separata, non nel calcolo generico della fattura), il modello non la apre mai. Non è che abbia cercato in pochi file, è che confronta solo con la corrispondenza più vicina alla richiesta e non prosegue.
Avere documentazione o skill preparate in anticipo aiuta: l'AI arriva alle informazioni giuste più in fretta e con più precisione. Il problema è che questa documentazione non si mantiene da sola: se nessuno la salva dopo un task, o se è la stessa AI a decidere che un'informazione "non è importante", resta non salvata. L'agente salva solo ciò che ritiene più importante dell'intera esecuzione, non tutto. Nei progetti più grandi anche la ricerca diventa più lenta: i singoli pezzi di logica di business si perdono gradualmente e, se esistono più documenti sullo stesso tema (ad esempio la fattura citata sia nel documento sulle fatture sia in quello sui template), l'AI spesso legge solo il primo che trova, decide che è una fonte sufficiente e non apre mai gli altri.
Questo ha una conseguenza pratica per i prompt: se in ogni richiesta bisogna scrivere "non dimenticare questo e quello, controlla anche là", non è più programmare, ma ricordare di continuo. È il segnale che l'informazione appartiene al sistema (una skill, un contratto), non alla testa della persona che deve digitarla ogni volta in un prompt.
Esperimento: stesso prompt, stesso modello, risultato diverso
Per verificare l'ipotesi ho condotto un semplice esperimento. Nel prompt ho scritto: "apri e leggi il file di istruzioni e seguilo." Il file diceva: quando lavori con un numero reale, mostralo sul frontend come numero decimale nel formato #.00 e salvalo nel log con la stessa formattazione.
Ho poi assegnato il compito di creare un form con due campi: età (intero) e altezza (numero reale), più i soliti requisiti (colore, posizione, un pulsante Salva, salvataggio nel database). Ho eseguito lo stesso prompt dieci volte, ogni volta in una sessione pulita, senza memoria condivisa tra le esecuzioni, con lo stesso modello.
Risultato: in 2 esecuzioni su 10 il modello ha ignorato l'istruzione sulla formattazione dei numeri contenuta nel file di riferimento. Stesso prompt, stesse condizioni, stesso modello e comunque il 20% di allucinazione. Alla domanda sul perché, la risposta era sempre la stessa: in quel momento il modello aveva ritenuto più importanti altre parti della richiesta e si era "dimenticato" dell'istruzione di formattazione.
Come ridurre davvero l'allucinazione
Lasciare che l'AI controlli semplicemente il proprio lavoro non basta. Il controllo stesso è soggetto ad allucinazione quanto il compito originale. In pratica funziona meglio dividere il lavoro in due passi:
1. Un task piccolo e definito in modo esplicito. È meglio inserire il contenuto della regola direttamente nel prompt, anziché limitarsi a rimandare a un file che l'AI "potrebbe o non potrebbe" leggere per intero.
PromptTask:
un form
campi di input formattati correttamente in base al tipo - int con 0 decimali, real con 2 decimali (questo può stare anche in un file, ma va incluso direttamente nel prompt, non solo referenziato, in modo che l'AI non debba leggerlo da sola),
registrare nel log i valori real con 2 decimali
salvare nel database.
2. Un prompt di verifica separato (*CheckPromptTask*), eseguito solo dopo la conclusione del primo task, con la stessa struttura numerata della richiesta - chiediamo all'AI esattamente ciò che abbiamo definito in PromptTask:
CheckPromptTask:
come è stato implementato il form?
come sono formattati i campi di input int e real?
come vengono salvati nel log i valori real?
i dati del form vengono effettivamente salvati nel database?
Il punto chiave è che l'AI risponde a queste domande basandosi sulla modifica effettiva del codice (il diff, i file), non sulla propria memoria o su una supposizione: in questo passo ha praticamente zero margine per allucinare, perché risponde in base a ciò che c'è davvero nel file.
Poi basta confrontare punto per punto le risposte di CheckPromptTask con i requisiti di PromptTask (1↔1, 2↔2, 3↔3, 4↔4) - se la risposta corrisponde alla richiesta. Se qualcosa non corrisponde, si risale alla causa e la correzione è mirata, non un rifacimento da zero.
Con questo approccio l'allucinazione scende a percentuali basse, a una cifra: non uno zero netto, ma ben al di sotto del 20% del primo test. In combinazione con unit test, test di integrazione e test manuali, l'allucinazione su modifiche più grandi e complesse può essere portata vicino allo zero.
Confronto concreto: stessa richiesta, due esiti
Richiesta: "Correggi lo sconto, non viene calcolato correttamente."
Chat AI semplice: apre il file che sembra più vicino al nome - ad esempio calculateDiscountRate() invece di calculateDiscount(), perché nel prompt non era indicato quale funzione esatta intendessi. Corregge quella, il test (se esiste) per la funzione corretta continua a non mostrare nulla e il bug in produzione resta. Solo un cliente in produzione scopre che lo sconto è ancora sbagliato.
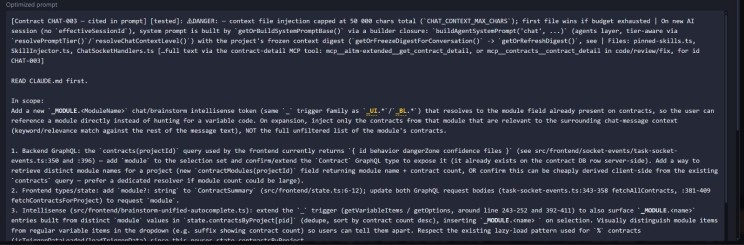
AITM: prima ancora che il task venga creato, agent-chat chiama contractsForVariable / searchDom e trova il contratto che descrive esattamente la logica dello sconto - con un campo concreto files: ["src/pricing/DiscountService.ts"] e behavior: "calculateDiscount() applica lo sconto in % dopo aver sottratto il coupon, non prima". Il prompt del task cita quindi esattamente %PRICING-004, non un generico "sconto", e lo step architect (Giorno 17) apre solo quel file. Il rischio che l'agente tocchi per errore calculateDiscountRate() sparisce di fatto. Non perché il modello sia diventato più intelligente, ma perché non deve indovinare nulla.
Perché è meglio di un prompt scritto bene da solo
L'approccio dell'esperimento qui sopra (task piccolo + verifica CheckPromptTask sul diff reale) funziona, ma solo se una persona lo prepara ogni singola volta e si ricorda di eseguirlo. AITM applica esattamente questo principio in modo sistematico e automatico, per ogni task:
I contratti sostituiscono "incolla la regola nel prompt". Invece di dover riscrivere in ogni richiesta la formattazione dei numeri, la posizione di una funzione o una regola di business, un contratto (ad esempio %PRICING-004) la memorizza una volta, con un riferimento esatto al file e una descrizione del comportamento. L'agente non indovina per somiglianza di parole, riceve la coordinata esatta prima ancora di iniziare a cercare.
Lo step docs scrive davvero la documentazione dopo ogni task - non "se l'AI decide che è importante". Scrivere/aggiornare un contratto è uno step obbligatorio della pipeline, non una memoria opzionale dell'agente.
La verifica sul diff reale è integrata, non è un passaggio manuale in più. Gli step di review e test nella pipeline chiedono cosa è cambiato davvero nei file, seguendo lo stesso principio di CheckPromptTask nell'esperimento.
Il risultato del mio test senza contratti è stato il 20% di allucinazione su dieci esecuzioni della stessa richiesta. Con la struttura task piccolo + contratto + verifica sul diff (esattamente ciò che la pipeline fa in automatico), l'allucinazione sul singolo step scende a percentuali a una cifra - non perché il modello sia diverso, ma perché non deve indovinare nulla e nessuno deve ricordarsi di digitare tutto nel prompt ogni singola volta.
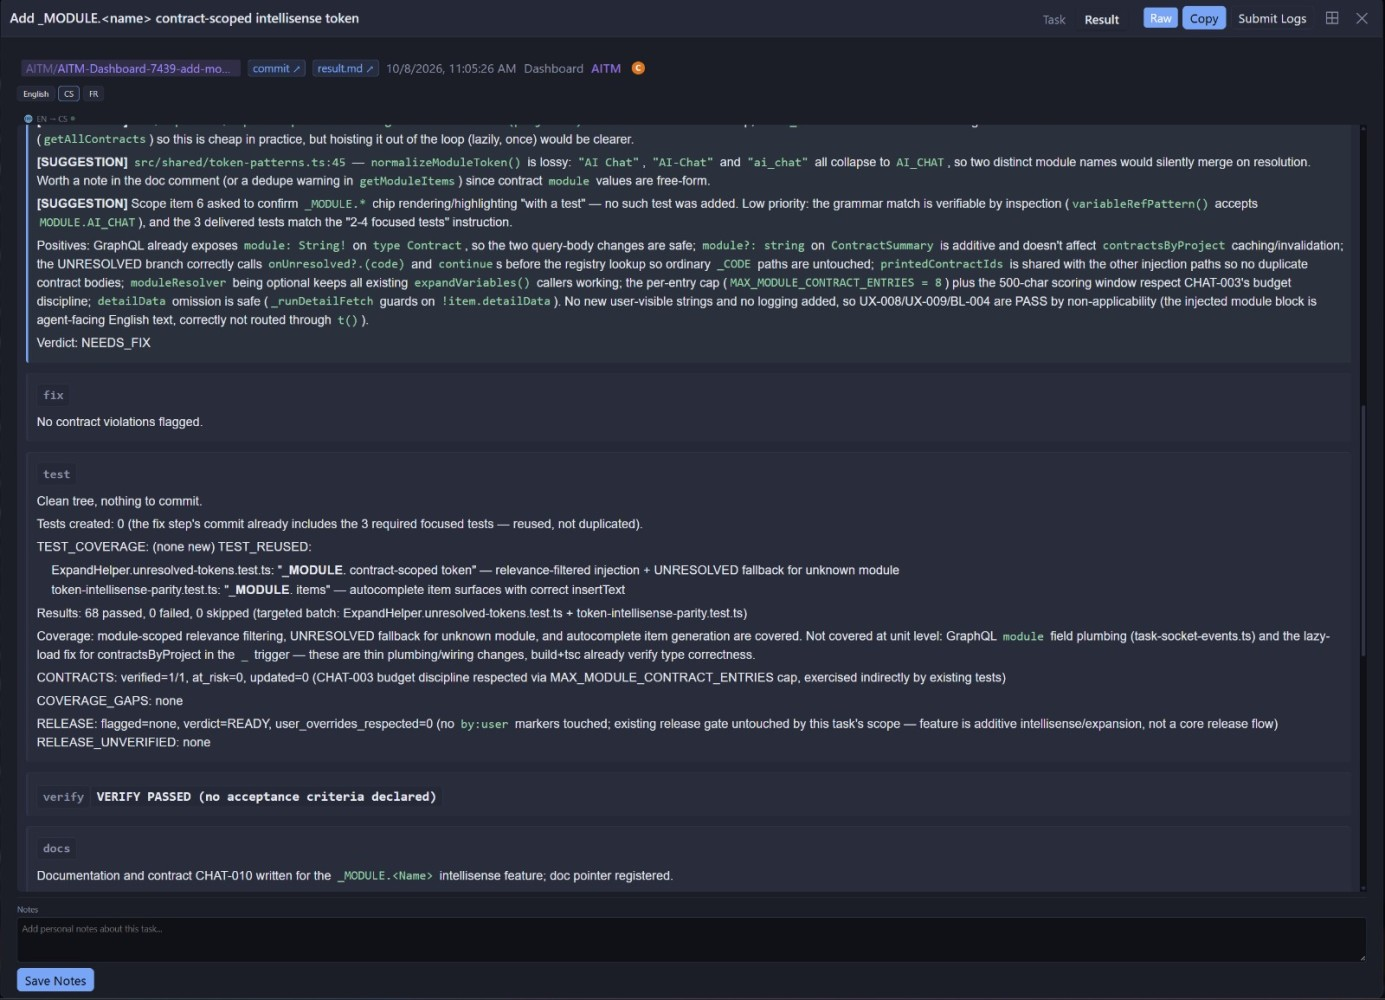
AITM ottimizza il prompt, e il prompt ottimizzato produce il risultato del task. Poi verifichiamo quel risultato rispetto a ciò che il task richiedeva e a ciò che l'AI ha effettivamente fatto.