Как так получается, что ИИ спокойно исправляет совсем не ту функцию, которую вы имели в виду, и при этом полностью уверен, что сделал именно то, о чём вы просили? Ответ называется галлюцинацией!
Для языковых моделей это означает, что модель генерирует ответ, который звучит уверенно и логично, но не соответствует реальности или реальному запросу. В коде это принимает конкретную форму: ИИ склонен выбирать ближайший по сходству слов вариант, даже если он не соответствует настоящему требованию.
Пример: вы просите исправить функцию calculateDiscount(). Но в коде есть ещё calculateDiscountRate() и applyDiscount(). Модель, особенно без точного контекста, может «предположить», что вы имели в виду функцию с похожим названием, и исправить не то место. Результат выглядит завершённым, тесты (если их нет) молчат, а ошибка всплывает тремя шагами позже.
Что снижает галлюцинации:
Точная ссылка на файл и строку, а не просто название функции, которое вспомнилось по памяти.
Бизнес-контекст - для чего нужна функция, а не только что она делает технически.
Явный запрет трогать похожие по названию, но другие места.
Более мелкие, проверяемые шаги - галлюцинация в маленьком шаге быстро обнаруживается, а в гигантском теряется.
Именно здесь стандартный подход «написать prompt и надеяться» упирается в потолок. Нужна система, которая знает, где что находится, ещё до того, как вы обратитесь к ИИ-агенту, и именно это решают контракты, о которых мы будем говорить начиная со следующей недели.
Почему дело не только в похожих названиях функций
Та же проблема не ограничивается выбором не той функции, она касается и поиска информации в самом коде. Когда одна и та же тема (скажем, «счёт-фактура», invoice) встречается сразу в нескольких классах, методах, событиях и DOM-элементах, ИИ ищет по коду лишь до первого совпадения, которое «имеет смысл», и на этом останавливается. Если настоящая логика, которую нужно исправить, находится в другом месте (скажем, в отдельном классе TemplateInvoice, а не в общем расчёте счёта), модель её так и не откроет. Дело не в том, что она просмотрела слишком мало файлов, а в том, что она сверяется только с ближайшим совпадением с запросом и не идёт дальше.
Заранее подготовленная документация или навыки (skills) помогают: ИИ тогда быстрее и точнее добирается до нужной информации. Проблема в том, что такая документация сама себя не поддерживает: если после задачи её никто не сохранит или если ИИ сам решит, что часть информации «неважна», она останется несохранённой. Агент сохраняет только то, что считает самым важным из всего прогона, а не всё подряд. В крупных проектах поиск к тому же замедляется: отдельные фрагменты бизнес-логики постепенно теряются, а если по одной теме есть несколько документов (скажем, счёт-фактура упоминается и в документе о счетах, и в документе о шаблонах), ИИ часто читает только первый найденный, решает, что этого источника достаточно, и остальные не открывает.
У этого есть практическое следствие для prompt: если в каждом запросе приходится писать «не забудь то и это, проверь ещё и там», это перестаёт быть программированием и превращается в постоянные напоминания. Это сигнал, что информация должна находиться в системе (в навыке, в контракте), а не в голове человека, которому приходится вписывать её в prompt каждый раз.
Эксперимент: один и тот же prompt, одна и та же модель, разный результат
Чтобы проверить гипотезу, я провёл простой эксперимент. В prompt я написал: «открой и прочитай файл с инструкциями и следуй ему». В файле было сказано: при работе с вещественным числом отображай его на фронтенде как десятичное число в формате #.00 и сохраняй в лог с тем же форматированием.
Затем я поставил задачу построить форму с двумя полями: возраст (целое число) и рост (вещественное число), плюс обычные требования (цвет, расположение, кнопка «Сохранить», сохранение в базу данных). Я запустил один и тот же prompt десять раз, каждый раз в чистой сессии, без памяти между запусками, на одной и той же модели.
Результат: в 2 запусках из 10 модель проигнорировала инструкцию о форматировании чисел из файла, на который была ссылка. Тот же prompt, те же условия, та же модель, и всё равно 20% галлюцинаций. На вопрос о причине ответ был всегда одинаковым: в тот момент модель сочла другие части запроса более важными и «забыла» про инструкцию по форматированию.
Как на самом деле снизить галлюцинации
Просто позволить ИИ проверить собственную работу недостаточно. Сама проверка так же подвержена галлюцинациям, как и исходная задача. На практике лучше работает разделение работы на два шага:
1. Небольшая, чётко определённая задача. Содержание правила лучше поместить прямо в prompt, а не просто ссылаться на файл, который ИИ «может прочитать целиком, а может и нет».
PromptTask:
форма
поля ввода с правильным форматированием по типу - int с 0 знаков после запятой, real с 2 знаками после запятой (это тоже может храниться в файле, но должно быть включено прямо в prompt, а не просто упомянуто, чтобы ИИ не пришлось читать его самостоятельно),
логировать real-значения с 2 знаками после запятой
сохранение в базу данных.
2. Отдельный проверочный prompt (*CheckPromptTask*), запускаемый только после завершения первой задачи, с той же нумерованной структурой, что и запрос - мы спрашиваем ИИ ровно о том, что определили в PromptTask:
CheckPromptTask:
как была реализована форма?
как отформатированы поля ввода int и real?
как real-значения сохраняются в лог?
действительно ли данные формы сохраняются в базу данных?
Ключевой момент в том, что ИИ отвечает на эти вопросы на основе фактического изменения в коде (diff, файлы), а не по собственной памяти или догадке - на этом шаге у него практически нет места для галлюцинаций, потому что он отвечает на основе того, что реально находится в файле.
Дальше остаётся лишь сравнить ответы CheckPromptTask пункт за пунктом с требованиями PromptTask (1↔1, 2↔2, 3↔3, 4↔4) - соответствует ли ответ запросу. Если что-то не совпадает, выясняется причина, и исправление делается точечно - а не переделкой с нуля.
При таком подходе галлюцинации падают до низких однозначных процентов - не до чистого нуля, но намного ниже 20% из первого теста. В сочетании с модульными тестами, интеграционными тестами и ручным тестированием галлюцинации в более крупных и сложных изменениях можно довести почти до нуля.
Конкретное сравнение: один запрос, два исхода
Запрос: «Исправь скидку, она считается неправильно».
Обычный ИИ-чат: открывает файл, который выглядит ближе всего по названию - скажем, calculateDiscountRate() вместо calculateDiscount(), потому что в prompt не было сказано, какую именно функцию вы имели в виду. Он исправляет её, тест (если он есть) для нужной функции по-прежнему ничего не показывает, а ошибка в продакшене остаётся. Лишь клиент в продакшене обнаруживает, что скидка всё ещё неверна.
AITM: ещё до создания Task agent-chat вызывает contractsForVariable / searchDom и находит контракт, который описывает именно логику скидки - с конкретным полем files: [«src/pricing/DiscountService.ts»] и behavior: «calculateDiscount() применяет скидку в % после вычитания купона, а не до него». Затем prompt Task цитирует именно %PRICING-004, а не абстрактную «скидку», и шаг architect (День 17) открывает только этот единственный файл. Риск того, что агент по ошибке тронет calculateDiscountRate(), фактически исчезает. Не потому, что модель стала умнее, а потому, что ей не нужно ничего угадывать.
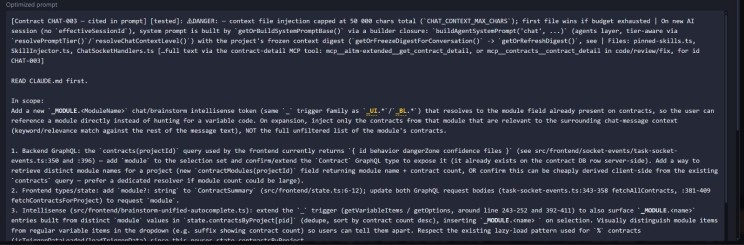
Почему это лучше одного хорошо написанного prompt
Подход из эксперимента выше (небольшая задача + проверка CheckPromptTask по реальному diff) работает, но только если человек каждый раз готовит его сам и не забывает запустить. AITM применяет именно этот принцип систематически и автоматически, для каждой Task:
Контракты заменяют «вставь правило в prompt». Вместо того чтобы пользователь заново вписывал в каждый запрос форматирование чисел, расположение функции или бизнес-правило, контракт (например, %PRICING-004) хранит это один раз, с точной ссылкой на файл и описанием поведения. Агент не гадает по сходству слов, а получает точную координату ещё до начала поиска.
Шаг docs действительно пишет документацию после каждой Task - а не «если ИИ решит, что это важно». Запись/обновление контракта - обязательный шаг pipeline, а не необязательная память агента.
Проверка по реальному diff встроена, а не является ручным дополнительным шагом. Шаги review и test в pipeline спрашивают, что на самом деле изменилось в файлах, по тому же принципу, что и CheckPromptTask в эксперименте.
Результат моего собственного теста без контрактов - 20% галлюцинаций на десяти запусках одного и того же запроса. При структуре «небольшая задача + контракт + проверка по diff» (ровно то, что pipeline делает автоматически) галлюцинации на отдельном шаге падают до однозначных процентов - не потому, что модель другая, а потому, что ей не нужно ничего угадывать, и никому не нужно помнить всё, чтобы каждый раз вписывать это в prompt.
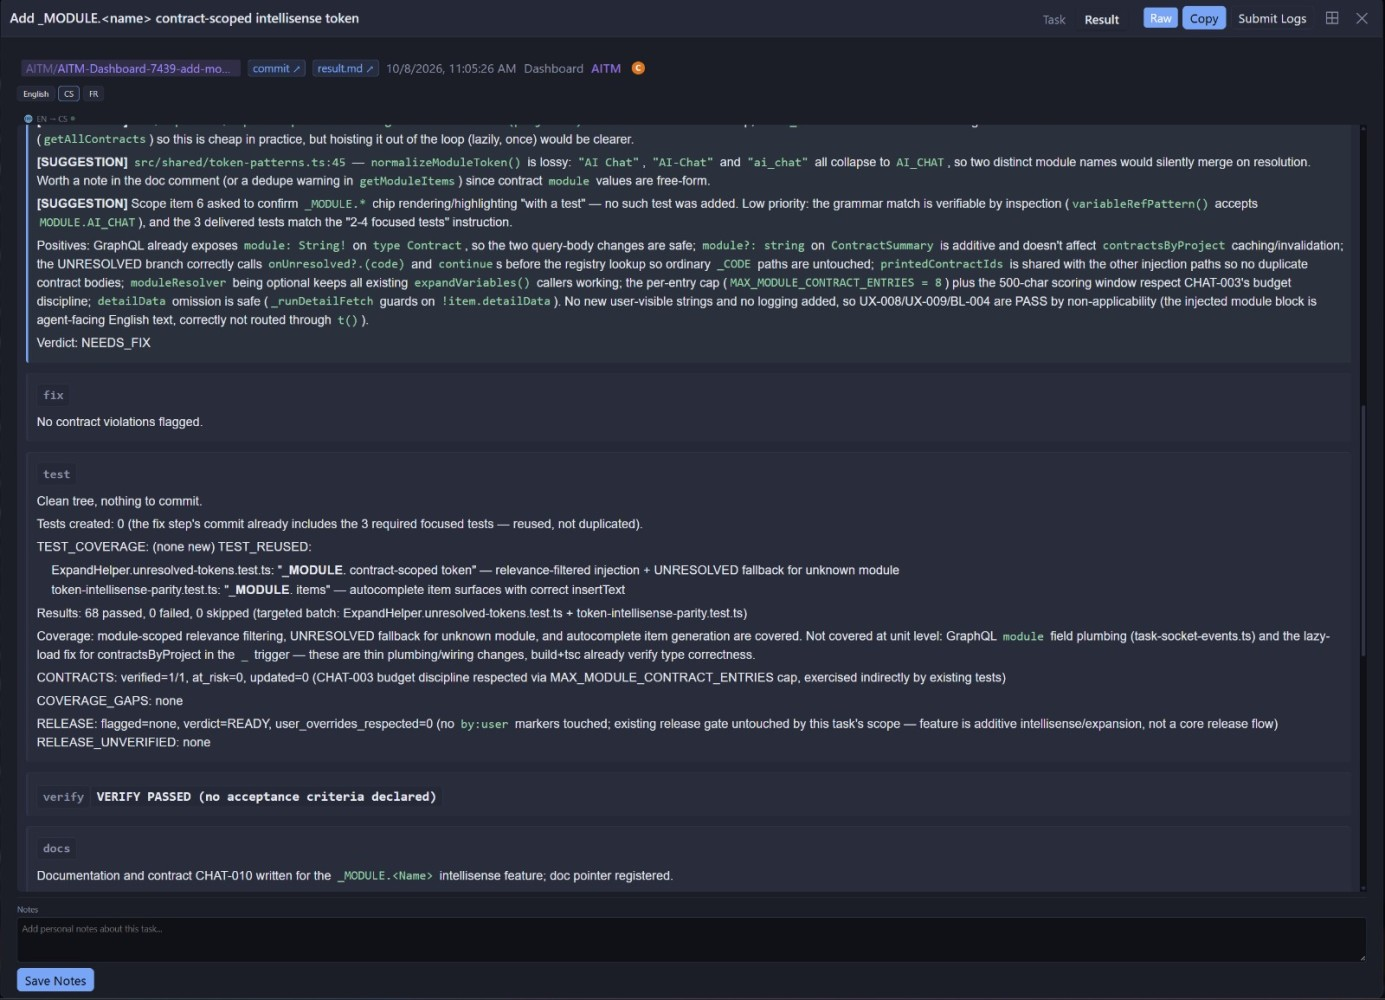
AITM оптимизирует prompt, и оптимизированный prompt даёт результат Task. Затем мы сверяем этот результат с тем, что требовалось в Task и что ИИ сделал на самом деле.