Jak to możliwe, że AI spokojnie poprawia zupełnie inną funkcję niż ta, którą miałeś na myśli, i jest w pełni przekonana, że zrobiła dokładnie to, o co prosiłeś? Odpowiedź brzmi: halucynacja!
W przypadku modeli językowych oznacza to, że model generuje odpowiedź, która brzmi pewnie i logicznie, ale nie zgadza się z rzeczywistością ani z faktycznym żądaniem. W kodzie przybiera to konkretną postać: AI ma tendencję do wybierania najbliższej opcji na podstawie podobieństwa słów, nawet jeśli ta opcja nie odpowiada rzeczywistemu wymaganiu.
Przykład: prosisz o poprawkę funkcji calculateDiscount(). Ale w kodzie są też calculateDiscountRate() i applyDiscount(). Model, zwłaszcza bez precyzyjnego kontekstu, może „założyć", że chodziło ci o funkcję o podobnej nazwie, i poprawić nie to miejsce. Wynik wygląda na skończony, testy (jeśli ich nie ma) nic nie mówią, a błąd wychodzi na jaw trzy kroki później.
Co zmniejsza halucynacje:
Dokładne wskazanie pliku i linii, a nie tylko nazwa funkcji przywołana z pamięci.
Kontekst biznesowy - do czego funkcja służy, a nie tylko co robi technicznie.
Wyraźny zakaz ruszania podobnie nazwanych, ale innych miejsc.
Mniejsze, weryfikowalne kroki - halucynacja w małym kroku zostaje szybko wychwycona, w gigantycznym kroku ginie.
Właśnie tu standardowe podejście „napisz prompt i miej nadzieję" trafia na sufit. Potrzebny jest system, który wie, co gdzie jest, zanim jeszcze zapytasz agenta AI, a to właśnie rozwiązują kontrakty, którymi zajmiemy się od przyszłego tygodnia.
Dlaczego to nie dotyczy tylko podobnych nazw funkcji
Ten sam problem nie ogranicza się do wyboru złej funkcji, dotyczy też wyszukiwania informacji w samym kodzie. Gdy ten sam temat (powiedzmy „faktura") pojawia się jednocześnie w kilku klasach, metodach, zdarzeniach i elementach DOM, AI przeszukuje kod tylko do momentu, aż trafi na pierwsze dopasowanie, które „ma sens", i na tym się zatrzymuje. Jeśli prawdziwa logika, którą trzeba poprawić, znajduje się gdzie indziej (powiedzmy w osobnej klasie TemplateInvoice, a nie w ogólnym obliczaniu faktury), model nigdy jej nie otworzy. Nie chodzi o to, że przeszukał za mało plików, tylko o to, że porównuje wyłącznie z najbliższym dopasowaniem do żądania i nie szuka dalej.
Pomaga wcześniejsze przygotowanie dokumentacji lub skilli, bo AI szybciej i trafniej dociera do właściwych informacji. Problem w tym, że taka dokumentacja sama się nie utrzymuje: jeśli nikt jej nie zapisze po zadaniu albo AI samo uzna, że jakaś informacja „nie jest ważna", pozostaje niezapisana. Agent zapisuje tylko to, co uzna za najważniejsze z całego przebiegu, nie wszystko. W większych projektach wyszukiwanie też staje się wolniejsze: poszczególne fragmenty logiki biznesowej stopniowo się gubią, a jeśli o tym samym temacie istnieje kilka dokumentów (powiedzmy faktura wspomniana zarówno w dokumencie o fakturach, jak i w dokumencie o szablonach), AI często czyta tylko pierwszy znaleziony, uznaje go za wystarczające źródło i nigdy nie otwiera pozostałych.
Ma to praktyczną konsekwencję dla promptów: jeśli w każdym żądaniu trzeba pisać „nie zapomnij o tym i o tamtym, sprawdź też tam", przestaje to być programowanie, a staje się ciągłym przypominaniem. To sygnał, że informacja należy do systemu (skill, kontrakt), a nie do głowy osoby, która musi ją wpisywać do promptu za każdym razem.
Eksperyment: ten sam prompt, ten sam model, inny wynik
Aby sprawdzić tę hipotezę, przeprowadziłem prosty eksperyment. W prompcie napisałem: „otwórz i przeczytaj plik z instrukcjami i postępuj zgodnie z nim". Plik mówił: pracując z liczbą rzeczywistą, wyświetlaj ją na froncie jako liczbę dziesiętną w formacie #.00 i zapisuj w logu z tym samym formatowaniem.
Następnie zleciłem zbudowanie formularza z dwoma polami: wiek (liczba całkowita) i wzrost (liczba rzeczywista), plus zwykłe wymagania (kolor, pozycja, przycisk Zapisz, zapis do bazy danych). Ten sam prompt uruchomiłem dziesięć razy, za każdym razem w czystej sesji, bez pamięci przenoszonej między uruchomieniami, na tym samym modelu.
Wynik: w 2 z 10 uruchomień model zignorował instrukcję formatowania liczb z przywołanego pliku. Ten sam prompt, te same warunki, ten sam model, a mimo to 20% halucynacji. Zapytany o przyczynę, zawsze odpowiadał tak samo: w tym momencie uznał inne części żądania za ważniejsze i „zapomniał" o instrukcji formatowania.
Jak naprawdę ograniczyć halucynacje
Samo pozwolenie AI, żeby sprawdziło własną pracę, nie wystarcza. Sama kontrola jest tak samo podatna na halucynacje jak oryginalne zadanie. W praktyce lepiej działa podział pracy na dwa kroki:
1. Małe, wyraźnie zdefiniowane zadanie. Lepiej wpisać treść reguły bezpośrednio w prompt, niż tylko odwoływać się do pliku, który AI „może przeczyta w całości, a może nie".
PromptTask:
formularz
pola wejściowe poprawnie sformatowane według typu - int z 0 miejscami po przecinku, real z 2 miejscami po przecinku (może to być też w pliku, ale musi zostać dołączone bezpośrednio do promptu, a nie tylko wskazane, żeby AI nie musiało czytać go samodzielnie),
wartości real zapisywać w logu z 2 miejscami po przecinku
zapis do bazy danych.
2. Osobny prompt weryfikujący (*CheckPromptTask*), uruchamiany dopiero po zakończeniu pierwszego zadania, z taką samą ponumerowaną strukturą jak żądanie - pytamy AI dokładnie o to, co zdefiniowaliśmy w PromptTask:
CheckPromptTask:
jak zaimplementowano formularz?
jak sformatowane są pola wejściowe int i real?
jak wartości real są zapisywane w logu?
czy dane z formularza rzeczywiście są zapisywane w bazie danych?
Kluczowe jest to, że AI odpowiada na te pytania na podstawie faktycznej zmiany w kodzie (diff, pliki), a nie z własnej pamięci czy domysłów - na tym etapie praktycznie nie ma miejsca na halucynacje, bo odpowiada na podstawie tego, co naprawdę znajduje się w pliku.
Potem wystarczy porównać odpowiedzi CheckPromptTask punkt po punkcie z wymaganiami PromptTask (1↔1, 2↔2, 3↔3, 4↔4) - czy odpowiedź zgadza się z żądaniem. Jeśli coś się nie zgadza, ustala się przyczynę, a poprawka jest celowana - nie robi się wszystkiego od nowa.
Dzięki takiemu podejściu halucynacje spadają do niskich jednocyfrowych wartości procentowych - nie do czystego zera, ale daleko poniżej 20% z pierwszego testu. W połączeniu z testami jednostkowymi, integracyjnymi i testami manualnymi halucynacje przy większych i bardziej złożonych zmianach można zepchnąć blisko zera.
Konkretne porównanie: to samo żądanie, dwa wyniki
Żądanie: „Popraw rabat, źle się liczy."
Zwykły czat z AI: otwiera plik, który wygląda na najbliższy nazwie - powiedzmy calculateDiscountRate() zamiast calculateDiscount(), bo prompt nigdy nie wskazał, o którą dokładnie funkcję chodzi. Poprawia tę, test (jeśli istnieje) dla właściwej funkcji nadal nic nie pokazuje, a błąd produkcyjny zostaje. Dopiero klient na produkcji odkrywa, że rabat nadal jest zły.
AITM: jeszcze przed utworzeniem zadania agent-chat wywołuje contractsForVariable / searchDom i znajduje kontrakt opisujący dokładnie logikę rabatu - z konkretnym polem files: ["src/pricing/DiscountService.ts"] i behavior: „calculateDiscount() stosuje rabat procentowy po odjęciu kuponu, a nie przed nim". Prompt zadania cytuje wtedy dokładnie %PRICING-004, a nie ogólny „rabat", a krok architekta (Dzień 17) otwiera tylko ten jeden plik. Ryzyko, że agent przez pomyłkę dotknie calculateDiscountRate(), praktycznie znika. Nie dlatego, że model zmądrzał, ale dlatego, że nie musi niczego zgadywać.
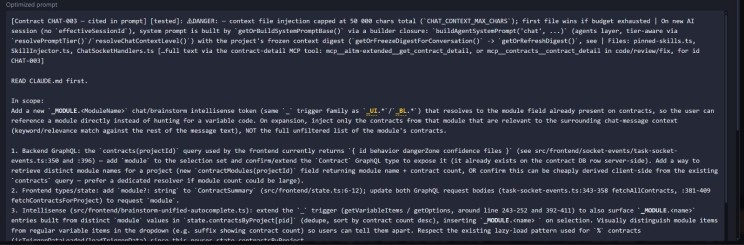
Dlaczego to bije samo dobrze napisane prompty
Podejście z powyższego eksperymentu (małe zadanie + weryfikacja CheckPromptTask względem prawdziwego diffu) działa - ale tylko wtedy, gdy człowiek za każdym razem sam je przygotuje i pamięta, żeby je uruchomić. AITM stosuje dokładnie tę zasadę systematycznie i automatycznie, dla każdego zadania:
Kontrakty zastępują „wklej regułę do promptu". Zamiast tego, by użytkownik za każdym razem przepisywał w żądaniu formatowanie liczb, lokalizację funkcji czy regułę biznesową, kontrakt (np. %PRICING-004) przechowuje to raz, z dokładnym odwołaniem do pliku i opisem zachowania. Agent nie zgaduje na podstawie podobieństwa słów, dostaje dokładną współrzędną, zanim w ogóle zacznie szukać.
Krok docs faktycznie zapisuje dokumentację po każdym zadaniu - a nie „jeśli AI uzna, że to ważne". Zapis/aktualizacja kontraktu jest obowiązkowym krokiem pipeline, a nie opcjonalną pamięcią agenta.
Weryfikacja względem prawdziwego diffu jest wbudowana, a nie jest ręcznym dodatkowym krokiem. Kroki review i test w pipeline pytają o to, co faktycznie zmieniło się w plikach, zgodnie z tą samą zasadą co CheckPromptTask w eksperymencie.
Wynik mojego własnego testu bez kontraktów to 20% halucynacji w dziesięciu uruchomieniach tego samego żądania. Przy strukturze małe zadanie + kontrakt + weryfikacja względem diffu (dokładnie to, co pipeline robi automatycznie) halucynacje w pojedynczym kroku spadają do jednocyfrowych wartości procentowych - nie dlatego, że model jest inny, ale dlatego, że nie musi niczego zgadywać, a nikt nie musi pamiętać o wszystkim, co trzeba wpisać w prompt za każdym razem.
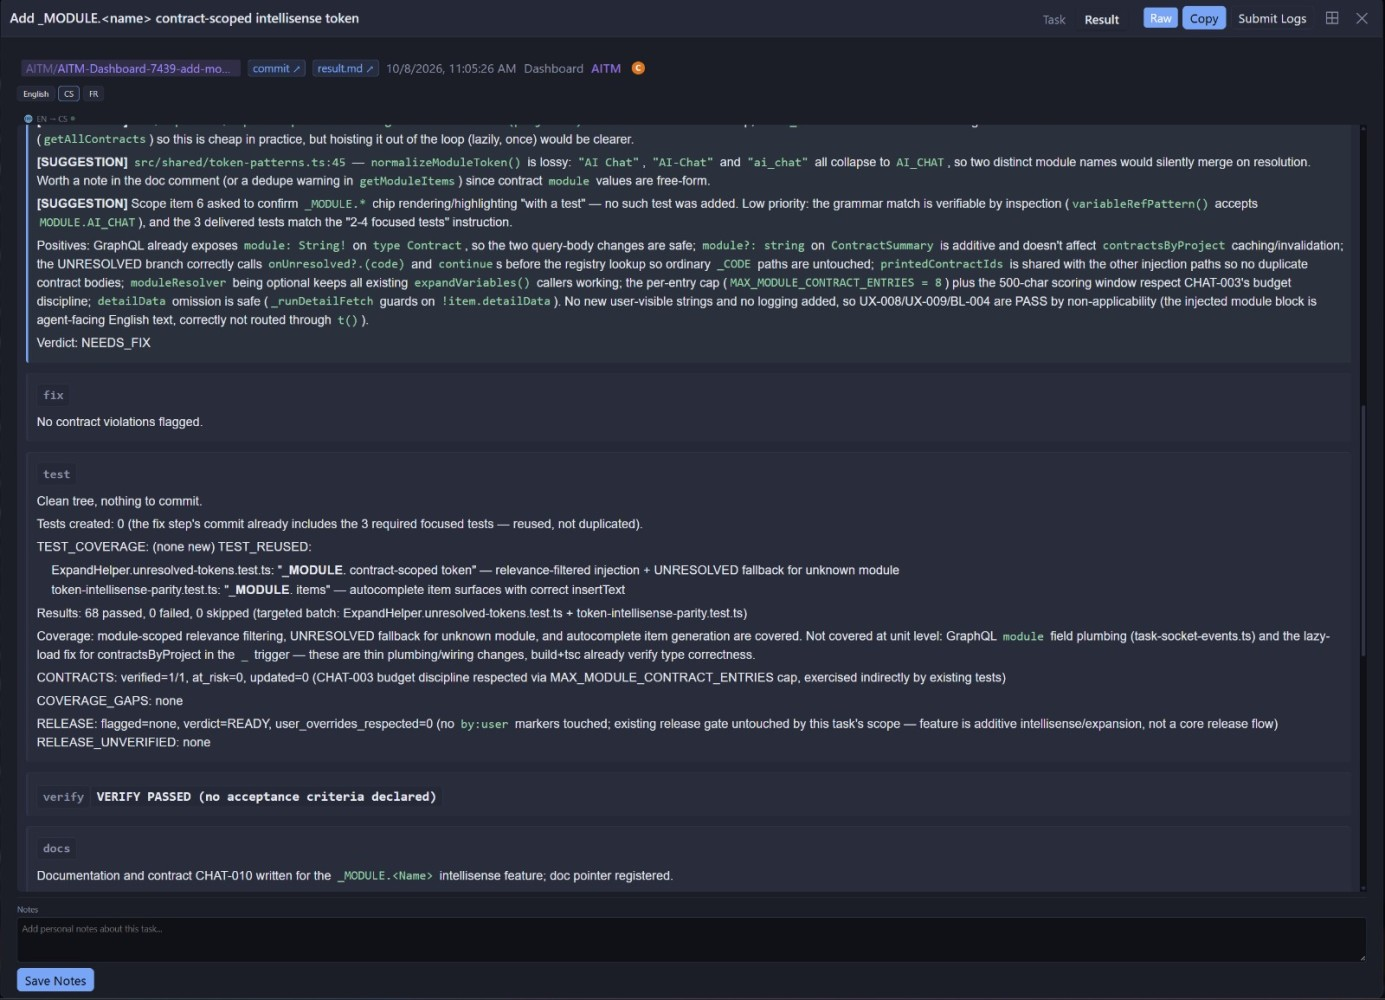
AITM optymalizuje prompt, a zoptymalizowany prompt daje wynik zadania. Następnie sprawdzamy ten wynik pod kątem tego, czego wymagało zadanie i co AI faktycznie zrobiło.