Jak je možné, že AI s klidem opraví úplně jinou funkci, než jste měli na mysli, a přitom si je naprosto jistá, že udělala přesně to, co jste chtěli? Odpověď se jmenuje halucinace!
U jazykových modelů to znamená, že model vytvoří odpověď, která zní sebevědomě a logicky, ale neodpovídá skutečnosti nebo samotnému zadání. V kódu má tento problém konkrétní podobu: AI má tendenci vybírat nejbližší možnost podle podobnosti slov, i když neodpovídá skutečnému požadavku.
Příklad: požádáte o opravu funkce calculateDiscount(). V kódu ale existují také calculateDiscountRate() a applyDiscount(). Model si může, zvlášť bez přesného kontextu, „domyslet“, že jste měli na mysli podobně pojmenovanou funkci, a opraví nesprávné místo. Výsledek vypadá hotově, testy (pokud žádné nejsou) nic neřeknou a chyba se projeví až o tři kroky později.
Co pomáhá omezit halucinace
- Přesný odkaz na soubor a řádek, nikoli jen název funkce vybavený z paměti.
- Kontext fungování aplikace — k čemu funkce slouží, nejen co dělá po technické stránce.
- Výslovný zákaz zasahovat do podobně pojmenovaných, ale odlišných míst.
- Menší, ověřitelné kroky — halucinaci v malém kroku odhalíte rychle; v jednom obřím kroku se ztratí.
Právě tady běžný přístup „napiš prompt a doufej“ naráží na své limity. Je potřeba systém, který ví, kde se co nachází, ještě než se AI agenta vůbec zeptáte. A přesně to řeší kontrakty, kterým se budeme věnovat od příštího týdne.
Proč nejde jen o podobné názvy funkcí
Stejný problém se netýká pouze výběru nesprávné funkce. Platí i pro hledání informací v samotném kódu. Když se stejné téma, například „faktura“, objevuje současně v několika třídách, metodách, událostech a prvcích DOM, AI prohledává kód jen do chvíle, než narazí na první shodu, která „dává smysl“. A tam se zastaví. Pokud logika, kterou skutečně potřebujete opravit, leží jinde — třeba v samostatné třídě TemplateInvoice, nikoli v obecném výpočtu faktury — model ji už neotevře. Nejde o to, že by prohledal příliš málo souborů. Jde o to, že zadání porovná jen s nejbližší shodou a dál nepokračuje.
Předem připravená dokumentace nebo skilly pomáhají: AI se díky nim dostane ke správným informacím rychleji a přesněji. Taková dokumentace se ale neudržuje sama. Pokud ji po dokončení úkolu nikdo neuloží nebo pokud sama AI vyhodnotí určitou informaci jako „nedůležitou“, zůstane neuložená. Agent si z celého průběhu práce uloží pouze to, co považuje za nejdůležitější, nikoli všechno. U větších projektů se navíc zpomaluje vyhledávání: jednotlivé části aplikační logiky se postupně ztrácejí. Pokud existuje více dokumentů ke stejnému tématu, například zmínka o fakturách v dokumentaci faktur i v dokumentaci šablon, AI často přečte jen první nalezený dokument, považuje jej za dostatečný zdroj a ostatní už neotevře.
Pro zadávání promptů z toho plyne praktický důsledek: pokud musíte do každého požadavku psát „nezapomeň na tohle a tamto, podívej se také tam“, přestává to být programování a mění se to v neustálé připomínání. Je to signál, že tato informace patří do systému — do skillu nebo kontraktu — a nemá zůstávat v hlavě člověka, který ji pokaždé znovu píše do promptu.
Experiment: stejný prompt, stejný model, jiný výsledek
Abych tuto hypotézu ověřil, provedl jsem jednoduchý experiment. Do promptu jsem napsal: „Otevři a přečti si soubor s instrukcemi a řiď se jím.“ V souboru stálo: při práci s reálným číslem jej na frontendu zobrazuj jako desetinné číslo ve formátu #.00 a ve stejném formátu jej ukládej i do logu.
Potom jsem zadal vytvoření formuláře se dvěma poli: věk (celé číslo) a výška (reálné číslo), spolu s běžnými požadavky na barvu, umístění, tlačítko Uložit a ukládání do databáze. Stejný prompt jsem spustil desetkrát, pokaždé v čisté relaci, bez přenosu paměti mezi běhy a na stejném modelu.
Výsledek: ve 2 z 10 běhů model ignoroval instrukci o formátování čísel z odkazovaného souboru. Stejný prompt, stejné podmínky, stejný model, a přesto 20 % halucinací. Když jsem se zeptal proč, odpověď byla pokaždé stejná: model v danou chvíli vyhodnotil jiné části zadání jako důležitější a na instrukci o formátování „zapomněl“.
Jak halucinace skutečně omezit
Nestačí nechat AI, aby si svou práci jednoduše zkontrolovala sama. Samotná kontrola je stejně náchylná k halucinacím jako původní úkol. V praxi funguje lépe rozdělit práci do dvou kroků:
1. Malý, výslovně vymezený úkol
Je lepší vložit obsah pravidla přímo do promptu než pouze odkázat na soubor, který si AI „možná přečte celý, možná ne“.
PromptTask:
- Vytvořit formulář.
- Správně formátovat vstupní pole podle typu:
ints 0 desetinnými místy,realse 2 desetinnými místy. Pravidlo může být uložené i v souboru, ale jeho obsah musí být zahrnut přímo v promptu. Nestačí pouhý odkaz, který nechá na AI, zda si jej sama přečte. - Reálné hodnoty zapisovat do logu se 2 desetinnými místy.
- Ukládat do databáze.
2. Samostatný ověřovací prompt
Ověřovací prompt (CheckPromptTask) se spustí až po dokončení prvního úkolu a má stejnou číslovanou strukturu jako zadání. AI se ptáme přesně na to, co jsme vymezili v PromptTask:
CheckPromptTask:
- Jak byl formulář implementován?
- Jak jsou formátována vstupní pole typu
intareal? - Jak se reálné hodnoty ukládají do logu?
- Ukládají se data z formuláře skutečně do databáze?
Klíčové je, aby AI na tyto otázky odpovídala na základě skutečných změn v kódu — diffu a souborů, nikoli podle vlastní paměti nebo odhadu. V tomto kroku má prakticky nulový prostor pro halucinace, protože vychází z toho, co v souboru opravdu je.
Pak už stačí porovnat odpovědi z CheckPromptTask bod po bodu s požadavky z PromptTask (1↔1, 2↔2, 3↔3, 4↔4) a ověřit, zda odpověď odpovídá zadání. Pokud se něco neshoduje, dohledá se příčina a provede se cílená oprava. Nezačíná se znovu od začátku.
Při tomto postupu klesá podíl halucinací na nízké jednotky procent. Není to čistá nula, ale je to výrazně méně než 20 % z prvního testu. V kombinaci s unit testy, integračními testy a ručním testováním lze u větších a složitějších změn halucinace stlačit téměř k nule.
Konkrétní srovnání: stejný požadavek, dva výsledky
Zadání: „Oprav slevu, nepočítá se správně.“
Běžný AI chat: otevře soubor, který mu podle názvu připadá nejbližší — například calculateDiscountRate() místo calculateDiscount(), protože prompt nikdy neupřesnil, kterou funkci máte na mysli. Opraví ji, test správné funkce (pokud existuje) stále nic neukáže a chyba v produkci zůstane. Až zákazník v produkci zjistí, že se sleva stále počítá špatně.
AITM: ještě před vytvořením úkolu zavolá agent-chat nástroje contractsForVariable / searchDom a najde kontrakt, který přesně popisuje logiku slevy. Obsahuje konkrétní pole:
files: ["src/pricing/DiscountService.ts"]
behavior: "calculateDiscount() aplikuje procentní slevu až po odečtení kupónu, nikoli před ním"
Prompt úkolu pak odkazuje přímo na %PRICING-004, nikoli na obecnou „slevu“, a krok Architect (den 17) otevře pouze tento soubor. Riziko, že agent omylem zasáhne do calculateDiscountRate(), tím prakticky mizí. Ne proto, že by byl model chytřejší, ale proto, že nemusí nic odhadovat.
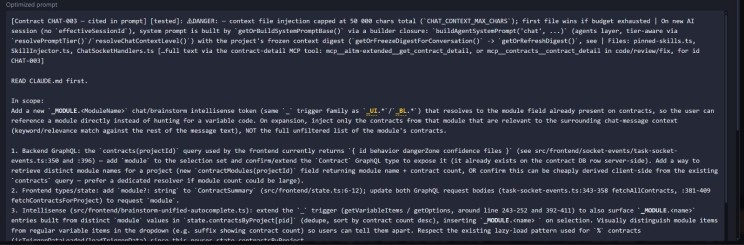
Proč to funguje lépe než samotný dobře napsaný prompt
Postup z předchozího experimentu — malý úkol a ověřovací CheckPromptTask nad skutečným diffem — funguje. Ovšem jen tehdy, když si jej člověk pokaždé sám připraví a nezapomene jej spustit. AITM uplatňuje stejný princip systematicky a automaticky u každého úkolu v rámci své pipeline:
- Kontrakty nahrazují „vlož pravidlo do promptu“. Uživatel nemusí do každého zadání znovu opisovat formátování čísel, umístění funkce nebo pravidlo fungování aplikace. Kontrakt, například
%PRICING-004, je uchovává na jednom místě spolu s přesným odkazem na soubor a popisem chování. Agent nehádá podle podobnosti slov: ještě před zahájením hledání dostane přesné místo. - Krok
Docspo každém úkolu dokumentaci skutečně zapisuje. Nejen tehdy, „když to AI uzná za důležité“. Zápis nebo aktualizace kontraktu je povinným krokem pipeline, nikoli volitelnou pamětí agenta. - Ověření proti skutečnému diffu je součástí procesu. Není to další ruční krok navíc. Kroky
ReviewaTestv pipeline zjišťují, co se v souborech skutečně změnilo, podle stejného principu jako CheckPromptTask v experimentu.
Výsledkem mého vlastního testu bez kontraktů bylo 20 % halucinací při deseti bězích stejného zadání. Se strukturou malý úkol + kontrakt + ověření proti diffu, tedy přesně s tím, co pipeline provádí automaticky, klesá podíl halucinací v jednotlivém kroku na jednotky procent. Ne proto, že by byl model jiný, ale proto, že nemusí nic odhadovat a nikdo si nemusí pokaždé pamatovat, co všechno má do promptu napsat.
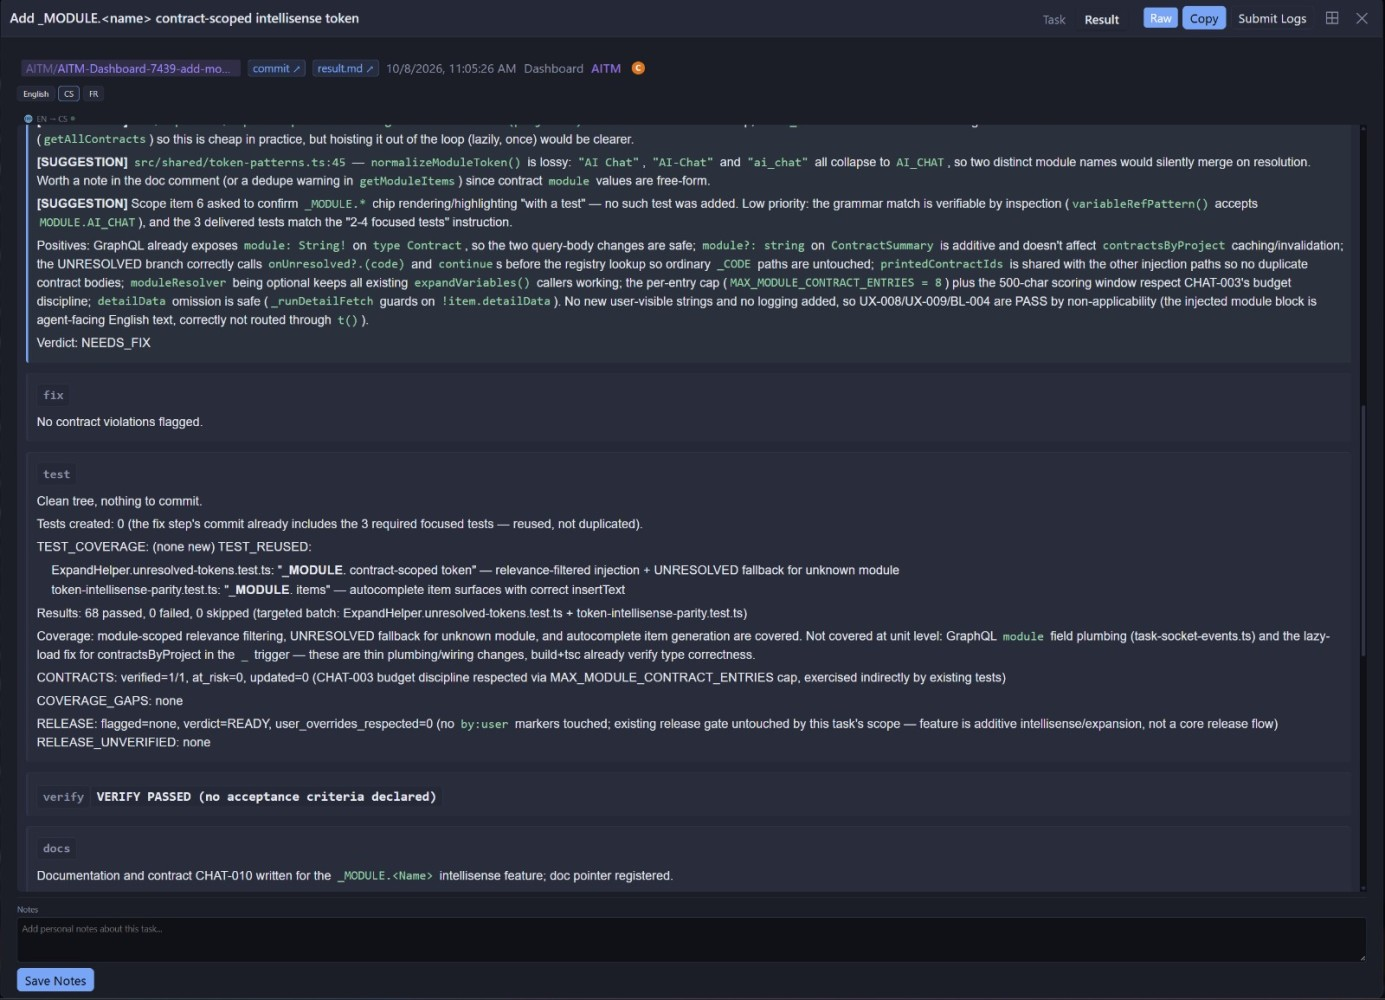
AITM optimalizuje prompt a optimalizovaný prompt vede k výsledku úkolu. Tento výsledek následně kontrolujeme podle toho, co zadání požadovalo a co AI skutečně udělala.