AIが、あなたが意図したのとはまったく別の関数を平然と修正し、しかも「依頼どおりにやりました」と自信満々に言い切る。そんなことがなぜ起こるのでしょうか。その答えが、ハルシネーション(幻覚)です。
言語モデルにおけるハルシネーションとは、自信ありげで論理的に聞こえるものの、現実や実際の依頼とは一致しない回答を生成してしまうことを指します。コードの世界では、これが特有の形で現れます。AIは、実際の要件に合っていなくても、単語の類似度が最も近い候補を選びがちです。
例を挙げましょう。calculateDiscount() 関数の修正を依頼したとします。ところがコードには calculateDiscountRate() や applyDiscount() も存在しています。特に正確なコンテキストがない場合、モデルは名前の似た関数を指していると「思い込み」、間違った場所を修正してしまうことがあります。結果は完成したように見えますし、(テストがなければ)テストも何も言いません。そしてバグは3工程後に表面化します。
ハルシネーションを減らす方法は次のとおりです。
正確なファイルと行の参照。記憶に頼った関数名だけでは不十分です。
ビジネスコンテキスト。関数が技術的に何をするかだけでなく、何のためにあるのか。
名前が似ているが別物の箇所には触れないという明示的な禁止。
小さく検証可能なステップ。小さなステップで起きたハルシネーションはすぐ見つかりますが、巨大なステップでは埋もれてしまいます。
まさにここが、「プロンプトを書いて祈る」という標準的なアプローチの限界です。必要なのは、AIエージェントに尋ねる前からどこに何があるかを把握している仕組みです。それこそがコントラクトの解決する課題であり、来週から詳しく取り上げます。
似た関数名だけの問題ではない理由
同じ問題は、間違った関数を選ぶことにとどまらず、コード内の情報探索そのものにも当てはまります。同じトピック(たとえば「請求書」)が複数のクラス、メソッド、イベント、DOM要素に同時に現れると、AIは「それらしい」最初の一致に行き当たるまでしかコードを探さず、そこで止まります。修正すべき本当のロジックが別の場所(たとえば汎用の請求書計算ではなく、別の TemplateInvoice クラス)にあっても、モデルはそれを開きません。探したファイルが少なすぎるのではなく、依頼に最も近い一致とだけ比較して、先へ進まないのです。
あらかじめドキュメントやスキルを用意しておくと、AIは適切な情報により速く、より正確にたどり着けます。ただし、そうしたドキュメントは自動では維持されません。タスクの後に誰も保存しなければ、あるいはAI自身が「重要ではない」と判断すれば、その情報は保存されないままです。エージェントが保存するのは、実行全体の中で最も重要と考えたものだけで、すべてではありません。大規模なプロジェクトでは検索も遅くなります。個々のビジネスロジックは徐々に埋もれていき、同じトピックに関する文書が複数ある場合(たとえば請求書が、請求書のドキュメントとテンプレートのドキュメントの両方に出てくる場合)、AIは最初に見つけたものだけを読み、それで十分な情報源だと判断して、他を開かないことがよくあります。
これはプロンプトに実務上の影響をもたらします。毎回の依頼で「あれもこれも忘れずに、あそこも確認して」と書かなければならないなら、それはプログラミングではなく、ひたすらリマインドを続ける作業になってしまいます。それは、その情報が、毎回プロンプトに打ち込む人の頭の中ではなく、システム(スキルやコントラクト)の中にあるべきだというサインです。
実験:同じプロンプト、同じモデル、異なる結果
この仮説を検証するため、簡単な実験を行いました。プロンプトには「指示ファイルを開いて読み、それに従ってください」と書きました。ファイルの内容は、実数を扱うときは、フロントエンドでは #.00 形式の小数として表示し、ログにも同じ書式で保存すること、というものです。
そのうえで、年齢(整数)と身長(実数)の2つのフィールドを持つフォームを作るタスクを与え、通常の要件(色、位置、保存ボタン、データベースへの保存)も加えました。同じプロンプトを、毎回クリーンなセッションで、実行間に記憶を引き継がず、同じモデルで10回実行しました。
結果:10回中2回、モデルは参照先ファイルにある数値フォーマットの指示を無視しました。同じプロンプト、同じ条件、同じモデルで、それでも20%のハルシネーションです。理由を尋ねると、答えは毎回同じでした。その時点でモデルは依頼の他の部分のほうが重要だと判断し、フォーマットの指示を「忘れた」のです。
ハルシネーションを実際に減らすには
AIに自分の作業を確認させるだけでは不十分です。確認という行為自体も、元のタスクと同じようにハルシネーションを起こしやすいからです。実際には、作業を2つのステップに分けるほうがうまくいきます。
1. 小さく、明確に定義されたタスク。 ルールの内容は、AIが全文を読むか「どうか分からない」ファイルを参照させるのではなく、プロンプトに直接書き込むほうが確実です。
PromptTask:
フォーム
型に応じて正しく書式設定された入力フィールド。int は小数点以下0桁、real は小数点以下2桁(これもファイルに置いてかまいませんが、AIが自力で読むことに任せず、参照するだけでなくプロンプトに直接含める必要があります)
real の値を小数点以下2桁でログに記録する
データベースに保存する
2. 独立した検証プロンプト(*CheckPromptTask*)。最初のタスクが終わってから初めて実行し、依頼と同じ番号付きの構造にします。PromptTask で定義したことを、そのままAIに尋ねるのです。
CheckPromptTask:
フォームはどのように実装されましたか?
int と real の入力フィールドはどのように書式設定されていますか?
real の値はログにどのように保存されていますか?
フォームのデータは実際にデータベースに保存されていますか?
重要なのは、AIがこれらの質問に、自身の記憶や推測ではなく、コードの実際の変更(diff、ファイル)に基づいて答える点です。このステップでは、実際にファイルにある内容に基づいて答えるため、ハルシネーションを起こす余地はほとんどありません。
あとは、CheckPromptTask の回答を PromptTask の要件と項目ごとに(1↔1、2↔2、3↔3、4↔4)突き合わせ、回答が依頼と合っているかを確認するだけです。合っていなければ原因を突き止め、最初からやり直すのではなく、的を絞って修正します。
このアプローチでは、ハルシネーションは1桁台前半のパーセンテージまで下がります。完全なゼロではありませんが、最初のテストの20%をはるかに下回ります。単体テスト、結合テスト、手動テストと組み合わせれば、より大規模で複雑な変更でも、ハルシネーションをほぼゼロに近づけられます。
具体的な比較:同じ依頼、2つの結果
依頼:「割引を直して。正しく計算されていない。」
通常のAIチャット: 名前が最も近そうなファイルを開きます。たとえば calculateDiscount() ではなく calculateDiscountRate() を開きます。プロンプトがどの関数を指すのか明示していなかったからです。そちらを修正し、正しい関数のテスト(あれば)は相変わらず何も示さず、本番のバグは残ります。割引がまだ間違っていると気づくのは、本番環境の顧客だけです。
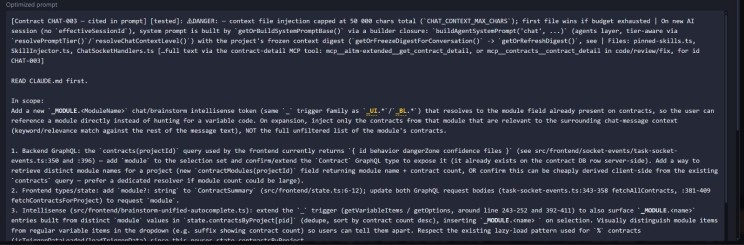
AITM: タスクが作成される前に、agent-chat が contractsForVariable / searchDom を呼び出し、まさにその割引ロジックを記述したコントラクトを見つけます。そこには具体的な files: ["src/pricing/DiscountService.ts"] フィールドと、behavior: "calculateDiscount() applies the % discount after subtracting the coupon, not before it" が含まれています。タスクのプロンプトは、一般的な「割引」ではなく、まさに %PRICING-004 を引用し、アーキテクトステップ(17日目)はそのファイルだけを開きます。エージェントが誤って calculateDiscountRate() に触れるリスクは事実上なくなります。モデルが賢くなったからではなく、何も推測する必要がなくなったからです。
なぜよく書かれたプロンプトだけより優れているのか
上記の実験のアプローチ(小さなタスク + 実際のdiffに対する CheckPromptTask による検証)は有効です。ただし、毎回自分で準備し、実行するのを忘れなければ、の話です。AITMはまさにこの原則を、すべてのタスクに対して体系的かつ自動的に適用します。
コントラクトは「ルールをプロンプトに貼り付ける」作業の代わりになります。 数値フォーマット、関数の場所、ビジネスルールを毎回の依頼で打ち直す代わりに、コントラクト(例:%PRICING-004)がそれを正確なファイル参照と動作の説明とともに一度だけ保存します。エージェントは単語の類似度で推測するのではなく、検索を始める前に正確な座標を受け取ります。
docs ステップは、すべてのタスクの後に実際にドキュメントを書きます。 「AIが重要だと判断した場合」ではありません。コントラクトの作成・更新はパイプラインの必須ステップであり、任意のエージェントメモリではありません。
実際のdiffに対する検証が組み込まれています。 手動の追加作業ではありません。パイプラインのレビューとテストのステップは、実験の CheckPromptTask と同じ原則に従い、ファイルで実際に何が変わったかを問います。
コントラクトなしで行った私自身のテストの結果は、同じ依頼を10回実行して20%のハルシネーションでした。小さなタスク + コントラクト + diffに対する検証という構造(まさにパイプラインが自動で行っていること)では、個々のステップでのハルシネーションは1桁台のパーセンテージまで下がります。モデルが違うからではなく、何も推測する必要がなく、毎回プロンプトに打ち込むべきことを誰もが覚えておく必要もないからです。
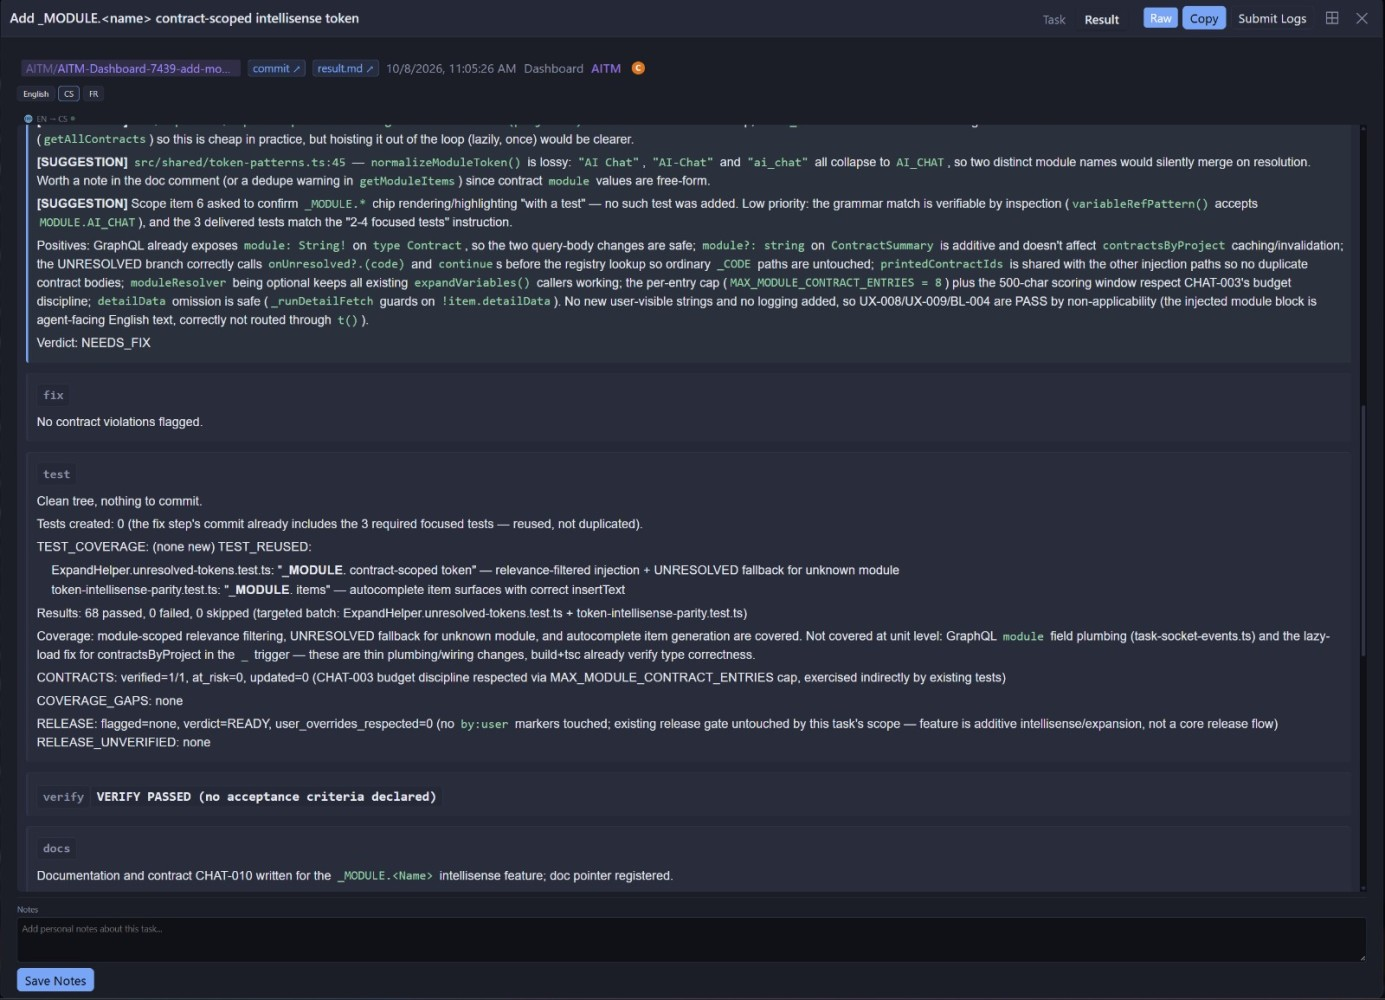
AITMはプロンプトを最適化し、最適化されたプロンプトがタスクの結果を生み出します。その結果を、タスクが求めたことと、AIが実際に行ったことに照らして確認します。