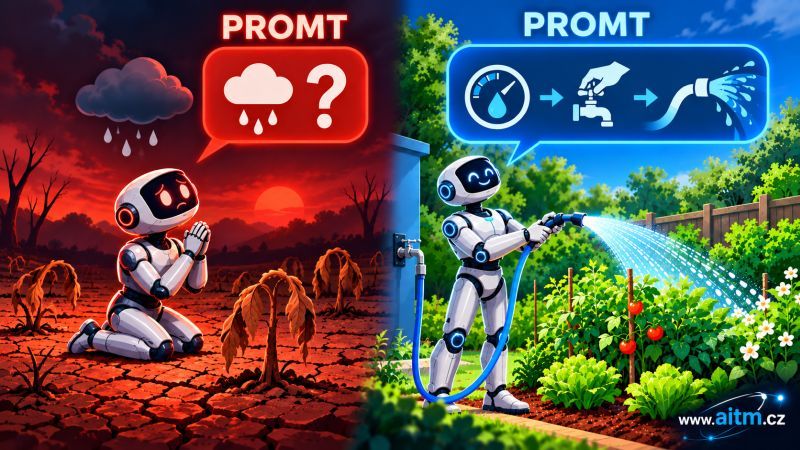
Dwie osoby dają agentowi AI pozornie to samo żądanie — i otrzymują wyniki o zupełnie różnej jakości. Czym tak naprawdę różnią się te żądania i jak to dostrzec, zanim AI w ogóle zacznie pracę? Odpowiedzią jest prosta zasada: im lepiej i konkretniej opisze się żądanie, tym lepiej AI je wykona. Brzmi to oczywiście, ale w praktyce jest to najczęstsza przyczyna złych wyników — nie za słabe możliwości modelu, lecz niedostatecznie opisane żądanie.
Zły prompt: „Napraw błąd logowania."
Dobry prompt: „W AuthService.login() występuje błąd, gdy użytkownik wpisuje e-mail z wielkimi literami — porównanie w bazie uwzględnia wielkość liter. Napraw normalizację e-maila tak, aby odbywała się PRZED porównaniem; nie ruszaj haszowania haseł ani rate limitingu w LoginThrottle.ts."
Drugi prompt zawiera cztery kluczowe rzeczy, których brakuje pierwszemu:
- Dokładną lokalizację (plik/funkcję), a nie ogólny opis.
- Opis przyczyny źródłowej, a nie tylko objawu.
- Dokładnie co zrobić, a nie tylko „napraw to."
- Czego nie wolno zepsuć — jawną granicę zmiany.
Bez punktu 4 AI ma tendencję do „ulepszania" rzeczy, których nie chciałeś ruszać — i właśnie wtedy psuje się logika w dalszej części.
To podobne do tłumaczenia pięciolatkowi, co ma zrobić. Mówi się, co i jak, ale równie ważne jest powiedzenie, czego nie robić. Dla dziecka ta granica ma głównie charakter wychowawczy; dla AI jest precyzyjną definicją tego, czego nie wolno mu badać ani modyfikować — i ta granica wyostrza wynik znacznie bardziej niż jakikolwiek opis tego, czego szukać.
Ta sama logika obowiązuje wewnątrz pojedynczego promptu: jeśli upchnie się w nim naraz kilka niezwiązanych wymagań, AI nie wie, które ma pierwszeństwo, i często interpretuje zadanie inaczej, niż zamierzono. Stąd prosta zasada: jeden prompt = jedna konkretna rzecz.
Dotyczy to w równym stopniu ręcznie pisanych promptów, jak i automatycznie generowanych zadań. A właśnie tę dyscyplinę można zautomatyzować — tak, aby prompt nie pochodził z tego, co człowiek akurat pamięta, ale z rzeczywistej, aktualnej wiedzy o kodzie (kontraktów, mapy DOM, logiki biznesowej), którą AITM utrzymuje w imieniu użytkownika.
Zanim przyjrzymy się samej strukturze promptu, warto wiedzieć jeszcze jedno: AITM nie pisze każdego promptu zadania tak samo. Gdy zadanie jest tworzone, najpierw samo się klasyfikuje (lub użytkownik wybiera) do jednej z trzech kategorii — bug (naprawa istniejącego zachowania), enhancement (ulepszenie czegoś, co już istnieje) lub feature (całkiem nowa funkcjonalność) — a każda kategoria daje inny zestaw wymagań i kryteriów weryfikacji. Na razie skupmy się na tym, co wspólne dla wszystkich trzech typów: stałej 5-blokowej strukturze.
Jak AITM faktycznie to robi — rzeczywista struktura promptu
AITM nie pisze promptów zadań dowolnie. Każdy prompt zadania wygenerowany z chatu lub brainstormingu składa się z 5 stałych bloków, w tej kolejności — a każdy blok rozwiązuje jeden konkretny problem, który inaczej prowadziłby do niejasnego zadania:
- Role — co najwyżej 3 zdania opisujące, jaką rolę i jak zachowawcze podejście ma przyjąć agent. Bez tego bloku agent nie wie, ile „kreatywności" mu wolno — a kreatywność bez barier prowadzi właśnie do niechcianych zmian.
- Context — dlaczego zadanie istnieje: zgłoszenie użytkownika, historia problemu, kto jest właścicielem obszaru. Jest oddzielony zdaniem „Context (background only — implement nothing from this block)", ponieważ bez tego zdania agent ryzykuje przypadkowe zaimplementowanie czegoś z historii tła, zamiast skupić się wyłącznie na wymaganiach.
- Requirements — jeden numerowany blok na każde wymaganie, każdy z precyzyjnym, weryfikowalnym kryterium akceptacji. Podział wymagań na numerowane bloki bezpośrednio rozwiązuje omówiony wyżej problem — jeden blok, jedna konkretna rzecz, bez mieszania kilku wymagań w jednym zdaniu.
- Scope — trzy wiersze: In scope (co wolno zmieniać), Out of scope (czego nie wolno zmieniać i kto jest tego właścicielem), Must not break (które kontrakty muszą nadal obowiązywać). To bezpośrednia realizacja zasady „powiedz AI także, czego nie robić" — bez tego bloku agent nie wie, gdzie są granice jego zmiany.
- Output and verification — każdy nowy plik tworzony przez zadanie oraz konkretne polecenia weryfikujące, ograniczone wyłącznie do tego, co ta konkretna zmiana mogła zepsuć. Dzięki temu zadanie nie jest zamykane na podstawie „wygląda na zrobione", lecz mierzalnego „to dokładne polecenie przeszło."
Warto zwrócić uwagę na odwołania do kontraktów, takie jak %AUTH-012 — to odwołanie do konkretnego kontraktu, wstawione z dokładną składnią, którą AITM rozpoznaje i automatycznie rozwija do pełnego opisu zachowania. Na tym polega różnica między „napisz własny prompt" a systemem, który egzekwuje za użytkownika precyzyjną strukturę i cytowania.
Co faktycznie zawiera kontrakt. W AITM kontrakt to rekord w bazie SQLite projektu, a nie komentarz w kodzie. Ma krótkie ID (prefiks modułu plus numer), moduł (do której części systemu należy zachowanie) i przede wszystkim pole behavior — precyzyjny, wielozdaniowy opis mechanizmu, często z odwołaniem do konkretnych wierszy w pliku i do numeru zadania, w którym zachowanie powstało. Niesie też listę plików, których kontrakt dotyczy, opcjonalnie strefę zagrożenia (danger zone) oraz listę powiązanych zmiennych. Gdy agent widzi w prompcie odwołanie „Must not break", AITM wstawia cały ten opis zamiast samego kodu — dzięki temu agent dokładnie wie, jakiego zachowania nie wolno mu naruszyć.
A testy jednostkowe? One też mają własny kod — każdy blok testowy w testach AITM nosi unikalny tag na początku opisu. Pozwala to adresować konkretny test równie precyzyjnie jak kontrakt. Kontrakt łączy się też ze ścieżką do pliku testowego, więc odwołanie do kontraktu niesie nie tylko opis zachowania, ale także bezpośrednie powiązanie z testem, który go chroni.