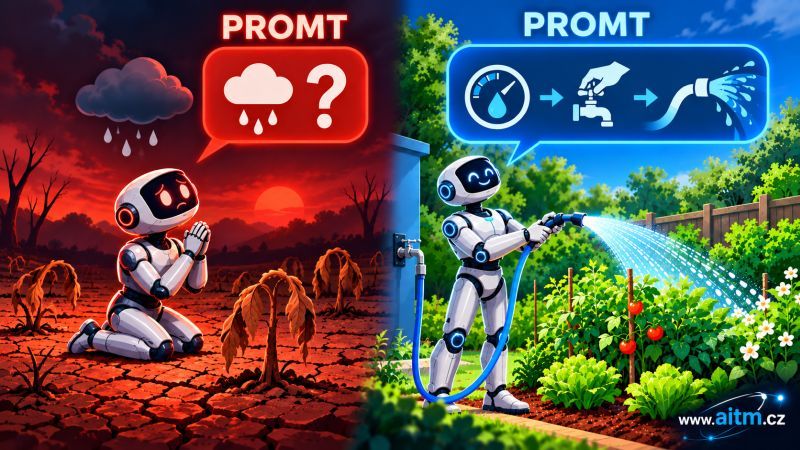
Два человека дают ИИ-агенту, казалось бы, один и тот же запрос — и получают результаты совершенно разного качества. Чем на самом деле различаются эти запросы и как заметить это ещё до того, как ИИ начнёт работать? Ответ — простое правило: чем лучше и конкретнее описан запрос, тем лучше ИИ его выполняет. Звучит очевидно, но на практике это самая частая причина плохих результатов — не недостаточные возможности модели, а недостаточно описанный запрос.
Плохой prompt: «Исправь баг входа.»
Хороший prompt: «В AuthService.login() возникает ошибка, когда пользователь вводит email с заглавными буквами — сравнение в БД чувствительно к регистру. Исправь нормализацию email так, чтобы она выполнялась ДО сравнения; не трогай хеширование паролей и rate limiting в LoginThrottle.ts.»
Второй prompt содержит четыре ключевые вещи, которых нет в первом:
- Точное место (файл/функция), а не общее описание.
- Описание первопричины, а не только симптома.
- Что именно сделать, а не просто «исправь».
- Что не должно сломаться — явная граница изменения.
Без пункта 4 ИИ склонен «улучшать» то, что вы вовсе не просили трогать, — и именно в этот момент ломается нижестоящая логика.
Это похоже на объяснение пятилетнему ребёнку, что делать. Вы говорите, что и как, но не менее важно сказать, чего делать не следует. Для ребёнка эта граница в основном воспитательная; для ИИ это точное определение того, что ему нельзя исследовать или изменять, — и эта граница делает результат гораздо точнее, чем любое описание того, что искать.
Та же логика действует и внутри одного prompt: если втиснуть в него сразу несколько не связанных требований, ИИ не знает, какое из них приоритетнее, и нередко трактует задачу иначе, чем вы задумали. Отсюда простое правило: один prompt = одна конкретная вещь.
Это в равной мере относится и к prompt, написанным вручную, и к автоматически формируемым Task. И именно эту дисциплину можно автоматизировать — чтобы prompt рождался не из того, что человек случайно помнит, а из реальных, актуальных знаний о коде (контракты, карта DOM, бизнес-логика), которые AITM поддерживает за вас.
Прежде чем рассматривать саму структуру prompt, стоит знать ещё одно: AITM пишет prompt не для каждой Task одинаково. При создании Task она сначала классифицируется сама (или вы выбираете) в одну из трёх категорий — bug (исправление существующего поведения), enhancement (улучшение чего-то уже существующего) или feature (совершенно новая функциональность), — и каждая категория порождает свой набор требований и критериев проверки. Пока же сосредоточимся на том, что общего у всех трёх типов: фиксированной структуре из 5 блоков.
Как AITM делает это на самом деле — реальная структура prompt
AITM не пишет prompt Task в свободной форме. Каждый prompt Task, сформированный из Chat или Brainstorm, состоит из 5 фиксированных блоков в таком порядке — и каждый блок решает одну конкретную проблему, которая иначе привела бы к неясной Task:
- Role — не более 3 предложений, описывающих, какую роль и какой консервативный подход должен занять агент. Без этого блока агент не знает, сколько «творчества» ему позволено, а творчество без ограничителей — как раз то, что приводит к нежелательным изменениям.
- Context — зачем существует Task: сообщение пользователя, история проблемы, кто отвечает за область. Он выделяется предложением «Context (background only — implement nothing from this block)», поскольку без него агент рискует случайно реализовать что-то из фоновой истории вместо того, чтобы сосредоточиться исключительно на требованиях.
- Requirements — по одному пронумерованному блоку на каждое требование, у каждого точный, проверяемый критерий приёмки. Разбиение требований на пронумерованные блоки напрямую решает обсуждавшуюся выше проблему — один блок, одна конкретная вещь, никакого смешения нескольких требований в одном предложении.
- Scope — три строки: In scope (что можно изменять), Out of scope (что нельзя изменять и кто за это отвечает), Must not break (какие контракты должны продолжать выполняться). Это прямая реализация правила «скажи ИИ и о том, чего делать не надо» — без этого блока агент не знает, где проходят границы его изменения.
- Output и verification — каждый новый файл, создаваемый Task, плюс конкретные команды проверки, ограниченные только тем, что именно это изменение могло сломать. Так Task закрывается не на «выглядит готово», а на измеримом «именно эта команда прошла».
Обратите внимание на ссылки на контракты вроде %AUTH-012 — это ссылка на конкретный контракт, вставленная с точным синтаксисом, который AITM распознаёт и автоматически разворачивает в полное описание поведения. Именно в этом различие между «напиши собственный prompt» и системой, которая обеспечивает за вас точную структуру и цитирование.
Что на самом деле содержит контракт. В AITM контракт — это запись в базе данных SQLite проекта, а не комментарий в коде. У него есть короткий ID (префикс модуля плюс номер), модуль (к какой части системы относится поведение) и, главное, поле behavior — точное, из нескольких предложений описание механизма, часто со ссылкой на конкретные строки в файле и на номер Task, в которой это поведение возникло. В нём также есть список файлов, которых касается контракт, при необходимости danger zone и список связанных с ним переменных. Когда агент видит в prompt ссылку «Must not break», AITM подставляет всё это описание вместо голого кода — чтобы агент точно знал, какое поведение ему нельзя нарушать.
А модульные тесты? У них тоже есть свой код — каждый тестовый блок в тестах AITM несёт в начале описания уникальный тег. Это позволяет обращаться к конкретному тесту так же точно, как к контракту. Контракт также связывается с путём к файлу теста, так что ссылка на контракт в итоге несёт не только описание поведения, но и прямую ссылку на тест, который его охраняет.