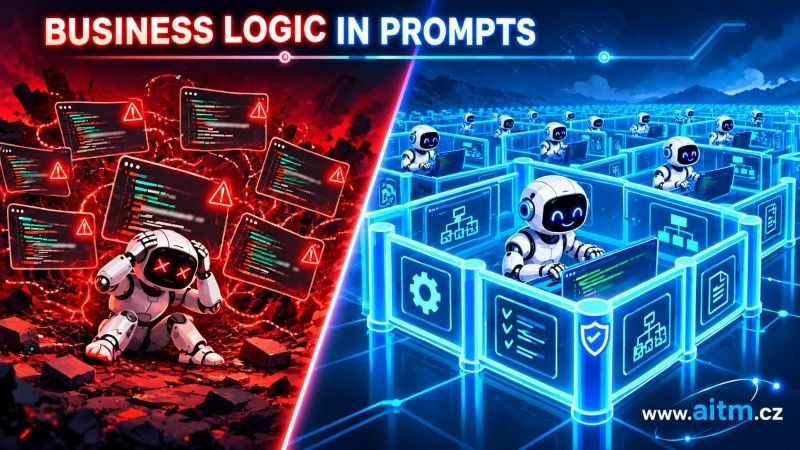
Vývoj softwaru s pomocí AI dnes často probíhá podle jednoduchého postupu:
- Napsat zadání úkolu (prompt).
- Nechat AI zpracovat analýzu a návrh řešení.
- Připravit skilly, agenty a subagenty.
- Spustit implementaci.
- Nechat AI napsat kód, otestovat ho a opravit nalezené problémy.
Na první pohled to vypadá jako ideální vývojový postup. AI pracuje samostatně, rozděluje úkoly mezi agenty, píše testy a postupně dokončuje požadovanou funkcionalitu.
A u menších projektů může tento přístup fungovat velmi dobře.
Pokud vytváříte jednoduchý e-shop, firemní web s pěti stránkami nebo základní administrační systém, AI často zvládne významnou část práce s velmi dobrými výsledky.
Proč?
Protože podobný software už vytvořily miliony vývojářů.
Představte si dva internetové obchody. Jeden prodává hračky, druhý jablka.
Z pohledu zákazníka jde o dvě odlišné firmy. Z pohledu softwarové architektury ale fungují velmi podobně:
- Produkty rozdělené do kategorií.
- Správa cen a skladových zásob.
- Nákupní košíky.
- Zpracování objednávek.
- Platební metody.
- Správa zákazníků.
Mění se především data, konkrétní obchodní pravidla a některé funkce. Základní architektonické principy zůstávají z velké části stejné.
AI tyto vzory rozpoznává, protože se s podobnými strukturami setkala během trénování.
Problém začíná ve chvíli, kdy přestanete vytvářet běžnou aplikaci a pustíte se do rozsáhlého podnikového softwaru.
Co se stane, když systém obsahuje 300 000 až 500 000 řádků kódu?
Představte si podnikovou aplikaci se stovkami tisíc řádků kódu, desítkami modulů, stovkami závislostí a složitými pravidly fungování.
Takový systém se mohl vyvíjet několik let. Za tu dobu v něm přibyla architektonická rozhodnutí, výjimky, historické závislosti a obchodní pravidla.
Ne všechna jsou zdokumentovaná.
Jediná metoda může ovlivňovat deset dalších modulů. Změna jednoho parametru může narušit fakturaci, uživatelská oprávnění nebo zpracování objednávek.
A teď si představte, že do tohoto prostředí přivedete AI agenta.
Zadáte mu úkol:
Uprav platební proces tak, aby podporoval další platební metodu. Zachovej zpětnou kompatibilitu a všechno otestuj.
Agent vytvoří plán, rozdělí práci mezi subagenty, provede změny, spustí testy a vrátí výsledek.
Všechno může vypadat správně.
Úspěšné testy ale nutně neznamenají, že software zachoval všechna existující obchodní pravidla.
A tím se dostáváme k problému, který před šesti měsíci úplně změnil můj přístup k AI agentům.
Experiment, který změnil můj pohled na agentní systémy
Před šesti měsíci jsem provedl experiment, který mě přiměl vydat se jinou cestou než pouhým přidáváním dalších agentů a subagentů.
Do té doby jsem vycházel z předpokladu, který sdílí mnoho vývojářů:
Čím lépe rozdělím úkoly mezi specializované agenty a čím více ověřovacích mechanismů zavedu, tím spolehlivější bude výsledek.
Během experimentů jsem ale narazil na zásadní otázku:
Jak může agent správně implementovat obchodní pravidlo, když ani neví, že takové pravidlo existuje?
A jak může jiný agent výsledek spolehlivě ověřit, když ani on nemá úplné informace o tom, jak se má systém chovat?
Začal jsem zkoumat, jak se mezi agenty předává kontext.
Zjistil jsem, že způsob předávání a interpretace informací se může stát jedním z nejslabších míst celého procesu.
Jak agenti a subagenti skutečně fungují?
V praxi se běžně používají dva přístupy ke komunikaci mezi AI agenty.
1. Hierarchický model — hlavní agent koordinuje subagenty
Tato architektura se obvykle označuje jako Hub-and-Spoke nebo hvězdicová topologie (Star Topology).
Princip je jednoduchý:
- Uživatel předá úkol hlavnímu agentovi.
- Hlavní agent úkol analyzuje a rozdělí na menší části.
- Vytvoří nebo aktivuje subagenta A a předá mu instrukce.
- Subagent A provede práci a vrátí výsledek.
- Hlavní agent výsledek vyhodnotí a případně předá další práci subagentovi B.
- Po dokončení všech částí hlavní agent výsledky spojí.
Subagent A nemusí vědět, na čem pracuje subagent B. Komunikaci a výměnu informací koordinuje hlavní agent.
Výhoda: centrální řízení, snazší sledování stavu, jasnější odpovědnost a nižší riziko nekontrolované komunikace mezi agenty.
Nevýhoda: hlavní agent se stává centrálním místem, přes které prochází interpretace zadání i výsledků. Pokud při delegování vynechá důležitou informaci, subagent může pracovat s neúplným kontextem.
2. Peer-to-peer — agenti komunikují mezi sebou
Druhý přístup využívá přímou nebo průběžnou komunikaci mezi agenty, například prostřednictvím sdíleného konverzačního vlákna nebo systému zpráv (Message Bus).
Představte si následující scénář:
- Agent A napíše kód a zveřejní událost
CodeWritten. - Agent B, který má na starosti testování, událost přijme a spustí testy.
- Agent C současně připravuje dokumentaci.
- Agenti si průběžně vyměňují výsledky a reagují na změny.
Výhoda: souběžné provádění úkolů, rychlá výměna informací a menší závislost na jediném centrálním agentovi.
Nevýhoda: složitější koordinace, riziko práce se zastaralými informacemi, konfliktní úpravy a obtížnější dohledávání skutečné příčiny chyb.
Oba přístupy mohou být velmi užitečné.
Ani jeden ale sám o sobě neřeší základní problém.
Agent může mít dokonale vymezený úkol. Pokud však nerozumí skutečné logice fungování systému, může vytvořit technicky správné řešení, které je z obchodního hlediska chybné.
Kde v agentních postupech vznikají chyby?
AI není deterministický překladač, který převádí instrukce přímo na zdrojový kód. Jazykový model interpretuje dostupné informace a na základě tohoto kontextu vytváří řešení.
Když informace chybí, může vycházet z nesprávných předpokladů. Když jsou neúplné nebo si odporují, může zvolit nevhodný postup.
Podívejme se na typický průběh většího úkolu.
Krok 1 — interpretace uživatelského promptu
Hlavní agent přijme zadání a snaží se pochopit požadovanou změnu.
Už v této fázi může přehlédnout závislost, špatně pochopit omezení nebo předpokládat něco, co nikdo výslovně neuvedl.
Krok 2 — vytvoření instrukcí pro subagenta
Hlavní agent připraví konkrétnější zadání. Z původního promptu vybere informace, které považuje za relevantní.
Pokud ale některá obchodní pravidla nezná, nemůže je správně předat dál.
Krok 3 — implementace
Subagent dostane instrukce, analyzuje část kódu a zvolí způsob implementace.
Může vytvořit syntakticky správný a kvalitní kód, který přitom neúmyslně změní chování, jež mělo zůstat zachováno.
Krok 4 — vyhodnocení výsledku
Hlavní agent přijme výstup subagenta, vyhodnotí jej a rozhodne, zda je úkol hotový.
Stále ale může vycházet ze stejných neúplných předpokladů jako na začátku.
Krok 5 — testování a opravy chyb
Následují unit testy, integrační testy, E2E testy, statická analýza a kontrola dokumentace.
Tyto mechanismy výrazně zvyšují spolehlivost softwaru, mají však své limity.
Test ověřuje konkrétní očekávané chování. Pokud v jeho specifikaci chybí důležité obchodní pravidlo, může implementace projít všemi testy a přitom toto pravidlo porušovat.
A když AI opravuje jeden problém, může neúmyslně zasáhnout do jiné části systému.
Vzniká tak známý cyklus:
Implementace → testování → oprava → regrese → další testování → další oprava.
Pouhé zvyšování počtu agentů nebo častější opakování testů proto automaticky nezaručuje správný výsledek.
Proč se mohou chyby v řetězci agentů hromadit?
Uvažujme zjednodušený matematický model.
Předpokládejme tři po sobě jdoucí kroky, z nichž každý má hypotetickou 95% pravděpodobnost správného provedení.
Pokud jsou tyto kroky nezávislé a všechny tři musí uspět, pravděpodobnost je:
0,95 × 0,95 × 0,95 = 0,8574
To představuje přibližně 85,7% pravděpodobnost, že uspějí všechny tři kroky.
Pro deset takových nezávislých kroků by výsledek byl:
0,95¹⁰ ≈ 59,9 %
Jde o ilustrativní výpočet, nikoli o naměřenou úspěšnost AI agentů. Ve skutečných systémech nejsou chyby vždy nezávislé, ověřovací mechanismy mohou omyly zachytit a jednotlivé kroky mohou napravit předchozí selhání.
Příklad však ukazuje důležitý princip:
Spolehlivost jednotlivých agentů automaticky nezaručuje spolehlivost celého řetězce.
Pokud se neúplné instrukce v každé fázi znovu interpretují, vznikají další příležitosti k nesprávným rozhodnutím.
Proto se domnívám, že pouhé přidávání agentů, testů a ověřovacích mechanismů nestačí.
Musíme změnit způsob, jakým AI dostává informace o samotném systému.
Zásadní rozdíl: testy ověřují výsledky, business logika vymezuje hranice
Běžný přístup k vývoji s pomocí AI je reaktivní.
Zadáte požadavek, AI implementuje řešení a pomocí testů se následně zjišťuje, zda se něco nerozbilo.
To je samozřejmě lepší než žádné testy.
Stále tu ale zůstává zásadní slabina:
Testy nemohou spolehlivě ověřit obchodní pravidla, o kterých nikdo neví a která nejsou součástí specifikace testů.
Za lepší přístup proto považuji poskytnout AI informace o skutečném chování systému ještě před zahájením implementace.
Nejen to, co se má změnit, ale také:
- Jaká obchodní pravidla platí pro dotčený kód.
- Které další moduly na dané funkcionalitě závisejí.
- Které vstupy a výstupy musí zůstat kompatibilní.
- Které scénáře se nesmějí změnit.
- Jaké existují výjimky a historická omezení.
- Které části implementace smí AI upravit a které musí zachovat.
Tím se výrazně snižuje množství chování, které si AI musí odvodit sama.
Dva přístupy ke stejnému úkolu
Přístup A — prompt + testování
AI dostane úkol, podle dostupného kontextu zvolí implementaci, vytvoří řešení a spustí testy.
Pokud jsou testy neúplné, může porušení existujících obchodních pravidel zůstat neodhalené.
Přístup B — prompt + business logika + testování
AI dostane úkol spolu s příslušnými pravidly, závislostmi, kontrakty a omezeními.
Díky tomu ví ještě před zahájením implementace, jaké chování musí zachovat.
Testy pak nejen odhalují chyby, ale také ověřují konkrétní kontrakty popisující obchodní pravidla.
Rozdíl nespočívá v tom, že přestaneme testovat.
Spočívá v tom, že se snažíme chybám předcházet ještě před jejich vznikem.
Praktický příklad: přidání nové platební metody
Představme si soubor CheckoutService.ts, který v e-shopu zajišťuje platby.
Chceme přidat platbu kartou jako další platební metodu.
Varianta A: běžný prompt
Zadání:
Přidej platby kartou do
CheckoutService.ts. Zachovej stávající funkcionalitu a spusť všechny testy.
AI upraví kód, přidá novou větev pro platby a aktualizuje testy.
Všechny testy projdou.
Úkol je označen jako dokončený.
V systému ale existuje důležité obchodní pravidlo:
U firemních účtů musí zůstat výchozí platební metodou bankovní převod.
Pravidlo vzniklo před několika lety. Vývojář, který ho implementoval, už ve firmě nepracuje. Není jasně zdokumentované a neexistuje pro něj samostatný regresní test.
AI nastaví platbu kartou jako výchozí pro všechny zákazníky.
Z hlediska implementace nová funkcionalita funguje správně.
Z hlediska obchodní logiky je systém rozbitý.
A testy tento problém neodhalily.
Varianta B: strukturované zadání s business logikou v AITM
Teď si představte, že AI dostane stejný požadavek, ale tentokrát zadání obsahuje relevantní kontrakt popisující obchodní pravidla, související proměnné, odkazy na historické úkoly a přesné hranice povolených změn.
Zadání může vypadat takto:
Nejprve si přečti CLAUDE.md.

ÚKOL (TASK):
Přidej platbu kartou jako další platební metodu
v CheckoutService.ts.

Kontrakt (Contract):
%CHECKOUT-019 — „U firemních účtů
(companyId != null) musí zůstat výchozí platební metodou
bankovní převod. Platbu kartou lze nabídnout pouze
jako další možnost.“

Související proměnné (Related variables):
BL.CHECKOUT.PAYMENTMETHOD_DEFAULT
BL.CHECKOUT.PAYMENTMETHOD_OPTIONS

Související úkol (Related task):
#<odkaz na úkol, který původně zavedl bankovní převod
jako výchozí platební metodu při dokončení objednávky>

Co je součástí změny (In scope):
- Přidat novou možnost „card“ mezi dostupné platební metody
  v CheckoutService.ts.
- Zpřístupnit ji jako volitelnou možnost ve stávajícím
  postupu výběru platební metody.

Co není součástí změny (Out of scope):
- Změna výchozí platební metody pro jakýkoli typ účtu.
- Jakákoli úprava návrhu UI nebo průchodu objednávkou
  nad rámec přidání nové možnosti.
- Nová logika integrace poskytovatele plateb
  nad rámec samotné registrace metody.

Co se nesmí rozbít (Must not break):
- Stávající logika výběru výchozí platby
  (u firemních účtů zůstává výchozí bankovní převod).
- Chování celého procesu dokončení objednávky u firemních účtů.
- Stávající postup zpracování bankovního převodu.
- Kompatibilita se současným kontraktem platebního API.

Cesta k souboru (File path):
src/Services/CheckoutService.ts
Před úpravami ověř přesnou cestu pomocí contractsForFile.

Ověření (Verify):
- U firemního účtu je při dokončení objednávky stále
  předvolen bankovní převod (companyId != null).
- Platba kartou se zobrazuje jako volitelná, nikoli výchozí možnost.
- Stávající zpracování bankovního převodu se nezměnilo.
- Spusť unit a integrační testy pokrývající CheckoutService.
Více informací o tom, jak tento postup funguje v AITM: Sdílení znalostí a dokumentace.
Proč je tento formát důležitý?
Na první pohled se může zdát, že jde jen o podrobnější prompt.
Skutečný rozdíl ale spočívá v tom, že zadání je propojené s informacemi, které lze dohledat a ověřit proti skutečnému projektu.
1. Kontrakt %CHECKOUT-019
Identifikátor %CHECKOUT-019 není jen textová poznámka.
Jde o ilustrativní identifikátor kontraktu, který může agent načíst prostřednictvím operací GraphQL, například contractsForFile nebo contractsForVariable.
Místo spoléhání pouze na pravidlo napsané v promptu může agent získat jeho strukturovanou podobu a ověřit ji proti aktuálnímu kódu projektu.
2. Proměnné business logiky _BL.
Identifikátory jako _BL.CHECKOUT.PAYMENT_METHOD_DEFAULT a _BL.CHECKOUT.PAYMENT_METHOD_OPTIONS představují business logiku vyjádřenou pomocí komunikačního jazyka AITM.
Pomáhají propojit konkrétní požadavek s pravidly a proměnnými, které určují chování systému.
3. Odkaz na související úkol
Sekce Related task odkazuje na původní úkol, v němž bylo dané obchodní pravidlo implementováno.
AI tím získává další kontext: nejen jak se systém aktuálně chová, ale také proč mohlo být konkrétní rozhodnutí přijato.
4. Jasně vymezené hranice změny
Sekce In scope, Out of scope a Must not break vymezují tři samostatné kategorie:
- Co musí AI implementovat.
- Co AI implementovat nesmí.
- Jaké stávající chování musí AI zachovat.
Místo otevřeného zadání, které si může volně vyložit nebo rozšířit, dostává AI přesně stanovený rozsah implementace.
5. Ověření před psaním kódu
Správnost cesty k souboru se automaticky nepředpokládá.
Agent má nejprve použít contractsForFile, potvrdit skutečnou cestu a zjistit související kontrakty.
Teprve potom má začít upravovat kód.
6. Validace promptu pomocí TPV
Důležitou součástí přístupu AITM je validátor promptů TPV.
Před předáním úkolu ke spuštění kontroluje povinné části zadání.
Ověřuje například přítomnost vymezení rozsahu, omezení, kontraktů, cest k souborům a požadavků na ověření.
Část prevence chyb se tím přesouvá z testování hotového kódu už do přípravy samotného zadání.
Poznámka: identifikátory kontraktů a proměnné business logiky v tomto příkladu jsou ilustrativní zástupné hodnoty. Ve skutečném projektu je optimalizátor získává prostřednictvím GraphQL z konkrétního projektu. Neměly by se odhadovat ani vytvářet bez ověření.
Co se tímto přístupem mění?
V běžném přístupu agent nejprve interpretuje otevřené zadání a sám rozhoduje, které soubory, závislosti a obchodní pravidla jsou důležité.
V AITM je úkol propojen s konkrétními kontrakty, proměnnými business logiky, historickými úkoly a jasně vymezenými hranicemi změn.
Agent se tak může rozhodovat na základě ověřitelných informací, místo aby se opíral především o předpoklady.
A právě v tom vidím zásadní rozdíl.
Business logika už není pouze součástí dokumentace. Stává se přímo součástí řízení implementace.
Na tomto principu stojí AITM
Když jsme začali navrhovat AITM (AI Task Manager), nechtěli jsme vytvořit jen další systém, který spouští agenty, rozděluje úkoly a následně kontroluje jejich výsledky.
Zaměřili jsme se na jinou otázku:
Co kdyby AI mohla ještě před jakoukoli změnou získat relevantní business logiku přímo z existujícího zdrojového kódu?
Nejen dokumentaci, kterou někdo napsal před rokem.
Nejen obecné instrukce uložené ve skillu.
A nejen několik souborů, které si agent náhodou vybere.
Místo toho strukturované informace popisující, jak se dotčená část systému skutečně chová, jaké kontrakty ji řídí a které další komponenty na ní závisejí.
Základním principem AITM je proto obohatit pracovní prompt o business logiku zjištěnou z relevantních částí kódu projektu.
Agent dostává nejen informace o tom, co musí udělat, ale také o tom, co musí zachovat.
To je zvlášť důležité u rozsáhlých softwarových systémů, kde jediný prompt nemusí obsahovat všechny relevantní závislosti nebo omezení. Přípravu zadání a jeho optimalizaci popisuje dokumentace Vytváření tasku.
Business logika jako mantinely pro AI
Představte si business logiku jako svodidla podél silnice.
Bez nich se AI může vydat mnoha různými cestami. Některé vedou ke správnému řešení, jiné mohou porušit skrytá pravidla systému.
Poskytnutím příslušných kontraktů a omezení výrazně zužujeme prostor pro nežádoucí rozhodnutí.
AI si stále může samostatně vybírat postup implementace, algoritmy a strukturu kódu.
Musí ale respektovat známá obchodní pravidla.
Následné testování pak ověří, zda tato pravidla skutečně zůstala zachována.
Jde o zásadní změnu přístupu.
Nesnažíme se jen opravovat chyby, které AI vytvoří. Snažíme se snížit pravděpodobnost, že vůbec vzniknou.
Znamená to, že už nepotřebujeme agenty a testy?
Rozhodně ne.
Agenti jsou užiteční pro souběžné provádění úkolů, specializované činnosti a automatizaci rozsáhlé práce.
Unit testy, integrační testy a E2E testy zůstávají nezbytnou součástí zajištění kvality softwaru.
Orchestrace agentů a automatizované testování ale nemohou nahradit znalost business logiky.
Pokud agent nerozumí tomu, co musí systém zachovat, ani dokonale organizovaný tým subagentů základní problém nevyřeší.
A pokud testy nepokrývají příslušné scénáře, mohou všechny projít, přestože se aplikace z obchodního hlediska stále chová nesprávně.
Správným přístupem není volit mezi business logikou a testováním. Je potřeba je spojit.
- Nejprve zjistit skutečné chování systému.
- Potom jej vyjádřit pomocí jasných pravidel a kontraktů.
- Následně tato pravidla předat AI společně se zadáním.
- Teprve potom přistoupit k implementaci, ověřování a testování.
Tento postup může omezit zbytečné opravy, regrese a opakované implementační cykly.
Závěr: rozhoduje kvalita informací, nejen počet agentů
U jednoduchých aplikací může AI dosahovat výborných výsledků i s poměrně stručnými instrukcemi.
U podnikového softwaru s půl milionem řádků kódu ale nestačí předpokládat, že agent všechno správně pochopí, odhalí každou závislost a potom bezchybně otestuje vlastní práci.
Čím je systém rozsáhlejší, tím důležitější je porozumět jeho skutečnému obchodnímu chování a chránit ho.
Můžete mít deset agentů, kteří dokonale spolupracují. Pokud ale žádný z nich nezná zásadní obchodní pravidlo, mohou společně vytvořit dokonale otestované řešení, které je ve své podstatě chybné.
Proto v AITM postupujeme jinak.
Nejprve kontext, pravidla a kontrakty. Potom implementace. A nakonec ověřování a testování.
Cílem totiž není, aby AI napsala co nejvíce kódu za co nejkratší dobu.
Cílem je, aby AI změnila přesně to, co změnit má, a přitom nerozbila to, co už funguje.
Zdroj: When AI starts writing software that is no longer simple — AITM – AI Task Manager, LinkedIn