当你从零开始一个新项目时,AI 编程就像纯粹的魔法。你输入一个提示词,模型毫不犹豫地生成一个干净的组件,或一个可以运行的后端接口。
但随着代码库不断增长,现实会给你一记当头棒喝。
大约在 10 万行代码时,普通的 AI 开始明显力不从心。它试图猜测,盲目地搜索仓库,并凭空捏造不存在的函数。大约在 30 万行时,模型的独立判断基本崩溃:上下文窗口不够用,对整个项目做传统的 grep 会烧掉成千上万个 token,开发变成了不断修复坏代码的无限循环。
正是在这一刻,系统契约接过了缰绳。
AITM 中的契约是什么?
契约不是普通的行内代码注释,也不是某个被遗忘的 README.md 里的一行文字,那种文字过了两个迭代就不再成立。
它是可被机器查询的系统行为。
它精确描述应用的某个具体部分应该做什么,并指向确切的源文件、测试和 UI 元素。智能体不必摸索着去读几十个文件,而是直接向系统提问:"这个行为在哪里、是如何实现的?",并立刻得到精确的答案。
AITM 中的每一份契约都建立在三个关键支柱之上:
- behavior:对代码所做之事的一行概括。所有字段中最重要的一个。智能体会把这条规则与文件中的实际实现进行比对。一旦出现矛盾,系统立即知道这要么是一个 bug,要么是一份过时的契约。
- confidence:信息可信度的度量。它表明该描述相对于系统中其他数据有多可靠(例如行为是否已被真实测试验证)。
- variables:与系统共同通信语言的连接(例如
BL.PIPELINE)。它充当前端与后端业务逻辑之间的桥梁,因此可以按 UI 或数据层的具体部分迅速过滤契约。
来自生产环境的真实示例
在 AITM 中,契约是结构化的,并可通过 GraphQL API 立即获取:
contractsForFile(path: "src/pipeline/MergeQueueService.ts", projectId: "ctm-dashboard") {
  id          # "GM-057"
  module      # "Git/Merge"
  behavior    # "自合并后的重启是手动的:合并之后,dev-watch 会继续提供合并前的代码,直到用户在菜单中点击 Restart,或 Settings.selfMergeRestartMode 为 'auto'。"
  confidence  # "tested"
}
这是它与静态文档的根本区别。智能体在打开或写下任何一行代码之前,就会先请求契约。它不会盲目行动,不浪费上下文,并且清楚地知道该给这条规则赋予多大的权重。
节省 token 与算力:低到中等 effort 的 Claude Sonnet
通过契约进行精确引导,最大的好处之一是 AI 模型本身的效率。
在 AITM 中,我们的智能体运行在 Claude Sonnet 上,effort(thinking)设置为低到中等。当模型拥有精确的契约时,它不需要花几分钟去"思考",不需要对整个仓库的架构做出推测,也不需要把庞大的 reasoning 预算烧在琐碎的调研上。
有了契约,模型手里就有了一张现成的地图:
- 它确切知道该去哪个文件。
- 它了解预期行为(
behavior)。 - 它知道该在多大程度上信任这条信息(
confidence)。
因此,即使 effort 较低,Claude Sonnet 也能完成完全确定、干净的工作,因为它不必依赖自己的"猜测",而是严格遵循给定的规范。
在 50 万行代码上的结果
这种方法的真正威力不会出现在项目的最初几天,而是在代码库增长到企业级规模的时候。
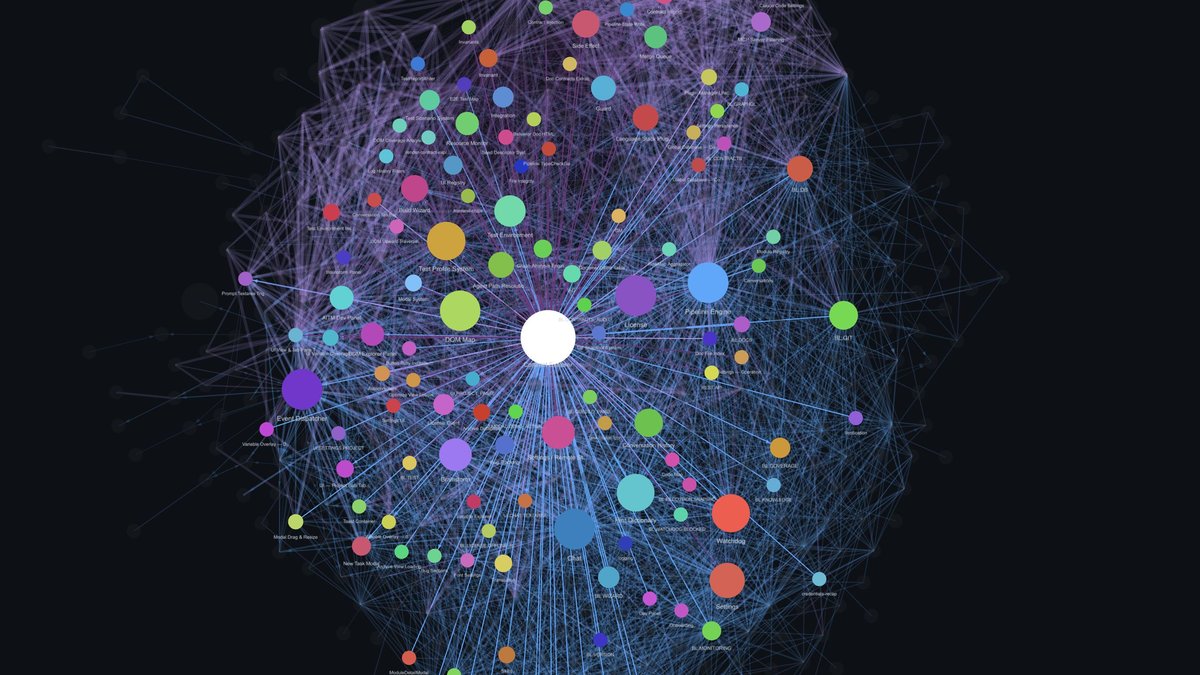
在我们自己超过 50 万行代码的系统中,如今约有 3500 份契约稳定运行:
- 告别盲目 grep: 智能体不再搜索数百个文件,而是直接走向确定的位置。
- 大幅减少 token 与幻觉: 上下文窗口保持干净,模型不会因信息过载而受影响。
- 结果始终一致: 即使在拥有五十万行代码的项目上,AI 也能达到与在空仓库中处理第一条提示词时相同的速度和精度。