¿Cómo es posible que la IA arregle con total tranquilidad una función completamente distinta de la que querías decir y esté plenamente convencida de haber hecho exactamente lo que le pediste? La respuesta se llama alucinación.
En los modelos de lenguaje significa que el modelo genera una respuesta que suena segura y lógica, pero que no se corresponde con la realidad ni con lo que realmente se pidió. En el código adopta una forma concreta: la IA tiende a elegir la opción más cercana por similitud de palabras, aunque esa opción no coincida con el requisito real.
Ejemplo: le pides que arregle la función calculateDiscount(). Pero el código también contiene calculateDiscountRate() y applyDiscount(). El modelo, sobre todo sin un contexto preciso, puede "suponer" que te referías a la función de nombre parecido y arreglar el lugar equivocado. El resultado parece terminado, las pruebas (si no existen) no dicen nada, y el error aparece tres pasos más tarde.
Qué reduce la alucinación:
Una referencia exacta a archivo y línea, no solo el nombre de una función recordado de memoria.
Contexto de negocio: para qué sirve la función, no solo qué hace técnicamente.
Una prohibición explícita de tocar lugares con nombre parecido pero distintos.
Pasos más pequeños y verificables: la alucinación en un paso pequeño se detecta rápido; en un paso gigante se pierde.
Aquí es exactamente donde el enfoque habitual de "escribir un prompt y esperar lo mejor" toca techo. Hace falta un sistema que sepa dónde están las cosas antes incluso de que se lo preguntes al agente de IA, y eso es justo lo que resuelven los contratos, que veremos a partir de la próxima semana.
Por qué esto no se limita a nombres de funciones parecidos
El mismo problema no se limita a elegir la función equivocada; afecta a la búsqueda de información en el propio código. Cuando el mismo tema (digamos, "factura") aparece a la vez en varias clases, métodos, eventos y elementos del DOM, la IA busca en el código solo hasta encontrar la primera coincidencia que "tiene sentido" y se detiene ahí. Si la lógica real que necesitas corregir vive en otro sitio (por ejemplo, en una clase TemplateInvoice aparte, no en el cálculo genérico de la factura), el modelo nunca la abre. No es que haya buscado en pocos archivos, es que solo compara con la coincidencia más cercana a la petición y no sigue adelante.
Tener documentación o skills preparadas de antemano ayuda: la IA llega a la información correcta más rápido y con más precisión. El problema es que esa documentación no se mantiene sola: si nadie la guarda después de una tarea, o si la propia IA decide que un dato "no es importante", se queda sin guardar. El agente solo guarda lo que considera más importante de toda la ejecución, no todo. En proyectos más grandes, además, la búsqueda se vuelve más lenta: las piezas individuales de lógica de negocio se van perdiendo, y si hay varios documentos sobre el mismo tema (por ejemplo, la factura mencionada tanto en un documento de facturas como en uno de plantillas), la IA suele leer solo el primero que encuentra, decide que es una fuente suficiente y nunca abre los demás.
Esto tiene una consecuencia práctica para los prompts: si cada petición tiene que decir "no olvides esto y aquello, comprueba también allá", deja de ser programar y se convierte en recordar constantemente. Es una señal de que esa información pertenece al sistema (una skill, un contrato), no a la cabeza de la persona que tiene que teclearla en un prompt cada vez.
Experimento: mismo prompt, mismo modelo, resultado distinto
Para comprobar la hipótesis hice un experimento sencillo. En el prompt escribí: "abre y lee el archivo de instrucciones y síguelo". El archivo decía: cuando trabajes con un número real, muéstralo en el frontend como número decimal con el formato #.00 y guárdalo en el log con el mismo formato.
Después encargué construir un formulario con dos campos: edad (entero) y altura (número real), además de los requisitos habituales (color, posición, un botón Guardar, guardado en la base de datos). Ejecuté el mismo prompt diez veces, cada vez en una sesión limpia, sin memoria entre ejecuciones, con el mismo modelo.
Resultado: en 2 de las 10 ejecuciones el modelo ignoró la instrucción de formato numérico del archivo referenciado. El mismo prompt, las mismas condiciones, el mismo modelo, y aun así un 20 % de alucinación. Al preguntarle por qué, la respuesta fue siempre la misma: en ese momento el modelo había juzgado más importantes otras partes de la petición y "olvidó" la instrucción de formato.
Cómo reducir realmente la alucinación
Dejar que la IA compruebe su propio trabajo no basta. La comprobación en sí es tan propensa a alucinar como la tarea original. En la práctica funciona mejor dividir el trabajo en dos pasos:
1. Una tarea pequeña y definida de forma explícita. Es mejor poner el contenido de la regla directamente en el prompt, en lugar de limitarse a referenciar un archivo que la IA "puede o no" leer por completo.
PromptTask:
un formulario
campos de entrada con el formato correcto según el tipo: int con 0 decimales, real con 2 decimales (esto también puede vivir en un archivo, pero debe incluirse directamente en el prompt, no solo referenciarse, para que la IA no tenga que leerlo por su cuenta),
registrar en el log los valores reales con 2 decimales
guardar en la base de datos.
2. Un prompt de verificación aparte (*CheckPromptTask*), que se ejecuta solo cuando termina la primera tarea, con la misma estructura numerada que la petición: le preguntamos a la IA exactamente lo que definimos en PromptTask:
CheckPromptTask:
¿cómo se implementó el formulario?
¿cómo se formatean los campos de entrada int y real?
¿cómo se guardan los valores reales en el log?
¿los datos del formulario se guardan realmente en la base de datos?
La clave es que la IA responde a estas preguntas basándose en el cambio real en el código (el diff, los archivos), no en su propia memoria ni en una suposición: en este paso casi no tiene margen para alucinar, porque responde a partir de lo que realmente hay en el archivo.
Después solo queda comparar las respuestas de CheckPromptTask punto por punto con los requisitos de PromptTask (1↔1, 2↔2, 3↔3, 4↔4): si la respuesta coincide con la petición. Si algo no coincide, se rastrea la causa y la corrección es dirigida, no un rehacer desde cero.
Con este enfoque, la alucinación baja a porcentajes de un solo dígito bajo: no es un cero limpio, pero queda muy por debajo del 20 % de la primera prueba. Combinado con pruebas unitarias, pruebas de integración y pruebas manuales, la alucinación en cambios más grandes y complejos puede reducirse casi a cero.
Comparación concreta: misma petición, dos resultados
Petición: "Arregla el descuento, no se calcula bien."
Chat de IA normal: abre el archivo que más se parece al nombre, por ejemplo calculateDiscountRate() en lugar de calculateDiscount(), porque el prompt nunca dijo a qué función exacta te referías. Arregla esa, la prueba (si existe) de la función correcta sigue sin mostrar nada y el error de producción permanece. Solo un cliente en producción descubre que el descuento sigue mal.
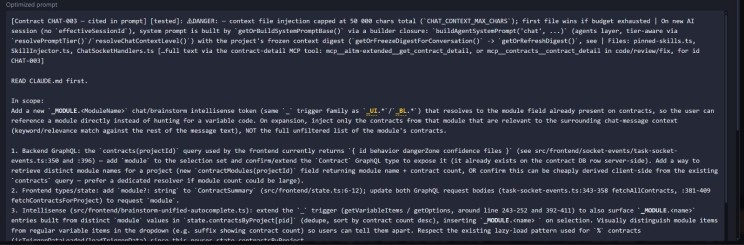
AITM: antes incluso de crear la tarea, agent-chat llama a contractsForVariable / searchDom y encuentra el contrato que describe exactamente la lógica del descuento, con un campo concreto files: ["src/pricing/DiscountService.ts"] y behavior: "calculateDiscount() aplica el descuento en % después de restar el cupón, no antes". El prompt de la tarea cita entonces exactamente %PRICING-004, no un "descuento" genérico, y el paso de arquitecto (Día 17) abre únicamente ese archivo. El riesgo de que el agente toque calculateDiscountRate() por error desaparece en la práctica. No porque el modelo se haya vuelto más listo, sino porque no tiene que adivinar nada.
Por qué esto supera a un prompt bien escrito por sí solo
El enfoque del experimento anterior (tarea pequeña + verificación CheckPromptTask contra el diff real) funciona, pero solo si una persona lo prepara ella misma cada vez y se acuerda de ejecutarlo. AITM aplica exactamente este principio de forma sistemática y automática, en cada tarea:
Los contratos sustituyen al "pega la regla en el prompt". En lugar de que el usuario tenga que reescribir en cada petición el formato de números, la ubicación de una función o una regla de negocio, un contrato (p. ej. %PRICING-004) lo almacena una sola vez, con una referencia exacta al archivo y una descripción del comportamiento. El agente no adivina por similitud de palabras: recibe la coordenada exacta antes incluso de empezar a buscar.
El paso de docs escribe realmente la documentación después de cada tarea, no "si la IA decide que es importante". Escribir/actualizar un contrato es un paso obligatorio del pipeline, no una memoria opcional del agente.
La verificación contra el diff real viene integrada, no es un paso manual adicional. Los pasos de revisión y de pruebas del pipeline preguntan qué cambió realmente en los archivos, siguiendo el mismo principio que CheckPromptTask en el experimento.
El resultado de mi propia prueba sin contratos fue un 20 % de alucinación en diez ejecuciones de la misma petición. Con la estructura de tarea pequeña + contrato + verificación contra el diff (exactamente lo que hace el pipeline automáticamente), la alucinación en un paso individual baja a porcentajes de un solo dígito: no porque el modelo sea distinto, sino porque no tiene que adivinar nada y nadie tiene que acordarse de teclear todo en el prompt cada vez.
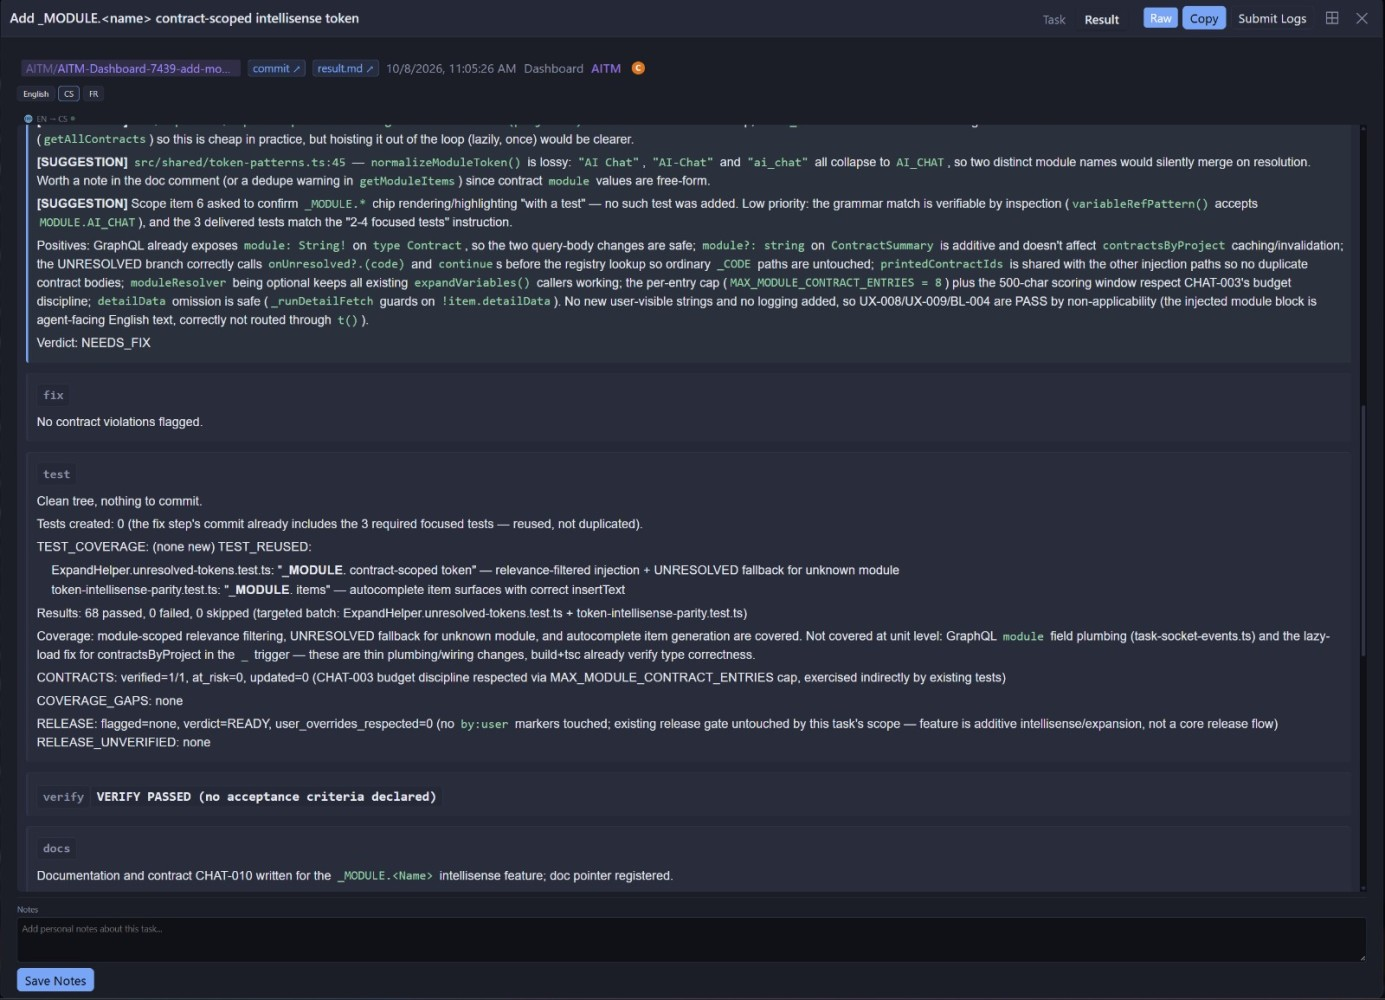
AITM optimiza el prompt, y el prompt optimizado produce el resultado de la tarea. Después comprobamos ese resultado frente a lo que la tarea exigía y a lo que la IA hizo realmente.