为什么 AI 会若无其事地修改一个与你本意完全不同的函数,还笃定自己完全照你的要求做了?答案就叫幻觉!
对语言模型而言,幻觉是指模型生成的回答听起来自信且合乎逻辑,却与现实或实际请求不符。在代码中,它表现为一种特定的形态:AI 倾向于按字面相似度挑选最接近的选项,即使该选项并不符合真正的需求。
举个例子:你要求修复函数 calculateDiscount()。但代码里还有 calculateDiscountRate() 和 applyDiscount()。模型在缺少精确上下文的情况下,可能会"以为"你指的是名称相近的那个函数,于是修改了错误的位置。结果看起来已经完成,测试(如果没有的话)毫无反应,而 bug 会在三步之后才浮出水面。
哪些做法可以减少幻觉:
精确的文件和行号引用,而不只是凭记忆回想的函数名。
业务上下文——说明这个函数是做什么用的,而不只是技术上做了什么。
明确禁止触碰名称相似但实际不同的位置。
更小、可验证的步骤——小步骤中的幻觉很快会被发现;在巨大的步骤里,它会被淹没。
这正是"写个 prompt 然后碰运气"这种常见做法遇到天花板的地方。我们需要一个在你向 AI 智能体提问之前就知道各处在哪里的系统,而这正是契约(contracts)要解决的问题,我们将从下周开始讲解。
为什么这不只是相似函数名的问题
同样的问题并不局限于选错函数,它也影响在代码中查找信息。当同一个主题(比如"发票")同时出现在多个类、方法、事件和 DOM 元素中时,AI 只会搜索到第一个"说得通"的匹配项就停下来。如果你真正需要修复的逻辑在别处(比如在单独的 TemplateInvoice 类中,而不是通用的发票计算里),模型根本不会打开它。这并不是它搜索的文件太少,而是它只与最接近请求的匹配项做比较,然后就不再继续了。
提前准备好文档或 skill 会有帮助,AI 能更快、更准确地找到正确的信息。问题在于,这类文档不会自己维护:如果任务结束后没有人保存,或者 AI 自己认为某条信息"不重要",它就不会被保存下来。智能体只会保存它认为整个运行过程中最重要的内容,而不是全部。在较大的项目中,搜索也会变慢:各个业务逻辑片段逐渐丢失,而且如果同一主题有多份文档(比如发票同时出现在发票文档和模板文档中),AI 往往只读它找到的第一份,认定它已是足够的信息来源,就不会再打开其他文档。
这对 prompt 有实际影响:如果每个请求都必须写上"别忘了这个和那个,还要检查那里",那就不再是编程,而是不停地提醒。这说明这些信息应当属于系统(skill、契约),而不是存在于那个每次都要把它们敲进 prompt 的人的脑子里。
实验:相同的 prompt,相同的模型,不同的结果
为了验证这一假设,我做了一个简单的实验。在 prompt 中我写道:"打开并阅读说明文件,并按其执行。"文件里写的是:处理实数时,在前端以 #.00 格式的小数显示,并以同样的格式存入日志。
然后我给出一个任务:构建一个带两个字段的表单,年龄(整数)和身高(实数),外加常规要求(颜色、位置、一个"保存"按钮、保存到数据库)。我用同一个 prompt 运行了十次,每次都在干净的会话中,运行之间不带任何记忆,使用同一个模型。
结果:在 10 次运行中,有 2 次模型忽略了所引用文件中的数字格式化指令。同样的 prompt、同样的条件、同样的模型,仍然有 20% 的幻觉。问它为什么,答案总是一样:在那一刻,模型判断请求的其他部分更重要,于是"忘记"了格式化指令。
如何真正减少幻觉
仅仅让 AI 检查自己的工作是不够的。检查本身和原始任务一样容易产生幻觉。在实践中,把工作拆成两步效果更好:
1. 一个小而明确定义的任务。 最好把规则的内容直接写进 prompt,而不是只引用一个 AI"可能读完也可能没读完"的文件。
PromptTask:
一个表单
输入字段按类型正确格式化——int 为 0 位小数,real 为 2 位小数(这也可以放在文件里,但必须直接包含在 prompt 中,而不是仅仅引用,这样就不必让 AI 自己去读),
日志中的 real 值保留 2 位小数
保存到数据库。
2. 一个单独的验证 prompt(*CheckPromptTask*),仅在第一个任务完成后运行,与请求具有相同的编号结构——我们精确地询问 AI 我们在 PromptTask 中定义的内容:
CheckPromptTask:
表单是如何实现的?
int 和 real 输入字段是如何格式化的?
real 值是如何存入日志的?
表单数据是否真的保存到了数据库?
关键在于,AI 是基于代码中的实际变更(diff、文件)来回答这些问题,而不是凭自己的记忆或猜测——在这一步它几乎没有产生幻觉的空间,因为它是根据文件中真实存在的内容来回答的。
接下来只需把 CheckPromptTask 的回答与 PromptTask 的要求逐点对照(1↔1、2↔2、3↔3、4↔4)——看回答是否与请求相符。如果有不符之处,就追查原因并有针对性地修复——而不是推倒重来。
采用这种方法,幻觉率降到个位数的低百分比——不是彻底归零,但远低于第一次测试中的 20%。再结合单元测试、集成测试和手动测试,在更大、更复杂的变更上,幻觉可以被压到接近零。
具体对比:同一个请求,两种结果
请求:"修一下折扣,它算得不对。"
普通 AI 聊天: 打开名字看起来最接近的文件——比如 calculateDiscountRate() 而不是 calculateDiscount(),因为 prompt 从未说明你指的是哪个具体函数。它修复了那个函数,而针对正确函数的测试(如果有的话)仍然毫无反应,生产环境的 bug 依然存在。只有生产环境中的客户才会发现折扣仍然是错的。
AITM: 在任务创建之前,agent-chat 就会调用 contractsForVariable / searchDom,找到恰好描述折扣逻辑的契约——其中带有具体的 files: ["src/pricing/DiscountService.ts"] 字段和 behavior: "calculateDiscount() 在扣除优惠券之后应用百分比折扣,而不是之前"。随后任务 prompt 会精确引用 %PRICING-004,而不是笼统的"折扣",架构师步骤(第 17 天)只会打开那一个文件。智能体误改 calculateDiscountRate() 的风险实际上消失了。这并不是因为模型变聪明了,而是因为它不必再猜任何东西。
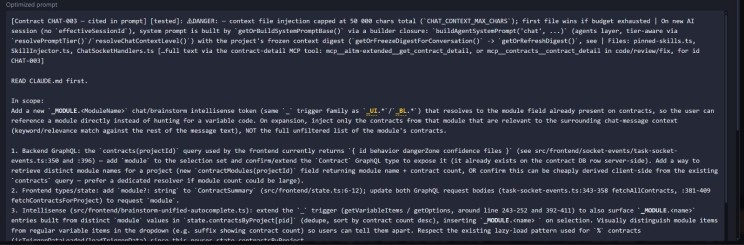
为什么这比单靠写好 prompt 更有效
上述实验中的方法(小任务 + 针对真实 diff 的 CheckPromptTask 验证)是有效的——但前提是每次都由人自己准备,并且记得去运行。AITM 把这一原则系统化、自动化地应用到每一个任务上:
契约取代"把规则粘贴进 prompt"。 用户不必在每个请求中重复输入数字格式、函数位置或业务规则,契约(例如 %PRICING-004)只需存储一次,带有精确的文件引用和行为描述。智能体不再按字面相似度猜测,而是在开始搜索之前就拿到精确的坐标。
docs 步骤在每个任务之后真正写出文档——而不是"如果 AI 认为重要的话"。编写/更新契约是强制的 pipeline 步骤,而不是可有可无的智能体记忆。
针对真实 diff 的验证是内置的,而不是手动的额外步骤。pipeline 中的 review 和 test 步骤会询问文件中实际发生了什么变化,与实验中 CheckPromptTask 的原理相同。
我自己在没有契约的情况下测试的结果是:同一请求运行十次,幻觉率为 20%。采用小任务 + 契约 + 针对 diff 验证的结构(这正是 pipeline 自动完成的工作)后,单个步骤上的幻觉率降到个位数百分比——不是因为模型不同,而是因为它不必猜任何东西,也没有人需要记住所有内容并每次都敲进 prompt。
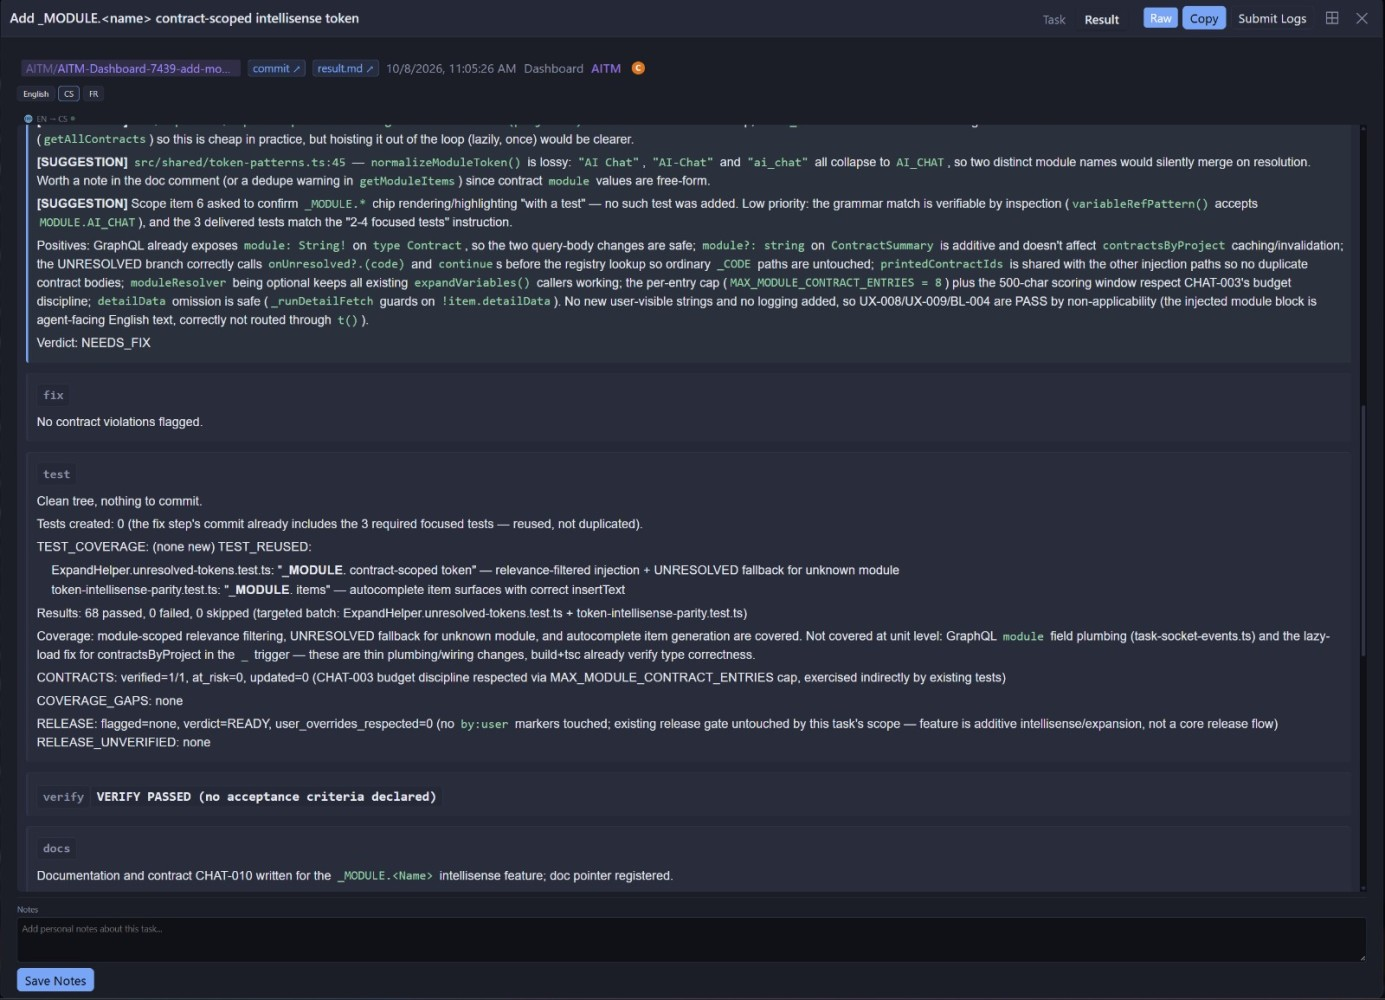
AITM 会优化 prompt,优化后的 prompt 产出任务的结果。然后我们对照任务的要求以及 AI 实际做了什么,来检查这个结果。