Wie kann es sein, dass die KI seelenruhig eine ganz andere Funktion repariert als die, die Sie gemeint haben, und völlig überzeugt ist, genau das getan zu haben, worum Sie gebeten haben? Die Antwort heißt Halluzination!
Bei Sprachmodellen bedeutet das: Das Modell erzeugt eine Antwort, die selbstsicher und logisch klingt, aber nicht der Realität oder der tatsächlichen Anfrage entspricht. Im Code nimmt das eine konkrete Form an: Die KI greift tendenziell zur nächstliegenden Option nach Wortähnlichkeit, auch wenn diese Option nicht der echten Anforderung entspricht.
Beispiel: Sie bitten um eine Korrektur der Funktion calculateDiscount(). Im Code gibt es aber auch calculateDiscountRate() und applyDiscount(). Das Modell kann, vor allem ohne präzisen Kontext, „annehmen“, Sie hätten die ähnlich benannte Funktion gemeint, und repariert die falsche Stelle. Das Ergebnis sieht fertig aus, Tests (falls es keine gibt) sagen nichts, und der Fehler taucht drei Schritte später auf.
Was Halluzination reduziert:
Ein exakter Verweis auf Datei und Zeile, nicht nur ein Funktionsname, der aus dem Gedächtnis abgerufen wird.
Fachlicher Kontext - wofür die Funktion da ist, nicht nur, was sie technisch tut.
Ein ausdrückliches Verbot, ähnlich benannte, aber andere Stellen anzufassen.
Kleinere, überprüfbare Schritte - eine Halluzination in einem kleinen Schritt wird schnell entdeckt; in einem riesigen Schritt geht sie verloren.
Genau hier stößt der übliche Ansatz „Prompt schreiben und hoffen“ an eine Grenze. Gebraucht wird ein System, das weiß, wo die Dinge sind, noch bevor Sie den KI-Agenten fragen, und genau das lösen Contracts, die wir ab nächster Woche behandeln.
Warum es nicht nur um ähnliche Funktionsnamen geht
Dasselbe Problem beschränkt sich nicht darauf, die falsche Funktion zu wählen, es betrifft auch das Finden von Informationen im Code selbst. Wenn dasselbe Thema (sagen wir „Rechnung“) gleichzeitig in mehreren Klassen, Methoden, Events und DOM-Elementen vorkommt, sucht die KI im Code nur so lange, bis sie auf den ersten Treffer stößt, der „Sinn ergibt“, und hört dort auf. Wenn die eigentliche Logik, die Sie korrigieren müssen, woanders liegt (sagen wir in einer separaten Klasse TemplateInvoice und nicht in der allgemeinen Rechnungsberechnung), öffnet das Modell sie nie. Es hat nicht zu wenige Dateien durchsucht, sondern vergleicht nur mit dem nächstliegenden Treffer zur Anfrage und macht nicht weiter.
Vorbereitete Dokumentation oder Skills helfen, die KI gelangt dann schneller und genauer an die richtige Information. Das Problem: Solche Dokumentation pflegt sich nicht selbst. Wenn sie nach einer Aufgabe niemand speichert oder die KI selbst entscheidet, eine Information sei „nicht wichtig“, bleibt sie ungespeichert. Der Agent speichert nur, was er aus dem gesamten Durchlauf für am wichtigsten hält, nicht alles. In größeren Projekten wird auch die Suche langsamer: Einzelne Teile der Geschäftslogik gehen nach und nach verloren, und wenn es mehrere Dokumente zum selben Thema gibt (etwa Rechnungen, die sowohl in einem Rechnungsdokument als auch in einem Vorlagendokument erwähnt werden), liest die KI oft nur das erste, das sie findet, hält es für eine ausreichende Quelle und öffnet die anderen nie.
Das hat eine praktische Konsequenz für Prompts: Wenn jede Anfrage den Zusatz „vergiss dies und das nicht, prüfe auch dort“ enthalten muss, ist es keine Programmierung mehr, sondern ständiges Erinnern. Das ist ein Signal, dass die Information ins System gehört (ein Skill, ein Contract) und nicht in den Kopf der Person, die sie jedes Mal in einen Prompt tippen muss.
Experiment: gleicher Prompt, gleiches Modell, anderes Ergebnis
Um die Hypothese zu prüfen, habe ich ein einfaches Experiment durchgeführt. In den Prompt schrieb ich: „Öffne und lies die Anweisungsdatei und befolge sie.“ Die Datei besagte: Wenn mit einer reellen Zahl gearbeitet wird, zeige sie im Frontend als Dezimalzahl im Format #.00 an und speichere sie mit derselben Formatierung im Log.
Anschließend stellte ich die Aufgabe, ein Formular mit zwei Feldern zu bauen: Alter (Ganzzahl) und Größe (reelle Zahl), dazu die üblichen Anforderungen (Farbe, Position, ein Speichern-Button, Speichern in der Datenbank). Ich führte denselben Prompt zehnmal aus, jedes Mal in einer sauberen Sitzung, ohne Gedächtnis zwischen den Durchläufen, mit demselben Modell.
Ergebnis: In 2 von 10 Durchläufen ignorierte das Modell die Anweisung zur Zahlenformatierung aus der referenzierten Datei. Gleicher Prompt, gleiche Bedingungen, gleiches Modell und trotzdem 20 % Halluzination. Auf die Frage nach dem Grund war die Antwort immer dieselbe: In diesem Moment hatte das Modell andere Teile der Anfrage für wichtiger gehalten und die Formatierungsanweisung „vergessen“.
Wie man Halluzination tatsächlich reduziert
Die KI ihre eigene Arbeit einfach prüfen zu lassen, reicht nicht. Die Prüfung selbst ist genauso anfällig für Halluzination wie die ursprüngliche Aufgabe. In der Praxis funktioniert es besser, die Arbeit in zwei Schritte zu teilen:
1. Eine kleine, explizit definierte Aufgabe. Es ist besser, den Inhalt der Regel direkt in den Prompt zu schreiben, statt nur auf eine Datei zu verweisen, die die KI „vielleicht vollständig liest oder auch nicht“.
PromptTask:
ein Formular
Eingabefelder, je nach Typ korrekt formatiert - int mit 0 Nachkommastellen, real mit 2 Nachkommastellen (das kann auch in einer Datei stehen, muss aber direkt im Prompt enthalten sein und nicht nur referenziert werden, damit die KI es nicht auf eigene Faust lesen muss),
reelle Werte mit 2 Nachkommastellen ins Log schreiben
in der Datenbank speichern.
2. Ein separater Verifikations-Prompt (*CheckPromptTask*), der erst nach Abschluss der ersten Aufgabe läuft und dieselbe nummerierte Struktur wie die Anfrage hat - wir fragen die KI genau das, was wir in PromptTask definiert haben:
CheckPromptTask:
wie wurde das Formular umgesetzt?
wie sind die Eingabefelder für int und real formatiert?
wie werden reelle Werte im Log gespeichert?
werden die Daten des Formulars tatsächlich in der Datenbank gespeichert?
Entscheidend ist, dass die KI diese Fragen anhand der tatsächlichen Änderung im Code (des Diffs, der Dateien) beantwortet, nicht aus ihrem eigenen Gedächtnis oder durch Raten — in diesem Schritt hat sie praktisch keinen Spielraum zum Halluzinieren, weil sie auf Basis dessen antwortet, was wirklich in der Datei steht.
Dann geht es nur noch darum, die Antworten des CheckPromptTask Punkt für Punkt mit den Anforderungen des PromptTask zu vergleichen (1↔1, 2↔2, 3↔3, 4↔4) — ob die Antwort zur Anfrage passt. Wenn etwas nicht übereinstimmt, wird die Ursache aufgespürt und die Korrektur gezielt vorgenommen — kein Neuanfang von null.
Mit diesem Ansatz sinkt die Halluzination auf niedrige einstellige Prozentwerte — keine glatte Null, aber weit unter den 20 % aus dem ersten Test. In Kombination mit Unit-Tests, Integrationstests und manuellen Tests lässt sich die Halluzination bei größeren und komplexeren Änderungen nahezu auf null drücken.
Konkreter Vergleich: gleiche Anfrage, zwei Ergebnisse
Anfrage: „Korrigiere den Rabatt, er wird nicht richtig berechnet.“
Gewöhnlicher KI-Chat: öffnet die Datei, die dem Namen am nächsten kommt - sagen wir calculateDiscountRate() statt calculateDiscount(), weil im Prompt nie stand, welche genaue Funktion gemeint ist. Er repariert diese, der Test (falls vorhanden) für die richtige Funktion zeigt weiterhin nichts, und der Produktionsfehler bleibt. Erst ein Kunde in der Produktion entdeckt, dass der Rabatt immer noch falsch ist.
AITM: Noch bevor der Task erstellt wird, ruft agent-chat contractsForVariable / searchDom auf und findet den Contract, der genau die Rabattlogik beschreibt - mit einem konkreten Feld files: ["src/pricing/DiscountService.ts"] und behavior: "calculateDiscount() applies the % discount after subtracting the coupon, not before it". Der Task-Prompt zitiert dann genau %PRICING-004, nicht einen generischen „Rabatt“, und der Architect-Schritt (Tag 17) öffnet nur diese eine Datei. Das Risiko, dass der Agent versehentlich calculateDiscountRate() anfasst, verschwindet praktisch. Nicht, weil das Modell klüger geworden wäre, sondern weil es nichts erraten muss.
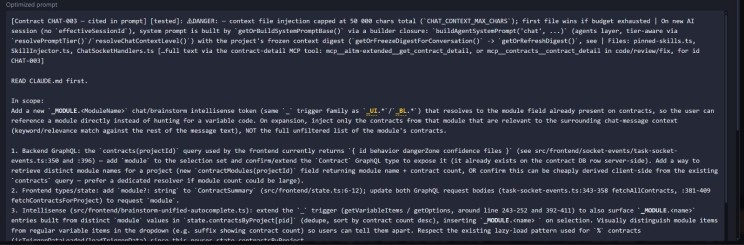
Warum das besser ist als ein gut geschriebener Prompt allein
Der Ansatz aus dem obigen Experiment (kleiner Task + Verifikation per CheckPromptTask gegen den echten Diff) funktioniert — aber nur, wenn ein Mensch ihn jedes Mal selbst vorbereitet und daran denkt, ihn auszuführen. AITM wendet genau dieses Prinzip systematisch und automatisch bei jedem Task an:
Contracts ersetzen „die Regel in den Prompt einfügen“. Statt dass der Benutzer Zahlenformatierung, Funktionsort oder eine Geschäftsregel in jede Anfrage neu eintippen muss, speichert ein Contract (z. B. %PRICING-004) sie einmal, mit exaktem Dateiverweis und einer Beschreibung des Verhaltens. Der Agent rät nicht nach Wortähnlichkeit, er erhält die exakte Koordinate, noch bevor er mit der Suche beginnt.
Der Docs-Schritt schreibt nach jedem Task tatsächlich Dokumentation - nicht „wenn die KI es für wichtig hält“. Das Schreiben/Aktualisieren eines Contracts ist ein verpflichtender Pipeline-Schritt, kein optionales Agentengedächtnis.
Die Verifikation gegen den echten Diff ist eingebaut, kein manueller Zusatzschritt. Die Review- und Test-Schritte in der Pipeline fragen, was sich in den Dateien tatsächlich geändert hat, nach demselben Prinzip wie der CheckPromptTask im Experiment.
Das Ergebnis meines eigenen Tests ohne Contracts waren 20 % Halluzination bei zehn Durchläufen derselben Anfrage. Mit der Struktur aus kleinem Task + Contract + Verifikation gegen den Diff (genau das, was die Pipeline automatisch tut) sinkt die Halluzination bei einem einzelnen Schritt auf einstellige Prozentwerte — nicht weil das Modell ein anderes ist, sondern weil es nichts erraten muss und niemand daran denken muss, alles jedes Mal in den Prompt zu tippen.
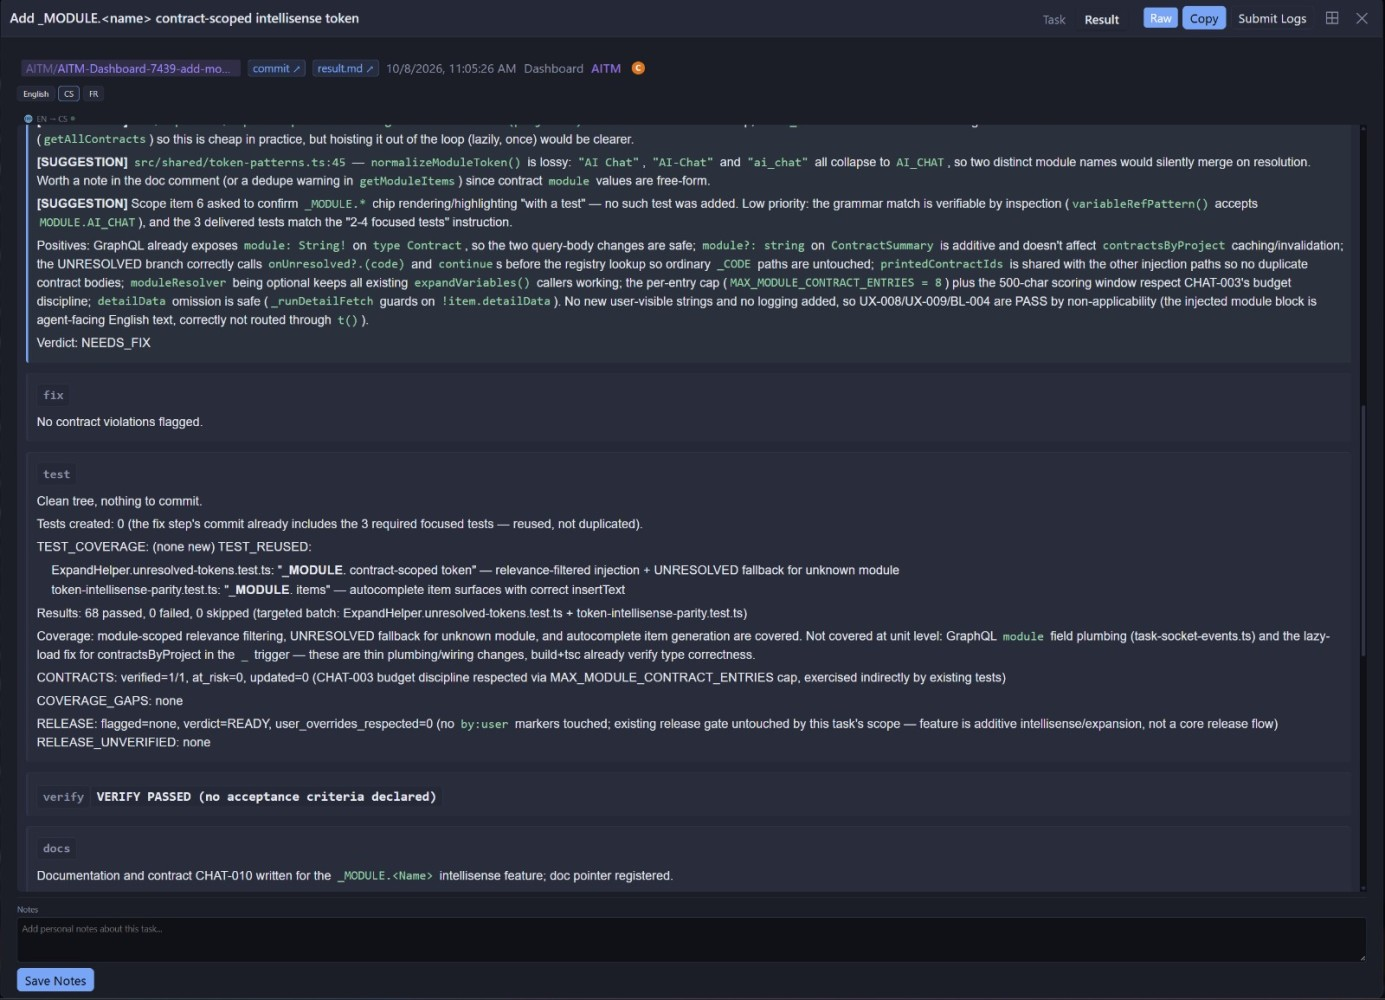
AITM optimiert den Prompt, und der optimierte Prompt liefert das Ergebnis des Tasks. Dieses Ergebnis prüfen wir anschließend dagegen, was der Task verlangt hat und was die KI tatsächlich getan hat.