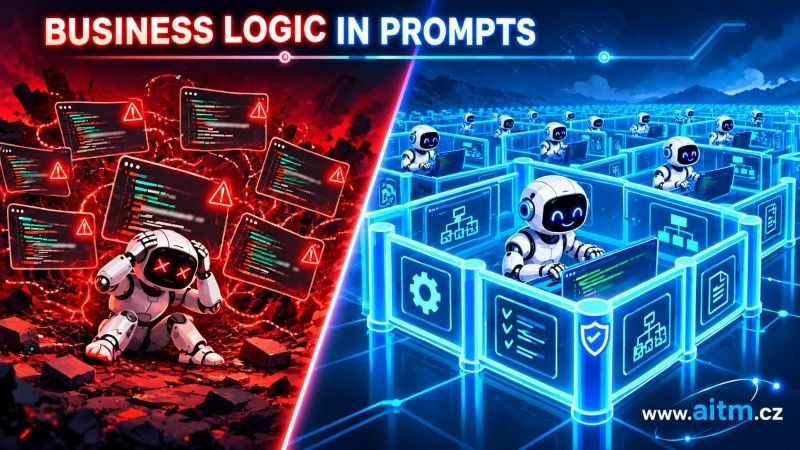
Die KI-gestützte Softwareentwicklung folgt heute oft einem einfachen Ablauf:
Eine Aufgabenbeschreibung (Prompt) schreiben.
Die KI eine Analyse und einen Lösungsvorschlag erstellen lassen.
Skills, Agenten und Subagenten vorbereiten.
Die Implementierung starten.
Die KI den Code schreiben, testen und erkannte Probleme beheben lassen.
Auf den ersten Blick sieht das nach einem idealen Entwicklungsworkflow aus. Die KI arbeitet autonom, verteilt Aufgaben auf Agenten, schreibt Tests und stellt Schritt für Schritt die gewünschte Funktionalität fertig.
Und bei kleineren Projekten kann dieser Ansatz hervorragend funktionieren.
Wenn Sie einen einfachen Onlineshop, eine fünfseitige Firmenwebsite oder ein schlichtes Verwaltungssystem bauen, kann die KI oft einen erheblichen Teil der Arbeit mit sehr guten Ergebnissen übernehmen.
Warum?
Weil Millionen von Entwicklern bereits ähnliche Software gebaut haben.
Stellen Sie sich zwei Onlineshops vor. Einer verkauft Spielzeug, der andere Äpfel.
Aus Sicht eines Kunden sind das zwei verschiedene Unternehmen. Aus Sicht der Softwarearchitektur funktionieren sie jedoch sehr ähnlich:
In Kategorien gegliederte Produkte.
Preisgestaltung und Bestandsverwaltung.
Warenkörbe.
Bestellabwicklung.
Zahlungsarten.
Kundenverwaltung.
Was sich ändert, sind vor allem die Daten, bestimmte Geschäftsregeln und einzelne Funktionen. Die grundlegenden Architekturprinzipien bleiben weitgehend dieselben.
Die KI erkennt diese Muster, weil sie beim Training ähnlichen Strukturen begegnet ist.
Das Problem beginnt, wenn Sie nicht mehr eine herkömmliche Anwendung bauen, sondern große Enterprise-Software entwickeln.
Was passiert, wenn ein System 300.000 bis 500.000 Codezeilen enthält?
Stellen Sie sich eine Enterprise-Anwendung mit Hunderttausenden Codezeilen, Dutzenden Modulen, Hunderten Abhängigkeiten und komplexen Geschäftsregeln vor.
Ein solches System ist möglicherweise über mehrere Jahre gewachsen. In dieser Zeit haben sich Architekturentscheidungen, Ausnahmen, historische Abhängigkeiten und Geschäftsregeln angesammelt.
Nicht alle davon sind dokumentiert.
Eine einzelne Methode kann zehn andere Module beeinflussen. Die Änderung eines Parameters kann Rechnungsstellung, Benutzerberechtigungen oder Bestellabwicklung stören.
Stellen Sie sich nun vor, Sie setzen einen KI-Agenten in dieser Umgebung ein.
Sie geben ihm die Aufgabe:
„Ändere den Zahlungsprozess so, dass eine zusätzliche Zahlungsart unterstützt wird. Erhalte die Abwärtskompatibilität und teste alles.“
Der Agent erstellt einen Plan, verteilt die Arbeit auf Subagenten, setzt die Änderungen um, führt Tests aus und liefert die Ergebnisse.
Alles kann korrekt aussehen.
Aber bestandene Tests bedeuten nicht zwangsläufig, dass die Software alle bestehenden Geschäftsregeln bewahrt hat.
Und das führt uns zu dem Problem, das meinen Umgang mit KI-Agenten vor sechs Monaten grundlegend verändert hat.
Das Experiment, das meine Sicht auf agentische Systeme verändert hat
Vor sechs Monaten habe ich ein Experiment durchgeführt, das mich dazu brachte, einen anderen Weg einzuschlagen, statt einfach immer mehr Agenten und Subagenten zu bauen.
Bis dahin hatte ich eine Annahme zugrunde gelegt, die viele Entwickler teilen:
Je besser ich Aufgaben auf spezialisierte Agenten verteile und je mehr Validierungsmechanismen ich einführe, desto verlässlicher wird das Ergebnis.
Doch bei meinen Experimenten stieß ich auf eine grundlegende Frage:
Wie kann ein Agent eine Geschäftsregel korrekt umsetzen, wenn er nicht einmal weiß, dass es diese Regel gibt?
Und wie kann ein anderer Agent das Ergebnis verlässlich prüfen, wenn auch ihm vollständige Informationen darüber fehlen, wie sich das System verhalten soll?
Ich begann zu untersuchen, wie Kontext zwischen Agenten übertragen wird.
Dabei stellte ich fest, dass die Art, wie Informationen weitergegeben und interpretiert werden, zu einer der schwächsten Stellen des gesamten Prozesses werden kann.
Wie arbeiten Agenten und Subagenten tatsächlich?
In der Praxis gibt es zwei gängige Ansätze für die Kommunikation zwischen KI-Agenten.
1. Hierarchisches Modell – Ein Hauptagent koordiniert Subagenten
Diese Architektur wird üblicherweise als Hub-and-Spoke oder Sterntopologie bezeichnet.
Das Prinzip ist einfach:
Der Benutzer übergibt dem Hauptagenten einen Task.
Der Hauptagent analysiert den Task und zerlegt ihn in kleinere Teile.
Er erstellt oder aktiviert Subagent A und gibt ihm Anweisungen.
Subagent A erledigt die Arbeit und liefert ein Ergebnis.
Der Hauptagent bewertet das Ergebnis und delegiert gegebenenfalls weitere Arbeit an Subagent B.
Sind alle Teile erledigt, führt der Hauptagent die Ergebnisse zusammen.
Subagent A weiß nicht unbedingt, was Subagent B tut. Kommunikation und Informationsaustausch werden über den Hauptagenten koordiniert.
Vorteil: Zentrale Steuerung, einfachere Zustandsverfolgung, klarere Verantwortlichkeit und ein geringeres Risiko unkontrollierter Kommunikation zwischen Agenten.
Nachteil: Der Hauptagent wird zum zentralen Punkt, über den Task-Anweisungen und Ergebnisse interpretiert werden. Lässt er beim Delegieren wichtige Informationen weg, arbeitet ein Subagent womöglich mit unvollständigem Kontext.
2. Peer-to-Peer – Agenten kommunizieren miteinander
Der zweite Ansatz sieht direkte oder fortlaufende Kommunikation zwischen Agenten vor, zum Beispiel über einen gemeinsamen Gesprächsfaden oder ein Nachrichtensystem (*Message Bus*).
Stellen Sie sich folgendes Szenario vor:
Agent A schreibt Code und veröffentlicht ein CodeWritten-Event.
Agent B, zuständig für das Testen, empfängt das Event und startet die Tests.
Agent C bereitet gleichzeitig die Dokumentation vor.
Die Agenten tauschen laufend Ergebnisse aus und reagieren auf Änderungen.
Vorteil: Parallele Ausführung von Aufgaben, schneller Informationsaustausch und geringere Abhängigkeit von einem einzelnen zentralen Agenten.
Nachteil: Aufwendigere Koordination, das Risiko, mit veralteten Informationen zu arbeiten, widersprüchliche Änderungen und eine schwierigere Ursachenforschung bei Fehlern.
Beide Ansätze können äußerst nützlich sein.
Aber keiner löst das grundlegende Problem für sich allein.
Ein Agent kann eine perfekt definierte Aufgabe haben, aber ohne Verständnis der tatsächlichen Geschäftslogik des Systems kann er eine technisch korrekte Lösung erzeugen, die fachlich falsch ist.
Wo entstehen Fehler in agentischen Workflows?
KI ist kein deterministischer Compiler, der Anweisungen direkt in Quellcode übersetzt. Ein Sprachmodell interpretiert die verfügbaren Informationen und erzeugt auf Basis dieses Kontexts Lösungen.
Fehlen Informationen, kann es falsche Annahmen treffen. Sind die verfügbaren Informationen unvollständig oder widersprüchlich, kann es einen ungeeigneten Ansatz wählen.
Betrachten wir einen typischen Workflow für eine größere Aufgabe.
Schritt 1 - Interpretation des Benutzer-Prompts
Der Hauptagent erhält den Task und versucht, die gewünschte Änderung zu verstehen.
In dieser Phase kann er eine Abhängigkeit übersehen, eine Einschränkung missverstehen oder etwas annehmen, das nie ausdrücklich gesagt wurde.
Schritt 2 - Erstellung von Anweisungen für einen Subagenten
Der Hauptagent erstellt eine konkretere Aufgabenbeschreibung. Er wählt aus dem ursprünglichen Prompt die Informationen aus, die er für relevant hält.
Kennt er jedoch bestimmte Geschäftsregeln nicht, kann er sie auch nicht korrekt weitergeben.
Schritt 3 - Implementierung
Der Subagent erhält seine Anweisungen, analysiert einen Teil der Codebasis und wählt eine Implementierungsstrategie.
Er kann syntaktisch korrekten, hochwertigen Code erzeugen und dabei unbeabsichtigt Verhalten ändern, das unverändert bleiben sollte.
Schritt 4 - Bewertung des Ergebnisses
Der Hauptagent erhält die Ausgabe des Subagenten, bewertet sie und entscheidet, ob der Task abgeschlossen ist.
Doch er kann noch immer unter denselben unvollständigen Annahmen wie zuvor arbeiten.
Schritt 5 - Testen und Fehlerbehebung
Es folgen Unit-Tests, Integrationstests, E2E-Tests, statische Analyse und Dokumentationsprüfungen.
Diese Mechanismen verbessern die Zuverlässigkeit von Software erheblich, haben aber Grenzen.
Ein Test prüft ein bestimmtes erwartetes Verhalten. Fehlt eine wichtige Geschäftsregel in der Testspezifikation, kann die Implementierung jeden Test bestehen und diese Regel dennoch verletzen.
Und wenn die KI ein Problem behebt, kann sie unbeabsichtigt einen anderen Teil des Systems beeinträchtigen.
So entsteht ein bekannter Kreislauf:
Implementierung → Test → Korrektur → Regression → weitere Tests → weitere Korrektur.
Allein die Zahl der Agenten zu erhöhen oder Tests häufiger zu wiederholen, garantiert daher nicht automatisch ein korrektes Ergebnis.
Warum können sich Fehler entlang einer Agentenkette anhäufen?
Betrachten wir ein vereinfachtes mathematisches Modell.
Nehmen wir an, wir haben drei aufeinanderfolgende Schritte, die jeweils mit einer hypothetischen Wahrscheinlichkeit von 95 % korrekt ausgeführt werden.
Sind diese Schritte unabhängig und müssen alle drei gelingen, ergibt sich folgende Wahrscheinlichkeit:
0.95 × 0.95 × 0.95 = 0.8574
Das entspricht einer Wahrscheinlichkeit von etwa 85,7 %, dass alle drei Schritte gelingen.
Bei zehn solchen unabhängigen Schritten wäre das Ergebnis:
0.95¹⁰ ≈ 59,9 %
Das ist eine anschauliche Rechnung, keine gemessene Erfolgsquote von KI-Agenten. In realen Systemen sind Fehler nicht immer unabhängig, Validierungsmechanismen können Fehler abfangen, und einzelne Schritte können frühere Fehlschläge korrigieren.
Das Beispiel zeigt jedoch ein wichtiges Prinzip:
Die Zuverlässigkeit einzelner Agenten garantiert nicht automatisch die Zuverlässigkeit der gesamten Kette.
Wenn unvollständige Anweisungen in jeder Phase erneut interpretiert werden, können zusätzliche Gelegenheiten für falsche Entscheidungen entstehen.
Deshalb glaube ich, dass es nicht genügt, einfach mehr Agenten, Tests und Validierungsmechanismen hinzuzufügen.
Wir müssen ändern, wie die KI Informationen über das System selbst erhält.
Der entscheidende Unterschied: Tests prüfen Ergebnisse, Geschäftslogik definiert Grenzen
Der herkömmliche Ansatz der KI-gestützten Entwicklung ist reaktiv.
Sie reichen eine Anforderung ein, die KI setzt eine Lösung um, und anschließend wird mit Tests geprüft, ob etwas kaputtgegangen ist.
Das ist sicherlich besser als überhaupt keine Tests.
Aber es bleibt eine grundlegende Schwäche:
Tests können Geschäftsregeln nicht verlässlich validieren, die niemand kennt und die nicht Teil der Testspezifikation sind.
Deshalb halte ich es für den besseren Ansatz, der KI vor Beginn der Implementierung Informationen über das tatsächliche Verhalten des Systems zu geben.
Nicht nur, was sich ändern muss, sondern auch:
Welche Geschäftsregeln für den betroffenen Code gelten.
Welche anderen Module von der Funktionalität abhängen.
Welche Ein- und Ausgaben kompatibel bleiben müssen.
Welche Szenarien unverändert bleiben müssen.
Welche Ausnahmen und historischen Einschränkungen existieren.
Welche Teile der Implementierung die KI ändern darf und welche sie bewahren muss.
Das reduziert erheblich die Menge an Verhalten, das die KI selbst erschließen muss.
Zwei Ansätze für dieselbe Aufgabe
Ansatz A - Prompt + Tests
Die KI erhält einen Task, wählt auf Basis des verfügbaren Kontexts eine Implementierung, erzeugt die Lösung und führt Tests aus.
Sind die Tests unvollständig, können Verletzungen bestehender Geschäftsregeln unentdeckt bleiben.
Ansatz B - Prompt + Geschäftslogik + Tests
Die KI erhält den Task zusammen mit den relevanten Regeln, Abhängigkeiten, Contracts und Einschränkungen.
Dadurch weiß sie, welches Verhalten bewahrt werden muss, bevor die Implementierung beginnt.
Tests erkennen dann nicht nur Fehler. Sie prüfen auch konkrete Business-Contracts.
Der Unterschied ist nicht, dass wir aufhören zu testen.
Der Unterschied ist, dass wir versuchen, Fehler zu verhindern, bevor sie entstehen.
Praxisbeispiel: Hinzufügen einer neuen Zahlungsart
Stellen Sie sich vor, wir haben eine Datei namens CheckoutService.ts, die in einer E-Commerce-Anwendung Zahlungen abwickelt.
Wir möchten Kartenzahlung als zusätzliche Zahlungsart hinzufügen.
Option A: Ein herkömmlicher Prompt
Task:
> Add card payments to CheckoutService.ts. Preserve existing functionality and run all tests.
Die KI ändert den Code, fügt einen neuen Zahlungszweig hinzu und aktualisiert die Tests.
Alle Tests bestehen.
Der Task wird als abgeschlossen markiert.
Das System enthält jedoch eine wichtige Geschäftsregel:
Firmenkonten müssen Banküberweisung als Standardzahlungsart verwenden.
Diese Regel wurde vor mehreren Jahren eingeführt. Der Entwickler, der sie umgesetzt hat, arbeitet nicht mehr im Unternehmen. Die Regel ist nicht klar dokumentiert, und es gibt keinen eigenen Regressionstest.
Die KI führt Kartenzahlung als Standardart für alle Kunden ein.
Aus Implementierungssicht funktioniert die neue Funktionalität korrekt.
Aus Sicht der Geschäftslogik ist das System kaputt.
Und die Tests haben das Problem nicht erkannt.
Option B: Ein strukturierter Task mit Geschäftslogik in AITM
Stellen Sie sich nun vor, die KI erhält dieselbe Anfrage, doch diesmal enthält der Task den relevanten Business-Contract, zugehörige Variablen, Links zu historischen Tasks und präzise Grenzen für erlaubte Änderungen.
Der Task könnte so aussehen:
READ CLAUDE.md first.

TASK:

Add card payment as an additional payment method

in CheckoutService.ts.

Contract:

%CHECKOUT-019 — "For company accounts
(companyId != null), bank transfer must remain
the default payment method. Card payment may
be offered only as an additional option."

Related variables:

BL.CHECKOUT.PAYMENTMETHOD_DEFAULT
BL.CHECKOUT.PAYMENTMETHOD_OPTIONS

Related task:

#<link to the task that originally implemented bank-transfer-as-default checkout>

In scope:

- Add a new "card" option to the available payment methods in CheckoutService.ts.

- Expose it as a selectable option in the existing payment method selection flow.

Out of scope:

- Changing the default payment method for any account type.

- Any UI/checkout-flow redesign beyond adding the new option.

- New payment provider integration logic beyond the method registration itself.

Must not break:

- Existing default payment selection logic (company accounts → bank transfer stays default).

- Company account checkout behavior end-to-end.

- Existing bank transfer processing path.

- Compatibility with the current payment API contract.

File path:

src/Services/CheckoutService.ts
Confirm the exact path via contractsForFile before editing.

Verify:

- Company account checkout still selects bank transfer by default
  (companyId != null).

- Card payment appears as a selectable, non-default option.

- Existing bank transfer processing is unchanged.

- Run unit and integration tests covering CheckoutService.
Weitere Informationen dazu, wie das in AITM funktioniert: https://aitm.cz/Docs/KnowledgeSharing
Warum ist dieses Format wichtig?
Auf den ersten Blick wirkt es wie nichts weiter als ein detaillierterer Prompt.
Der eigentliche Unterschied ist jedoch, dass der Task mit Informationen verbunden ist, die abgerufen und gegen das tatsächliche Projekt geprüft werden können.
1. Contract %CHECKOUT-019
Der Bezeichner %CHECKOUT-019 ist nicht bloß eine Textnotiz.
Es ist ein beispielhafter Contract-Bezeichner, den der Agent über GraphQL-Operationen wie contractsForFile oder contractsForVariable abrufen kann.
Statt sich allein auf die im Prompt notierte Regel zu verlassen, kann der Agent deren strukturierte Darstellung abrufen und gegen die aktuelle Codebasis prüfen.
2. Geschäftslogik-Variablen _BL.
Bezeichner wie _BL.CHECKOUT.PAYMENT_METHOD_DEFAULT und _BL.CHECKOUT.PAYMENT_METHOD_OPTIONS stehen für Geschäftslogik, ausgedrückt in der Kommunikationssprache von AITM.
Sie helfen, eine konkrete Anforderung mit den Regeln und Variablen zu verknüpfen, die das Systemverhalten bestimmen.
3. Verweis auf einen verwandten Task
Der Abschnitt Related task verweist auf den ursprünglichen Task, in dem die Geschäftsregel umgesetzt wurde.
Das gibt der KI zusätzlichen Kontext, nicht nur dazu, wie sich das System derzeit verhält, sondern auch dazu, warum eine bestimmte Entscheidung getroffen worden sein könnte.
4. Klar definierte Änderungsgrenzen
Die Abschnitte In scope, Out of scope und Must not break definieren drei getrennte Kategorien:
Was die KI umsetzen muss.
Was die KI nicht umsetzen darf.
Welches bestehende Verhalten die KI bewahren muss.
Statt einen offenen Task zu erhalten, den sie frei interpretieren oder erweitern kann, erhält die KI einen präzise definierten Umsetzungsumfang.
5. Verifikation vor dem Schreiben von Code
Der Dateipfad wird nicht automatisch als korrekt vorausgesetzt.
Der Agent ist angewiesen, zuerst contractsForFile zu verwenden, den tatsächlichen Pfad zu bestätigen und die zugehörigen Contracts zu ermitteln.
Erst danach soll er mit der Änderung des Codes beginnen.
6. Prompt-Validierung durch TPV
Ein wichtiger Bestandteil des AITM-Ansatzes ist der TPV-Prompt-Validator.
Er prüft die verpflichtenden Task-Abschnitte, bevor der Task zur Ausführung eingereicht wird.
Er verifiziert zum Beispiel das Vorhandensein von Umfangsdefinitionen, Einschränkungen, Contracts, Dateipfaden und Verifikationsanforderungen.
Dadurch verlagert sich ein Teil der Fehlervermeidung vom Testen fertigen Codes in die Vorbereitung des Tasks selbst.
Hinweis: Die Contract-Bezeichner und Geschäftslogik-Variablen in diesem Beispiel sind beispielhafte Platzhalter. In einem realen Projekt ruft der Optimizer sie per GraphQL aus dem jeweiligen Projekt ab. Sie sollten nicht ohne Verifikation erraten oder erzeugt werden.
Was ändert sich mit diesem Ansatz?
Beim herkömmlichen Ansatz interpretiert der Agent zunächst einen offenen Task und entscheidet selbst, welche Dateien, Abhängigkeiten und Geschäftsregeln wichtig sind.
Bei AITM ist der Task mit konkreten Contracts, Geschäftslogik-Variablen, historischen Tasks und klar definierten Änderungsgrenzen verbunden.
Der Agent kann daher Entscheidungen auf Grundlage überprüfbarer Informationen treffen, statt sich überwiegend auf Annahmen zu stützen.
Und genau darin sehe ich den grundlegenden Unterschied.
Geschäftslogik ist nicht mehr bloß Teil der Dokumentation. Sie wird Teil des Steuerungsprozesses der Implementierung selbst.
Das ist das Prinzip hinter AITM
Als wir begannen, AITM (AI Task Manager) zu entwerfen, wollten wir nicht bloß ein weiteres System bauen, das Agenten startet, Aufgaben verteilt und anschließend ihre Ergebnisse prüft.
Wir konzentrierten uns auf eine andere Frage:
Was wäre, wenn die KI relevante Geschäftslogik direkt aus dem vorhandenen Quellcode erhalten könnte, bevor sie irgendwelche Änderungen vornimmt?
Nicht nur Dokumentation, die jemand vor einem Jahr geschrieben hat.
Nicht nur allgemeine Anweisungen in einem Skill.
Und nicht nur ein paar Dateien, die ein Agent zufällig auswählt.
Sondern strukturierte Informationen darüber, wie sich der betroffene Teil des Systems tatsächlich verhält, welche Contracts ihn steuern und welche anderen Komponenten von ihm abhängen.
Das Kernprinzip von AITM besteht daher darin, den Arbeits-Prompt mit Geschäftslogik anzureichern, die aus den relevanten Teilen der Codebasis ermittelt wurde.
Der Agent erhält nicht nur Informationen darüber, was er tun muss, sondern auch darüber, was er bewahren muss.
Das ist besonders wichtig in großen Softwaresystemen, in denen ein einzelner Prompt möglicherweise nicht jede relevante Abhängigkeit oder Einschränkung enthält.
Geschäftslogik als Leitplanken für die KI
Stellen Sie sich Geschäftslogik wie Leitplanken am Straßenrand vor.
Ohne Leitplanken kann die KI viele verschiedene Wege einschlagen. Manche führen zu einer korrekten Lösung, andere verletzen verborgene Regeln im System.
Indem wir relevante Contracts und Einschränkungen bereitstellen, verengen wir den Spielraum für unerwünschte Entscheidungen erheblich.
Die KI kann weiterhin selbstständig Implementierungsstrategien, Algorithmen und Codestrukturen wählen.
Aber sie muss die bekannten Geschäftsregeln respektieren.
Die anschließenden Tests prüfen dann, ob diese Regeln tatsächlich bewahrt wurden.
Das ist ein grundlegender Wandel der Philosophie.
Wir versuchen nicht bloß, Fehler zu beheben, die die KI verursacht. Wir versuchen, die Wahrscheinlichkeit zu senken, dass diese Fehler überhaupt entstehen.
Heißt das, wir brauchen keine Agenten und Tests mehr?
Auf keinen Fall.
Agenten sind nützlich für parallele Ausführung, spezialisierte Tätigkeiten und die Automatisierung großer Aufgaben.
Unit-Tests, Integrationstests und E2E-Tests bleiben unverzichtbare Bestandteile der Softwarequalitätssicherung.
Aber Agenten-Orchestrierung und automatisierte Tests können das Wissen über Geschäftslogik nicht ersetzen.
Wenn ein Agent nicht versteht, was das System bewahren muss, löst auch ein perfekt organisiertes Team von Subagenten das zugrunde liegende Problem nicht.
Und wenn Tests die relevanten Szenarien nicht abdecken, kann jeder Test bestehen, während sich die Anwendung fachlich dennoch falsch verhält.
Der richtige Ansatz ist nicht, zwischen Geschäftslogik und Tests zu wählen. Es ist, sie zu kombinieren.
Zuerst das tatsächliche Verhalten des Systems ermitteln.
Dann dieses Verhalten als klare Regeln und Contracts ausdrücken.
Anschließend diese Regeln zusammen mit dem Task an die KI übergeben.
Erst dann mit Implementierung, Validierung und Tests fortfahren.
Dieser Ansatz kann unnötige Korrekturen, Regressionen und wiederholte Implementierungszyklen reduzieren.
Fazit: Es kommt nicht auf die Zahl der Agenten an. Es kommt auf die Qualität der Informationen an.
Bei einfachen Anwendungen kann die KI selbst mit relativ kurzen Anweisungen hervorragende Ergebnisse liefern.
Bei Enterprise-Software mit einer halben Million Codezeilen genügt es jedoch nicht anzunehmen, dass ein Agent alles richtig versteht, jede Abhängigkeit entdeckt und seine eigene Arbeit dann fehlerfrei testet.
Je größer das System wird, desto wichtiger ist es, sein tatsächliches fachliches Verhalten zu verstehen und zu schützen.
Sie können zehn Agenten haben, die perfekt zusammenarbeiten. Doch wenn keiner von ihnen eine entscheidende Geschäftsregel kennt, können sie gemeinsam eine perfekt getestete Lösung erzeugen, die im Kern falsch ist.
Deshalb gehen wir bei AITM einen anderen Weg.
Zuerst Kontext, Regeln und Contracts.
Dann die Implementierung.
Und zuletzt Validierung und Tests.
Denn das Ziel ist nicht, dass die KI in kürzester Zeit möglichst viel Code schreibt.
Das Ziel ist, dass die KI genau das ändert, was geändert werden muss, ohne zu zerstören, was bereits funktioniert.