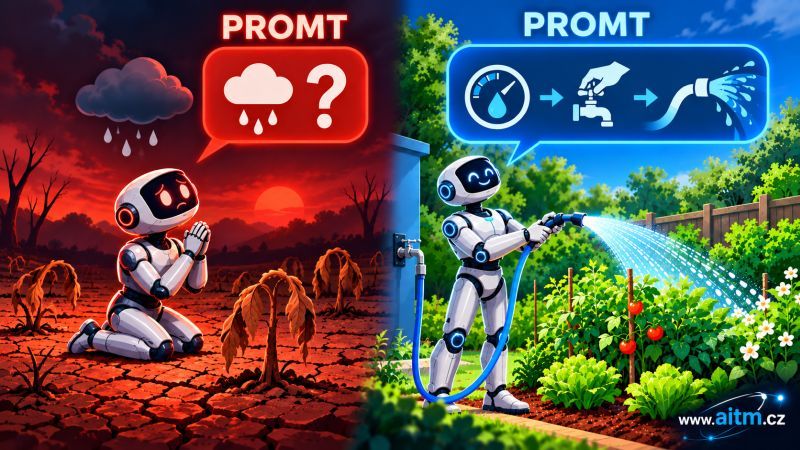
Dva lidé zadají AI agentovi na pohled stejný požadavek — a dostanou dvě úplně jiné kvality výsledku. Čím se ta zadání liší a jak to poznáte předem, než AI vůbec začne pracovat? Odpověď je jednoduché pravidlo: čím lépe a detailněji popíšete požadavek, tím lépe ho AI provede. Zní to banálně, ale v praxi je to nejčastější příčina špatných výsledků — ne nedostatečná schopnost modelu, ale nedostatečně popsaný požadavek.
Špatný prompt: "Oprav chybu v přihlašování."
Dobrý prompt: "V AuthService.login() dochází k chybě, když uživatel zadá e-mail s velkými písmeny — porovnání s DB je case-sensitive. Oprav normalizaci e-mailu PŘED porovnáním, nezasahuj do hashování hesla ani do rate-limitu v LoginThrottle.ts."
Druhý prompt obsahuje čtyři klíčové věci, které první postrádá:
- Přesné místo (soubor/funkce), ne obecný popis.
- Popis root cause, ne jen symptom.
- Co přesně udělat, ne jen "oprav to".
- Co se nesmí rozbít — explicitní hranice zásahu.
Bez bodu 4 má AI tendenci "vylepšovat" i to, co jste nechtěli měnit — a to je přesně ten moment, kdy se rozbije navazující logika.
Je to podobné, jako když se snažíte pětiletému dítěti vysvětlit, co má udělat. Řeknete mu co a jak, ale stejně důležité je i to, co nemá dělat. U dítěte je takový zákaz spíš výchovný; u AI je to přesná definice toho, co nemá prozkoumávat ani upravovat — a taková hranice zpřesní výsledek daleko víc než sebelepší popis toho, co se má hledat.
Stejná logika platí i uvnitř jednoho promptu: když do něj napěchujete víc nesouvisejících požadavků najednou, AI neví, který z nich má prioritu, a často si zadání vyloží jinak, než jste zamýšleli. Proto platí jednoduché pravidlo: jeden prompt = jedna konkrétní, specifická věc.
Platí to stejně pro ručně psané prompty jako pro automaticky generované tasky. A právě tuhle disciplínu lze zautomatizovat — tak, aby prompt nevznikal z toho, co si člověk zrovna pamatuje, ale z reálné, aktuální znalosti kódu (kontrakty, DOM mapa, business logika), kterou AITM udržuje za něj.
Ještě než se podíváme na strukturu promptu samotnou, je dobré vědět jednu věc: AITM nepíše každý task prompt stejně. Při vytvoření si task nejdřív sám (nebo podle vaší volby) zařadí do jedné ze tří kategorií — bug (oprava existujícího chování), enhancement (vylepšení toho, co už existuje) nebo feature (zcela nová funkcionalita) — a podle toho vznikne jiná skladba požadavků i jiná kritéria ověření. Teď se soustředíme na to, co mají všechny tři typy společné: pevnou strukturu z 5 bloků.
Jak to dělá AITM — reálná struktura promptu
AITM nepíše task prompty volnou formou. Každý task prompt, který vznikne z chatu nebo brainstormingu, se skládá z 5 pevných bloků, v tomto pořadí — a každý blok řeší jeden konkrétní problém, který by jinak vedl k nejasnému zadání:
- Role — max 3 věty o tom, jakou roli a jak konzervativní přístup má agent zaujmout. Bez tohohle bloku agent neví, jak moc smí být "kreativní" — a kreativita bez mantinelů je přesně to, co vede k nechtěným zásahům.
- Context — proč task vznikl: hlášení uživatele, historie problému, kdo danou oblast vlastní. Je oddělen větou "Context (background only — implement nothing from this block)", protože bez téhle věty hrozí, že agent omylem začne implementovat něco z pozadí příběhu, místo aby se soustředil jen na zadání.
- Requirements — jeden číslovaný blok na každý požadavek, a u každého přesné, ověřitelné kritérium. Rozdělení do číslovaných bloků řeší přesně to, o čem byla řeč výš — jeden blok, jedna konkrétní věc, žádné směšování víc požadavků do jedné věty.
- Scope — tři řádky: In scope (co se smí měnit), Out of scope (co se nesmí měnit a kdo to vlastní), Must not break (které kontrakty nesmí přestat platit). Tohle je přímá implementace pravidla "řekni AI i co nemá dělat" — bez tohoto bloku agent neví, kde jsou hranice jeho zásahu.
- Output a ověření — každý nový soubor, který task vytvoří, a konkrétní verify příkazy omezené jen na to, co tahle konkrétní změna může rozbít. Tím se task neuzavírá na "vypadá to hotové", ale na měřitelné "prošel přesně tenhle příkaz".
Všimněte si odkazů na kontrakt jako %AUTH-012 — to je odkaz na konkrétní kontrakt, vložený přesně danou syntaxí, kterou AITM pozná a automaticky expanduje na plný popis chování. Tohle je přesně ten rozdíl mezi "napište si prompt sami" a systémem, který vám přesnou strukturu i citace vynutí.
Co takový kontrakt reálně obsahuje. V AITM je kontrakt záznam v projektové SQLite databázi, ne komentář v kódu. Má krátké ID, modul a hlavně behavior — několikavětý přesný popis mechanismu, často s odkazem na konkrétní řádky souboru a na číslo tasku, kde chování vzniklo. K tomu patří seznam souborů, kterých se kontrakt týká, případně danger zone a seznam variables, ke kterým se váže. Když agent v promptu uvidí odkaz "Must not break", AITM mu místo holého kódu vloží celý tenhle popis — agent tak přesně ví, jaké chování nesmí porušit.
A unit testy? Ty svůj kód mají taky — každý testovací blok v AITM testech nese na začátku popisu unikátní značku. Díky tomu se dá konkrétní test adresovat stejně přesně jako kontrakt. Kontrakt si navíc k sobě páruje i cestu k testovacímu souboru, takže odkaz na kontrakt nakonec nese nejen popis chování, ale i přímou vazbu na test, který ho hlídá.